Le « cercle vertueux des données de l'IA en entrepôt » (data flywheel) est apparu avec une fréquence croissante dans les cercles de la supply chain : plus un système d'IA d'entrepôt est utilisé, plus il collecte de données et plus ses modèles deviennent précis ; plus ils sont précis, plus on s'y appuie ; et cette confiance accrue renvoie encore plus de données dans la boucle. Mais d'après mon suivi des déploiements d'IA en entrepôt, ce cercle ne tourne pas du tout avec la fluidité que la légende suggère : il existe réellement dans certains scénarios, et dans d'autres il s'apparente plutôt à une vision. Pour bien le comprendre, regardons d'abord les données, et ensuite seulement l'attribution.
Où le cercle vertueux des données tourne vraiment en entrepôt
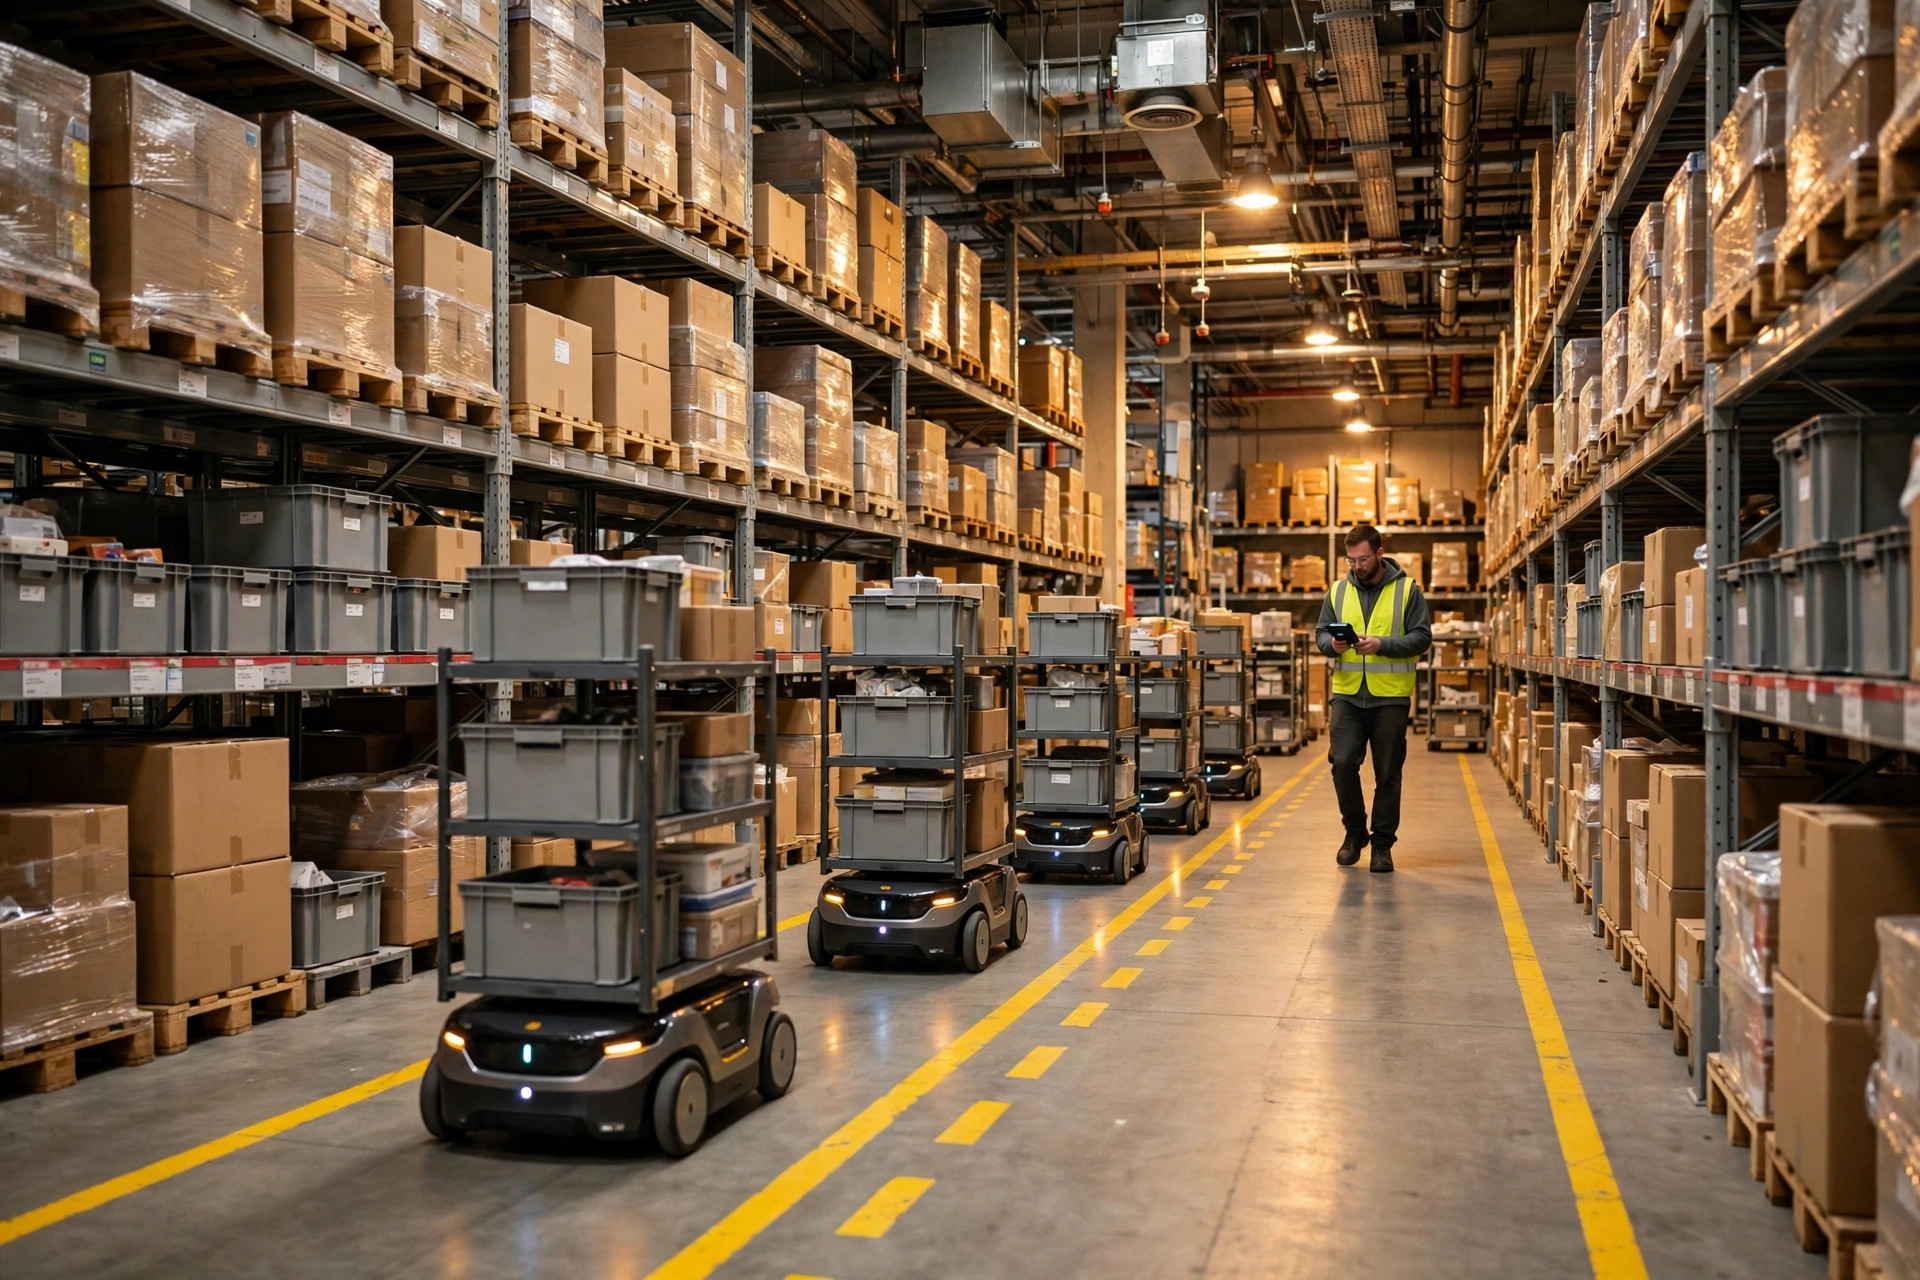
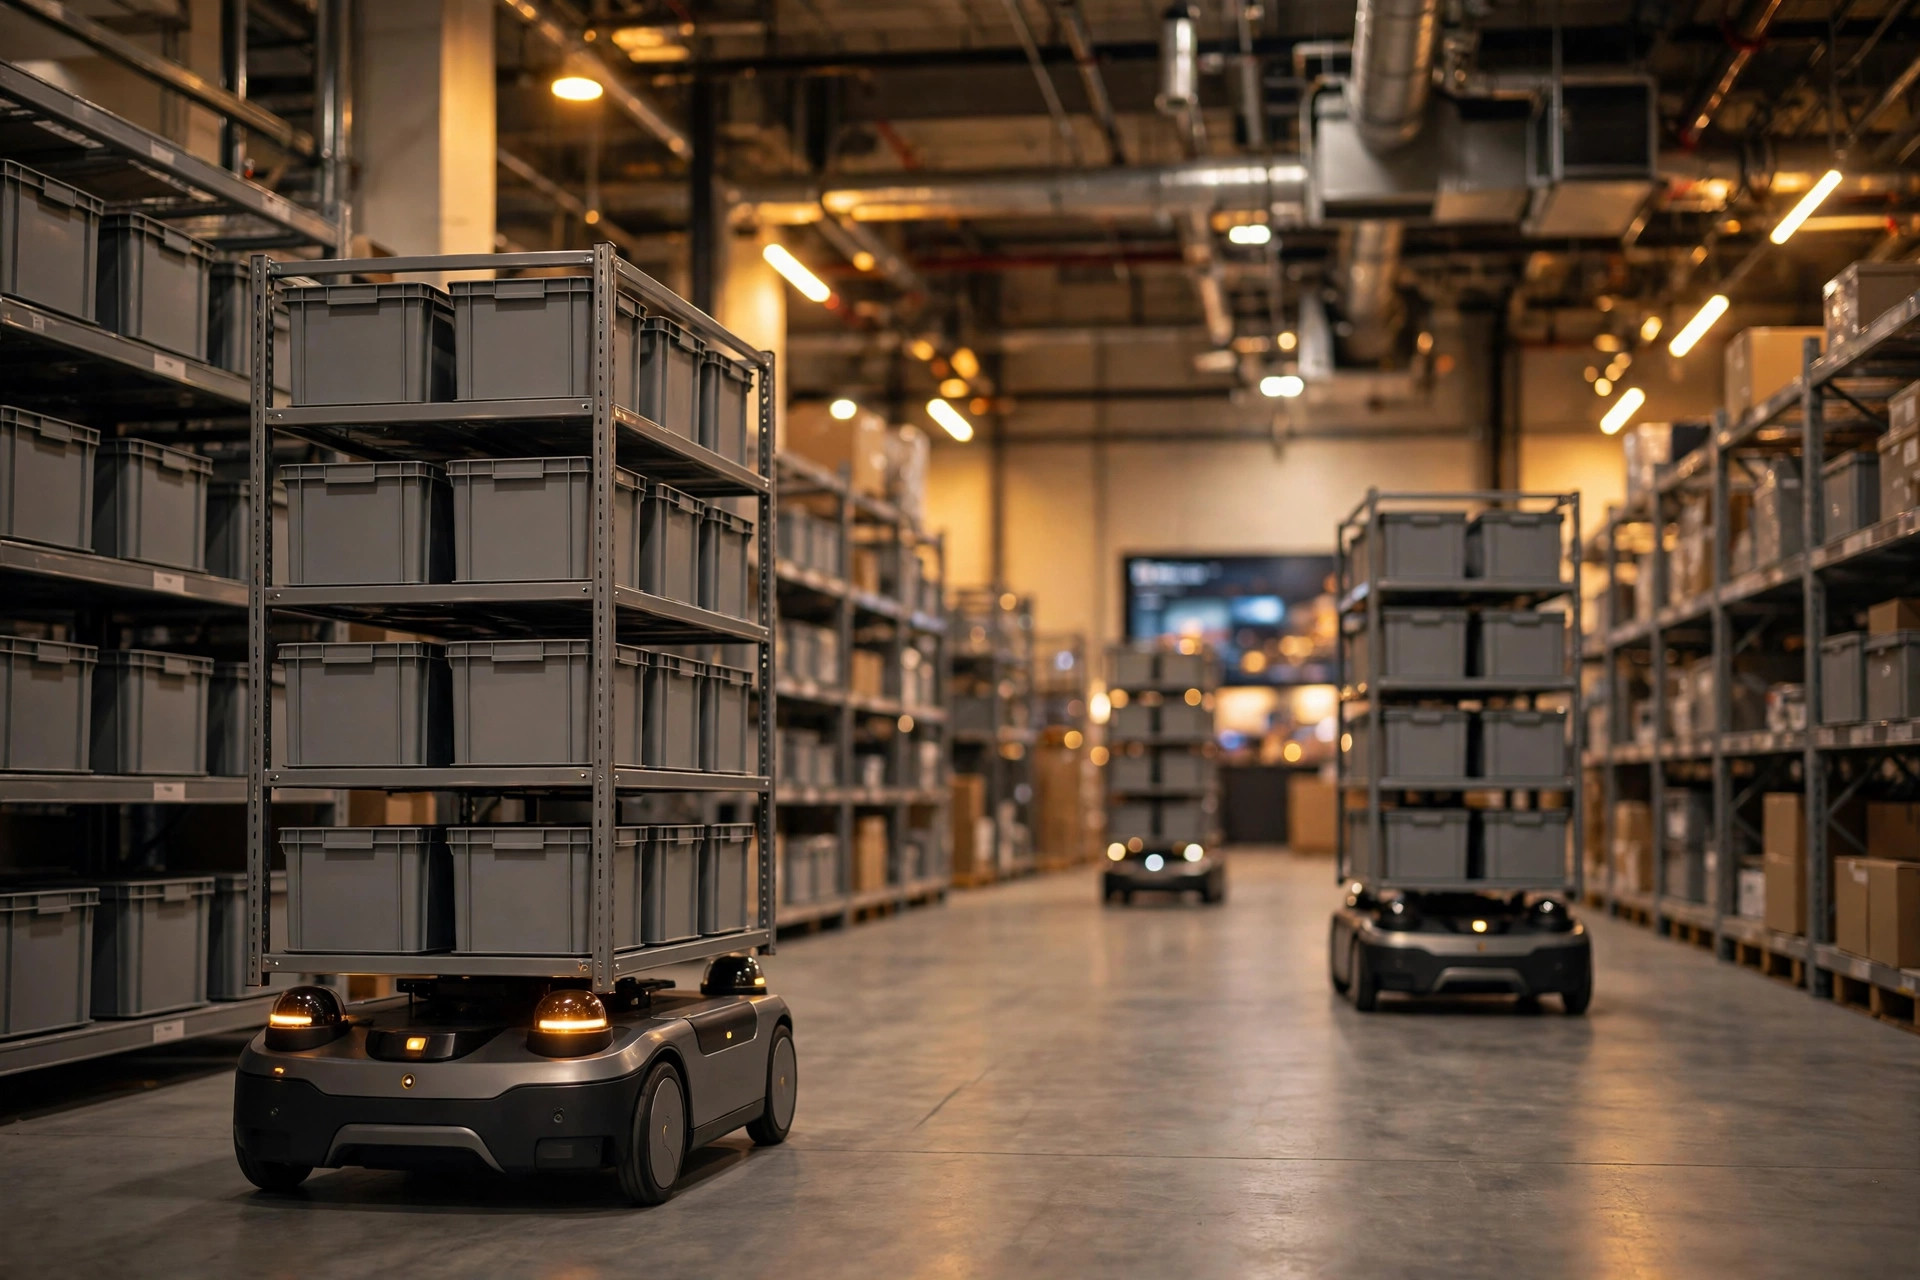
En entrepôt, le cercle vertueux des données n'est pas un slogan — il prend trois formes concrètes et vérifiables. Premièrement, la prévision de la demande et le réapprovisionnement : les commandes historiques et le stock alimentent le modèle, le modèle produit des prévisions au niveau SKU, les prévisions guident le réapprovisionnement et le slotting, et les ventes réelles deviennent de nouvelles données d'entraînement. Deuxièmement, l'inspection par vision : contrôles d'entrée, détection d'avaries, recomptages — chaque contrôle manuel fait aussi office d'annotation gratuite. Troisièmement, l'allocation des tâches aux robots : chaque déplacement d'un AMR enregistre un temps de parcours, chaque prise enregistre un succès ou un échec — des données qui naissent déjà étiquetées, sans traitement secondaire.
Pour observer la véritable vitesse de rotation d'un cercle, il faut une chronologie suffisamment longue, et le réseau de robotique d'entrepôt d'Amazon est le meilleur échantillon public : Kiva Systems acquis en 2012, robots goods-to-person à grande échelle ; le bras Sparrow dévoilé en 2022, censé traiter environ 65 % des produits de son inventaire ; plus de 750 000 robots mobiles annoncés en 2024. Douze ans — chaque picking, chaque prise, chaque échec est devenu une donnée d'entraînement incrémentale.
L'évolution de Sparrow illustre le mécanisme : les premiers bras ne manipulaient que des articles de forme régulière à des positions fixes ; à mesure que les données de prise s'accumulaient, les taux de réussite sur les articles irréguliers et en emballage souple se sont améliorés, permettant à Amazon de le déployer sur davantage de catégories — frontière de capacité → incrément de données → frontière de capacité. L'enjeu n'est pas la sophistication algorithmique — les frameworks de planification de prise sont depuis longtemps publics dans le monde académique — mais le fait qu'Amazon détient des données de prise avec de vraies étiquettes d'échec que personne d'autre ne peut obtenir.
Un deuxième échantillon est la prévision de la demande. Entre fin 2024 et début 2025, j'ai étudié deux grands centres de fulfillment e-commerce — l'un dans l'est de la Chine, l'autre dans le sud de la Chine — traitant chacun entre 80 000 et 120 000 commandes par jour, et exécutant tous deux depuis environ 2023 des prévisions de ventes au niveau SKU par ML. Un an après le lancement, les taux de rupture de stock des deux étaient passés d'environ 6 % à environ 4 %, et la durée de séjour du stock à faible rotation s'était raccourcie d'environ 20 %. Les deux responsables supply chain ont dit à peu près la même chose : « Au lancement, le modèle était moins bon que l'intuition de nos planificateurs ; ce n'est qu'après six mois d'accumulation de données qu'il a pris l'avantage. » Le premier demi-tour du cercle fonctionne à perte — le point que les retardataires sous-estiment le plus souvent.
Pourquoi les pionniers tournent plus vite
L'attribution se résume à trois mécanismes. Premièrement, l'effet composé des actifs étiquetés : en entrepôt, les actions métier sont en elles-mêmes des annotations — un contrôle manuel, une exception traitée, un écart d'inventaire, chacun porte sa propre étiquette. Les pionniers sont entrés en production plus tôt, donc ces « annotations gratuites » ont commencé à se composer plus tôt. Un retardataire peut acheter le même algorithme, mais ne peut pas acheter ces années d'actifs étiquetés. Deuxièmement, la vitesse de la boucle de rétroaction : la vitesse de rotation n'est pas déterminée par le volume de données, mais par le temps que prend un cycle complet — données → modèle → décision → nouvelles données. Dans le réseau de fulfillment d'Amazon, ce cycle se mesure en heures ; en prévision de la demande, en jours. Plus le cycle est court, plus l'avance du pionnier se creuse vite. Troisièmement, l'étendue de la couverture de la longue traîne : comment saisir des articles irréguliers, comment découper les vagues de commandes en haute saison, comment traiter les exceptions. Un modèle entraîné par un retardataire sur des jeux de données publics performe de manière comparable en scénarios standards, mais l'écart s'ouvre immédiatement dans la longue traîne — et l'entrepôt regorge de scénarios de longue traîne.
La vérité qui dérange : les cercles ne tournent pas tout seuls
Jusqu'ici, cela ressemble à une histoire destinée à appartenir aux pionniers. Mais d'abord trois jugements contre-intuitifs — ce sont eux qui déterminent si le cercle tourne du tout.
Premièrement, le cercle a un seuil de démarrage à froid, et il n'est pas bas. « Plus on l'utilise, plus il devient précis » n'est vrai que si le système est déjà assez précis pour que les gens veuillent l'utiliser. Si la précision initiale est en deçà de la performance humaine, l'exploitation le contournera et le flux de données s'assèchera. Les deux entrepôts ci-dessus ont survécu à leurs six premiers mois non grâce à la technologie, mais grâce à un mandat de la direction : la sortie de la prévision doit piloter le réapprovisionnement. Sans une boucle fermée imposée par l'organisation, le premier tour ne se produit jamais. Beaucoup de projets d'IA en entrepôt meurent précisément ici : les données existent, le modèle existe, mais le processus ne réserve aucune position par laquelle le modèle « doit passer ».
Deuxièmement, les données se déprécient. Les données d'entrepôt ont un ennemi caché : le glissement de distribution (distribution shift). Une refonte majeure du mix SKU, une relocalisation, un passage de produits standards à non standards — et les anciennes données décroissent rapidement. Un modèle de vision entraîné pendant trois ans sur le textile peut perdre la moitié de sa précision du jour au lendemain dans un entrepôt de pièces automobiles. Un fossé de données a une durée de vie fixée par la stabilité du scénario : plus le scénario est stable, plus le fossé est profond ; plus les choses changent vite, plus il s'évapore vite.
Troisièmement, le cercle amplifie le biais initial : mauvaise qualité d'annotation initiale ou règles d'étiquetage systématiquement biaisées, et plus il tourne vite, plus le biais s'amplifie vite. J'ai un jour vu un projet de détection d'anomalies de tri où l'« emballage légèrement froissé » avait été massivement étiqueté « avarié » au début ; après le lancement, le modèle est devenu toujours plus strict, le taux de fausses interceptions n'a cessé de grimper, et l'exploitation a fini par couper l'interception automatique. Un cercle n'a pas de sens de l'orientation — il ne fait qu'accélérer.
Ces trois jugements forment un cadre pour juger si un scénario vaut la peine de parier sur le cercle :
| Dimension | Scénario favorable au cercle | Scénario hostile au cercle |
|---|---|---|
| Densité de données | Actions répétitives à haute fréquence, p. ex. picking | Actions de longue traîne à basse fréquence, p. ex. inventaires tournants |
| Vitesse de la boucle de rétroaction | Vérifiable en minutes ou heures, p. ex. succès de prise | Résultats connus seulement après des mois, p. ex. tendances de demande |
| Coût d'étiquetage | Produit naturellement par le processus, p. ex. contrôles manuels | Nécessite des annotateurs dédiés hors ligne |
| Stabilité du scénario | SKU et processus stables à long terme | Changements fréquents d'assortiment et de relocalisations |
| Échelle initiale des données | Années de données historiques accumulées | Démarrage à froid depuis zéro |
Si un scénario tombe dans la colonne de droite sur trois ou plus de ces cinq dimensions, « plus on l'utilise, plus il devient précis » est très probablement juste une vision — réglez le démarrage à froid et la conception de la boucle fermée avant d'investir.
Trois voies de rattrapage pour les retardataires
Le fossé du pionnier ne signifie pas que les retardataires n'ont pas de voie. Je vois trois voies viables. Premièrement, modèles pré-entraînés plus fine-tuning léger. Les grands modèles de vision changent la donne : la détection d'avaries qui exigeait autrefois des centaines de milliers d'images étiquetées peut désormais atteindre une précision utilisable avec un fine-tuning sur quelques milliers d'images issues du propre entrepôt de l'opérateur. Mais cela aide peu la prévision de la demande, qui a besoin de la profondeur de l'historique propre au site. Deuxièmement, les alliances de données. Un entrepôt de taille moyenne seul ne peut pas faire vivre un cercle, mais des dizaines mutualisant des données d'exploitation désidentifiées peuvent constituer un jeu d'entraînement significatif. Certains 3PL européens expérimentent déjà ainsi : les données ne quittent jamais les systèmes de chaque entreprise ; seuls les gradients du modèle ou des caractéristiques désidentifiées sont partagés. La difficulté n'est pas technique mais de confiance et de partage des bénéfices. C'est un problème de business, pas un problème d'IA. Troisièmement, la compétition asymétrique : choisir des scénarios où les cercles ne peuvent pas tourner. Entrepôts de produits non standards, entrepôts desservant la fabrication sur mesure, entrepôts de fast fashion à forte rotation — les données s'y déprécient si vite que l'avantage historique des pionniers s'évapore largement. Les retardataires qui commencent ici partent de la même ligne de départ. Un fossé n'existe que là où un fossé peut être creusé.
Une chronologie pour les trois à cinq prochaines années
Mes jugements ci-dessous reposent sur la pente historique des courbes de capacité des modèles, le coût décroissant de l'annotation et le rythme de pénétration de l'automatisation des entrepôts ces cinq dernières années — des jugements falsifiables, horodatés, que vous pourrez revisiter dans quelques années.
De 2026 à 2028 : les modèles pré-entraînés pour l'IA de vision en entrepôt deviennent un équipement standard ; les opérateurs de taille moyenne achètent de l'inspection par vision « quatre-vingts points » à coût modéré, et l'avantage du pionnier ici se dilue visiblement. Pendant ce temps, l'avantage en prévision de la demande continue de se creuser — il est décidé par la profondeur accumulée pendant des années dans les données propres du site, où les modèles pré-entraînés ne peuvent pas aider.
De 2028 à 2030 : des alliances de données régionales ou par catégorie émergent, et les 3PL leaders commencent à échanger « données contre services d'algorithmes ». Les algorithmes continuent de se commoditiser, et la prime monte pour les équipes « ingénierie de données plus opérations en boucle fermée » — les gens qui vaudront la peine d'être payés ne seront plus ceux qui savent régler des modèles, mais ceux qui savent faire tourner le cercle.
Je terminerai par une question ouverte : si les données sont vraiment le fossé, son eau appartient-elle à celui qui l'a creusé, ou à chaque parcelle de terre qu'elle traverse ? À mesure que les alliances de données et la régulation entrent en jeu, combien vaudront encore dans cinq ans les cartes des pionniers d'aujourd'hui ? Il n'existe pas de réponse standard — mais qui parie sur l'IA en entrepôt devrait d'abord avoir résolu la sienne.
Par Dr. Chen, chercheur en supply chain
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.