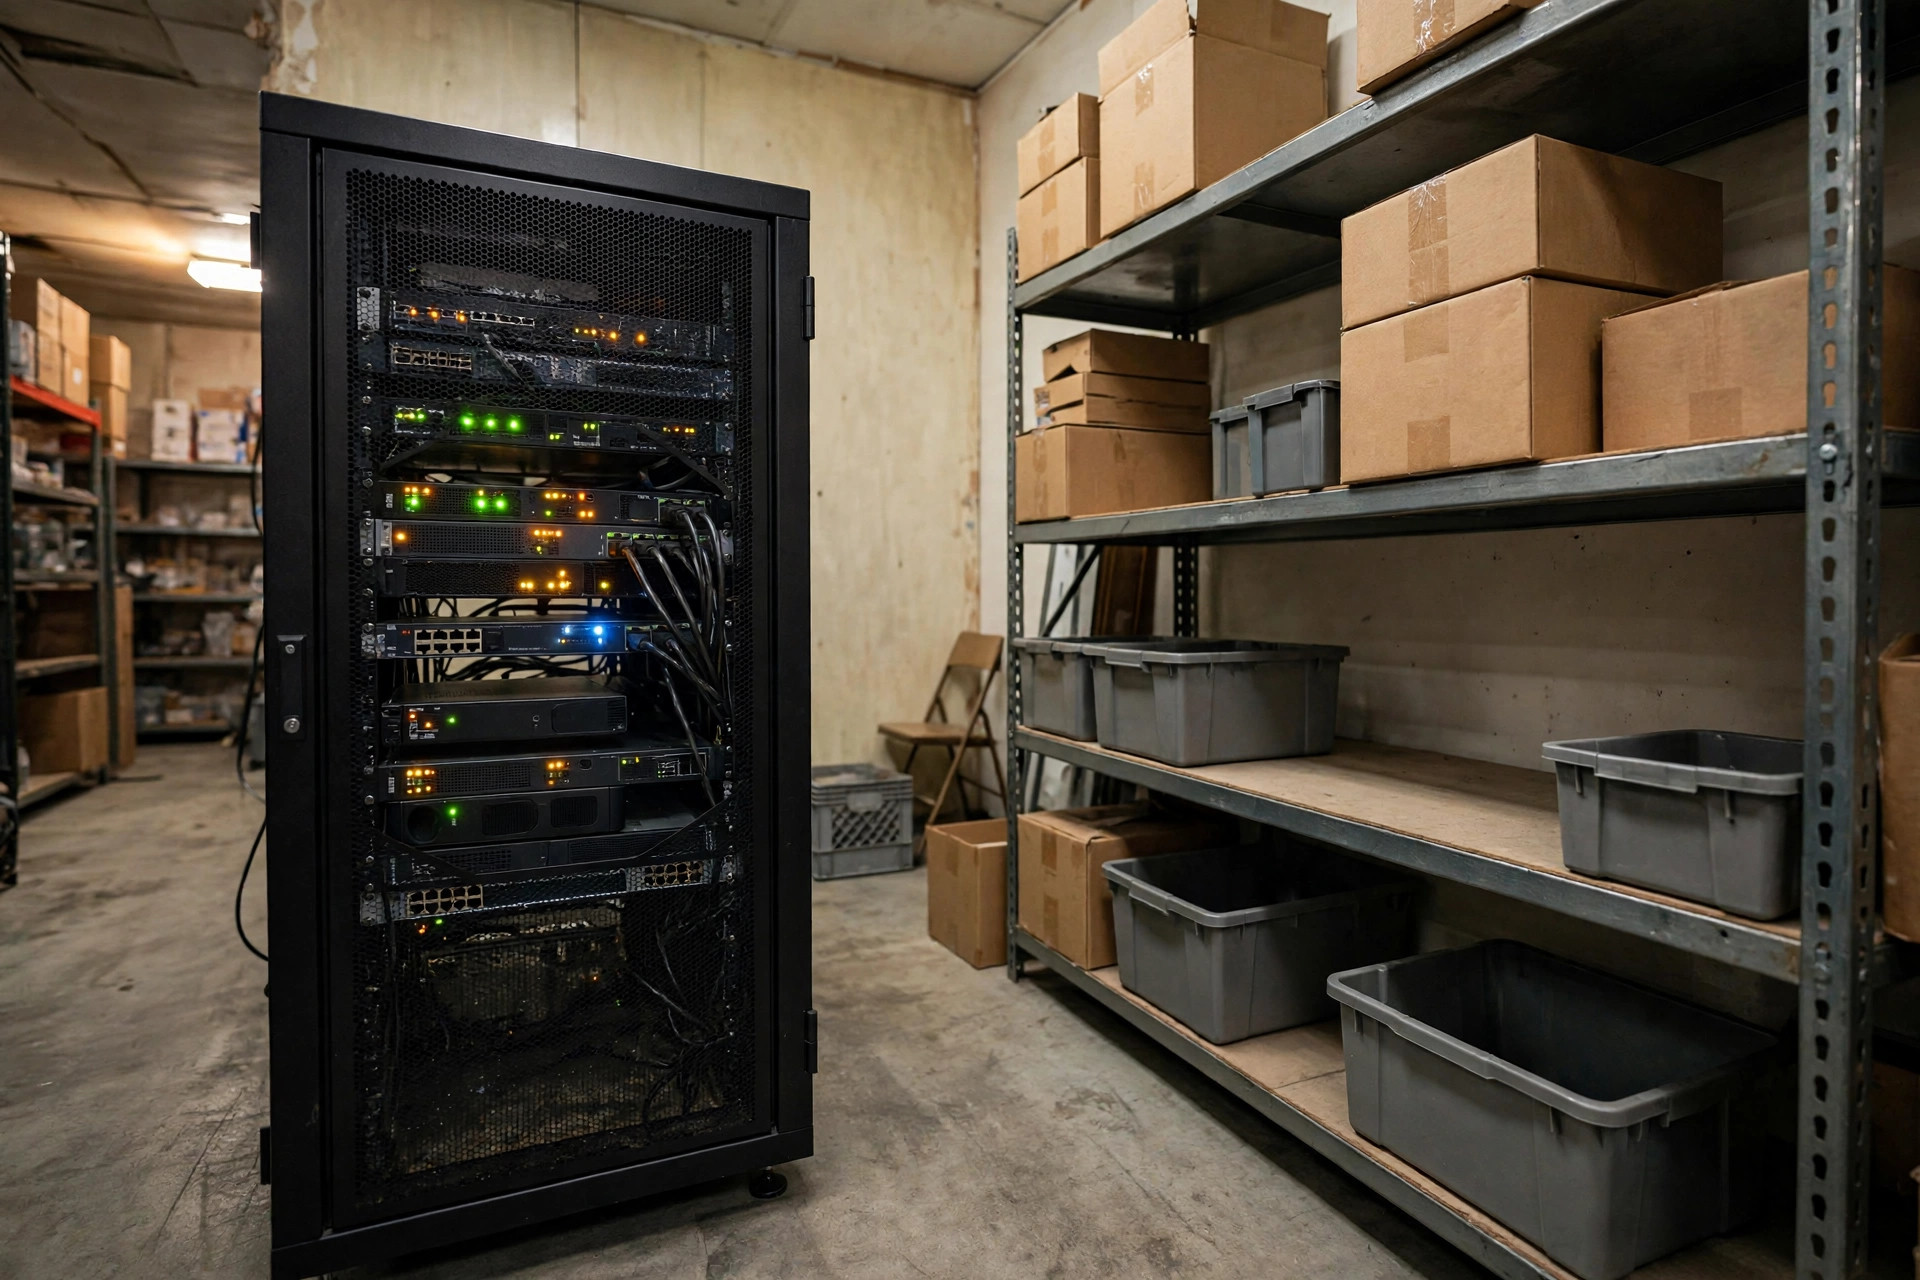
S'il fallait nommer le changement structurel le plus discret de la digitalisation des entrepôts en 2026, le déploiement local de LLM open source arriverait près du sommet : ni événements de lancement, ni gros titres de financement, et pourtant il change progressivement la façon dont les entrepôts consomment l'IA. Jusqu'à récemment, un assistant IA signifiait envoyer des données dans le cloud et payer au token ; aujourd'hui, de plus en plus d'opérateurs d'entrepôts se posent une question sérieuse — le modèle peut-il simplement vivre dans une armoire serveur sur notre propre étage ?
Le phénomène : le Q&A d'entrepôt revient du cloud
Ce n'est pas un fantasme de laboratoire. Le 10 octobre 2026, la plateforme RAG locale-first AnythingLLM a publié sa thèse « Stop Renting Your Intelligence » : traitement de documents, recherche vectorielle et exécution de modèle réunis dans un seul package installable, pour qu'une entreprise puisse mettre en place un assistant de connaissances multi-utilisateur sur son propre réseau en environ cinq minutes. Auparavant, un document de cas d'affaires publié publiquement (arxindustries, 2026) avait déjà tracé la voie : un modèle ouvert de 14 milliards de paramètres sur du matériel de classe station de travail, 100GB de documents confidentiels dans une base de données vectorielle locale, servis via une interface web interne pour au moins trois utilisateurs simultanés — le motif principal déclaré n'étant pas les économies de coûts mais « les données sensibles ne quittent jamais les locaux de l'organisation ».
Pendant ce temps, la recette d'un système local de questions-réponses d'entreprise s'est fortement standardisée dans la communauté open source : Ollama exécute le modèle, une base de données vectorielle open source héberge la connaissance, et OpenWebUI ou AnythingLLM fournit l'interface de chat — chaque composant gratuit. La barre technique pour déployer un assistant IA dans un entrepôt est passée de « embaucher une équipe NLP » à « un généraliste IT qui sait installer un logiciel ».
Les chiffres : d'abord la facture API, puis la facture locale
Pour juger si le déploiement local est rentable, les deux colonnes du bilan doivent être calculées honnêtement. Prenons un scénario typique — un assistant Q&A SOP d'entrepôt sur RAG, chaque question consommant environ 3,000 tokens d'entrée (y compris les extraits SOP récupérés) et 500 tokens de sortie. En utilisant les prix publics des fournisseurs d'octobre 2026 :
- GPT-4o : $2.50 d'entrée / $10.00 de sortie par million de tokens — environ $0.0125 par question
- GPT-4o-mini : $0.15 / $0.60 par million de tokens — environ $0.00075 par question
- Claude Sonnet 4 : $3.00 / $15.00 par million de tokens
- Gemini 2.5 Flash : $0.075 / $0.30 par million de tokens
- Qwen3.8-Flash (hébergé) : $0.15 / $0.47 par million de tokens
Du côté local, selon les prix du marché ouvert américain d'octobre 2026 : une RTX 4090 d'occasion (24GB VRAM) se négocie autour de $2,600–3,000 (médiane d'environ $2,860 parmi les annonces eBay vendues) ; une station de travail capable de l'accueillir coûte environ $1,000–1,500 — environ $4,000 en tout, en une fois. Électricité, estimée à environ $0.20/kWh pour l'énergie commerciale américaine : la carte tire environ 450W à pleine charge, soit environ $870 par an en fonctionnement 24/7, ou environ $290 par an en fonctionnement à deux équipes (environ 8 heures par jour). La pile logicielle — Ollama, AnythingLLM, la base de données vectorielle — est entièrement open source et gratuite.
| API (niveau GPT-4o) | API (niveau mini/flash) | Local (montage avec 4090 d'occasion) | |
|---|---|---|---|
| Investissement initial | $0 | $0 | ~$4,000 |
| Coût annuel à 150 questions/jour | ~$675 | ~$40 | Électricité ~$290–870 |
| Coût annuel à 1,500 questions/jour | ~$6,750 | ~$405 | Électricité ~$290–870 |
| Les données quittent le bâtiment | Oui | Oui | Non |
| Fonctionne hors ligne | Non | Non | Oui |
Le calcul du retour sur investissement, et un résultat contre-intuitif
Lisez le tableau attentivement et la conclusion est plus subtile que l'intuition ne le suggère. À 150 questions par jour, l'API coûte environ $675 par an tandis que l'électricité locale à elle seule coûte $290–870 par an ; amortir les $4,000 d'investissement initial repousse le retour au-delà de dix ans — et si la machine tourne en continu, elle peut ne jamais être rentabilisée. À 1,500 questions par jour sur plusieurs équipes, la facture API atteint environ $6,750 par an tandis que les coûts locaux d'exploitation bougent à peine, de sorte que l'investissement initial est récupéré en environ sept à neuf mois.
Le résultat contre-intuitif est le suivant : plus votre usage est faible, plus le déploiement local est défavorable. Le local est une logique de coûts fixes ; l'API est une logique de coûts variables. Pour la plupart des entrepôts petits et moyens, « payer par question » est le choix le plus rationnel, et « l'open source est gratuit » n'a jamais signifié « le déploiement est gratuit ». Deuxième résultat : le coût n'est souvent pas la vraie variable de décision. Le document de cas arxindustries cite la souveraineté des données, et non les économies, comme motif principal — les SOP d'entrepôt, les profils SKU clients et les grilles tarifaires portent fréquemment des exigences de confidentialité qu'aucune API, aussi bon marché soit-elle, ne peut satisfaire. Troisième jugement : des poids gratuits ne signifient pas une facture gratuite. Construire le pipeline RAG, ingérer et nettoyer les documents, isoler les permissions et corriger la sécurité sont des coûts de main-d'œuvre continus ; l'open source convertit simplement le « loyer de l'intelligence » d'un paiement mensuel en ingénierie initiale plus maintenance à long terme. Et les API bon marché de niveau mini/flash ont presque effacé l'avantage de coût du déploiement local pour le pur Q&A — pour que le local ait un sens, au moins une des trois conditions doit être remplie : volume élevé, données sensibles, ou besoin de fonctionner hors ligne.
Attribution : pourquoi la seconde moitié de 2026, de toutes les époques
Pourquoi maintenant ? Quatre conditions sont arrivées simultanément au second semestre 2026, et chacune était nécessaire.
Premièrement, les licences. Le 10 août 2026, Meta a lancé Muse Glimmer, un modèle de 30 milliards de paramètres sous licence Apache 2.0 — le premier poids ouvert de niveau flagship réellement sans souci pour un usage commercial. Avant lui, la famille Llama était distribuée sous une licence communautaire : les produits de plus de 700 millions d'utilisateurs actifs mensuels nécessitaient une autorisation distincte, et les fonctionnalités multimodales portaient des restrictions régionales dans l'UE — de quoi faire hésiter toute équipe juridique prudente.
Deuxièmement, la densité de capacité. Les architectures mixture-of-experts ont rendu pratique « petite activation, grande connaissance » : Llama 4 Scout (lancé le 5 avril 2025), avec 17 milliards de paramètres actifs sur 109 milliards au total et une fenêtre de contexte de 10 millions de tokens, a été montré par la communauté fonctionnant sur 12GB de VRAM via Ollama ; Qwen3.8-27B (poids ouverts en août 2026) tourne sur un seul GPU avec 262K tokens de contexte natif. Le Q&A d'entrepôt n'a pas besoin de toute la puissance d'un modèle de pointe — il a besoin de « assez bon, et qui tient dans la boîte ».
Troisièmement, le matériel. La RTX 5090 de 32GB permet à une seule carte grand public de contenir des modèles qui nécessitaient auparavant des accélérateurs professionnels — bien que la pénurie de mémoire de 2026 ait poussé les prix de rue à $3,900–4,400 (contre un MSRP de $1,999), faisant de la RTX 4090 d'occasion, à environ $2,600–3,000, le point d'entrée valeur à la place.
Quatrièmement, l'outillage. Les plateformes RAG sans code comme AnythingLLM et OpenWebUI ont réduit « déposez des documents, commencez à poser des questions » à quelques minutes, de sorte que l'informatique d'entrepôt n'a plus besoin de comprendre les embeddings ou le reranking pour faire tourner un système.
En regardant vers 2027 : chaque entrepôt aura-t-il son propre assistant IA ?
Mon jugement : très probablement oui — mais pas sous la forme « un modèle local fait tout ». La forme probable est le routage hybride : un petit modèle local par défaut, des modèles de pointe dans le cloud à la demande — les questions fréquentes de connaissance fermée (SOP, manuels d'équipement, profils clients) restent en local à un coût marginal proche de zéro avec des données qui ne quittent jamais le bâtiment ; le raisonnement complexe et tout ce qui nécessite des données en direct (tarifs, mises à jour réglementaires) va dans le cloud. Le fondement : la courbe de coûts ci-dessus place chaque classe de questions là où elle coûte le moins cher à répondre.
Sur le calendrier, la seconde moitié de 2026 est l'année pilote, et 2027 pourrait être le point d'inflexion : un modèle flagship ouvert sous Apache 2.0, des outils matures de déploiement en un clic et des prix de GPU en détente si la pénurie de mémoire s'apaise comprimeraient ensemble le seuil de déploiement à « une station de travail ». À ce stade, la contrainte contraignante cesse d'être la technologie et devient la préparation organisationnelle — si les documents sont numérisés, si les structures de permissions sont claires, si quelqu'un maintiendra le système.
Les frontières méritent d'être tracées maintenant. Les modèles locaux excellent en Q&A de connaissance fermée ; ils sont mauvais en trois choses : l'information nécessitant un accès internet en direct, les décisions reposant sur de très longues chaînes de raisonnement (optimisation de réseau, sélection de sites), et les domaines où la connaissance doit suivre la frontière en continu. La question de 2027 pour les gestionnaires d'entrepôt pourrait ne pas être « devrions-nous utiliser un assistant IA » mais « quelles questions est-il autorisé à répondre, et lesquelles doivent aller à un humain ou à un modèle cloud » — concevoir cette politique de routage est en soi une nouvelle discipline de gestion.
Une question ouverte pour 2027
Quand le calcul devient un actif fixe comme les rayonnages, où tombe la ligne entre le budget IT et le budget des opérations ? L'IA était une redevance mensuelle de service comptabilisée en charge d'exploitation ; après le déploiement local, elle devient une dépense d'investissement unique plus l'électricité — des actifs fixes et un coût d'énergie. Ce changement comptable change silencieusement qui approuve les dépenses d'IA et comment elles sont mesurées : de « combien avons-nous dépensé en tokens ce mois-ci » à « quel est le taux d'utilisation de cette machine ». Les entrepôts en 2027 pourraient devoir répondre à la question de la propriété budgétaire avant la question du choix technologique — et pour cela, il n'existe pas encore de réponse standard.
Par Dr. Chen, Chercheur en gestion de la chaîne logistique
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.