L'adoption de l'IA générative dans l'entrepôt fait beaucoup de bruit depuis deux ans. J'ai lu des démonstrations de fournisseurs et des rapports du secteur qui laissent entendre que la technologie peut gérer un bâtiment à elle seule, puis j'ai visité de vrais entrepôts où elle se contente encore surtout de répondre à des questions. Cet article ne parle pas de la vision. Il s'agit de mesurer la distance entre répondre à une question et prendre une décision, étape par étape, et de se demander ce que coûte réellement chaque étape et combien de temps elle prend.
Un entrepôt est un endroit difficile pour un système qui a l'air sûr de lui. Choisir le mauvais article peut se retourner. Expédier la mauvaise palette peut se transformer en réclamation pour un camion entier. Les modèles de langage sont doués pour traiter les formulations vagues et rassembler des informations éparses. Les entrepôts ont besoin d'actions précises assorties d'un dossier traçable. L'intérêt de recherche pour les outils d'IA générative en entrepôt ne cesse de croître, mais l'intérêt de recherche n'est pas la même chose que la préparation sur le terrain. L'écart entre ces deux exigences est le sujet de cet article.
L'IA générative dans l'entrepôt : trois étapes, pas un seul bond
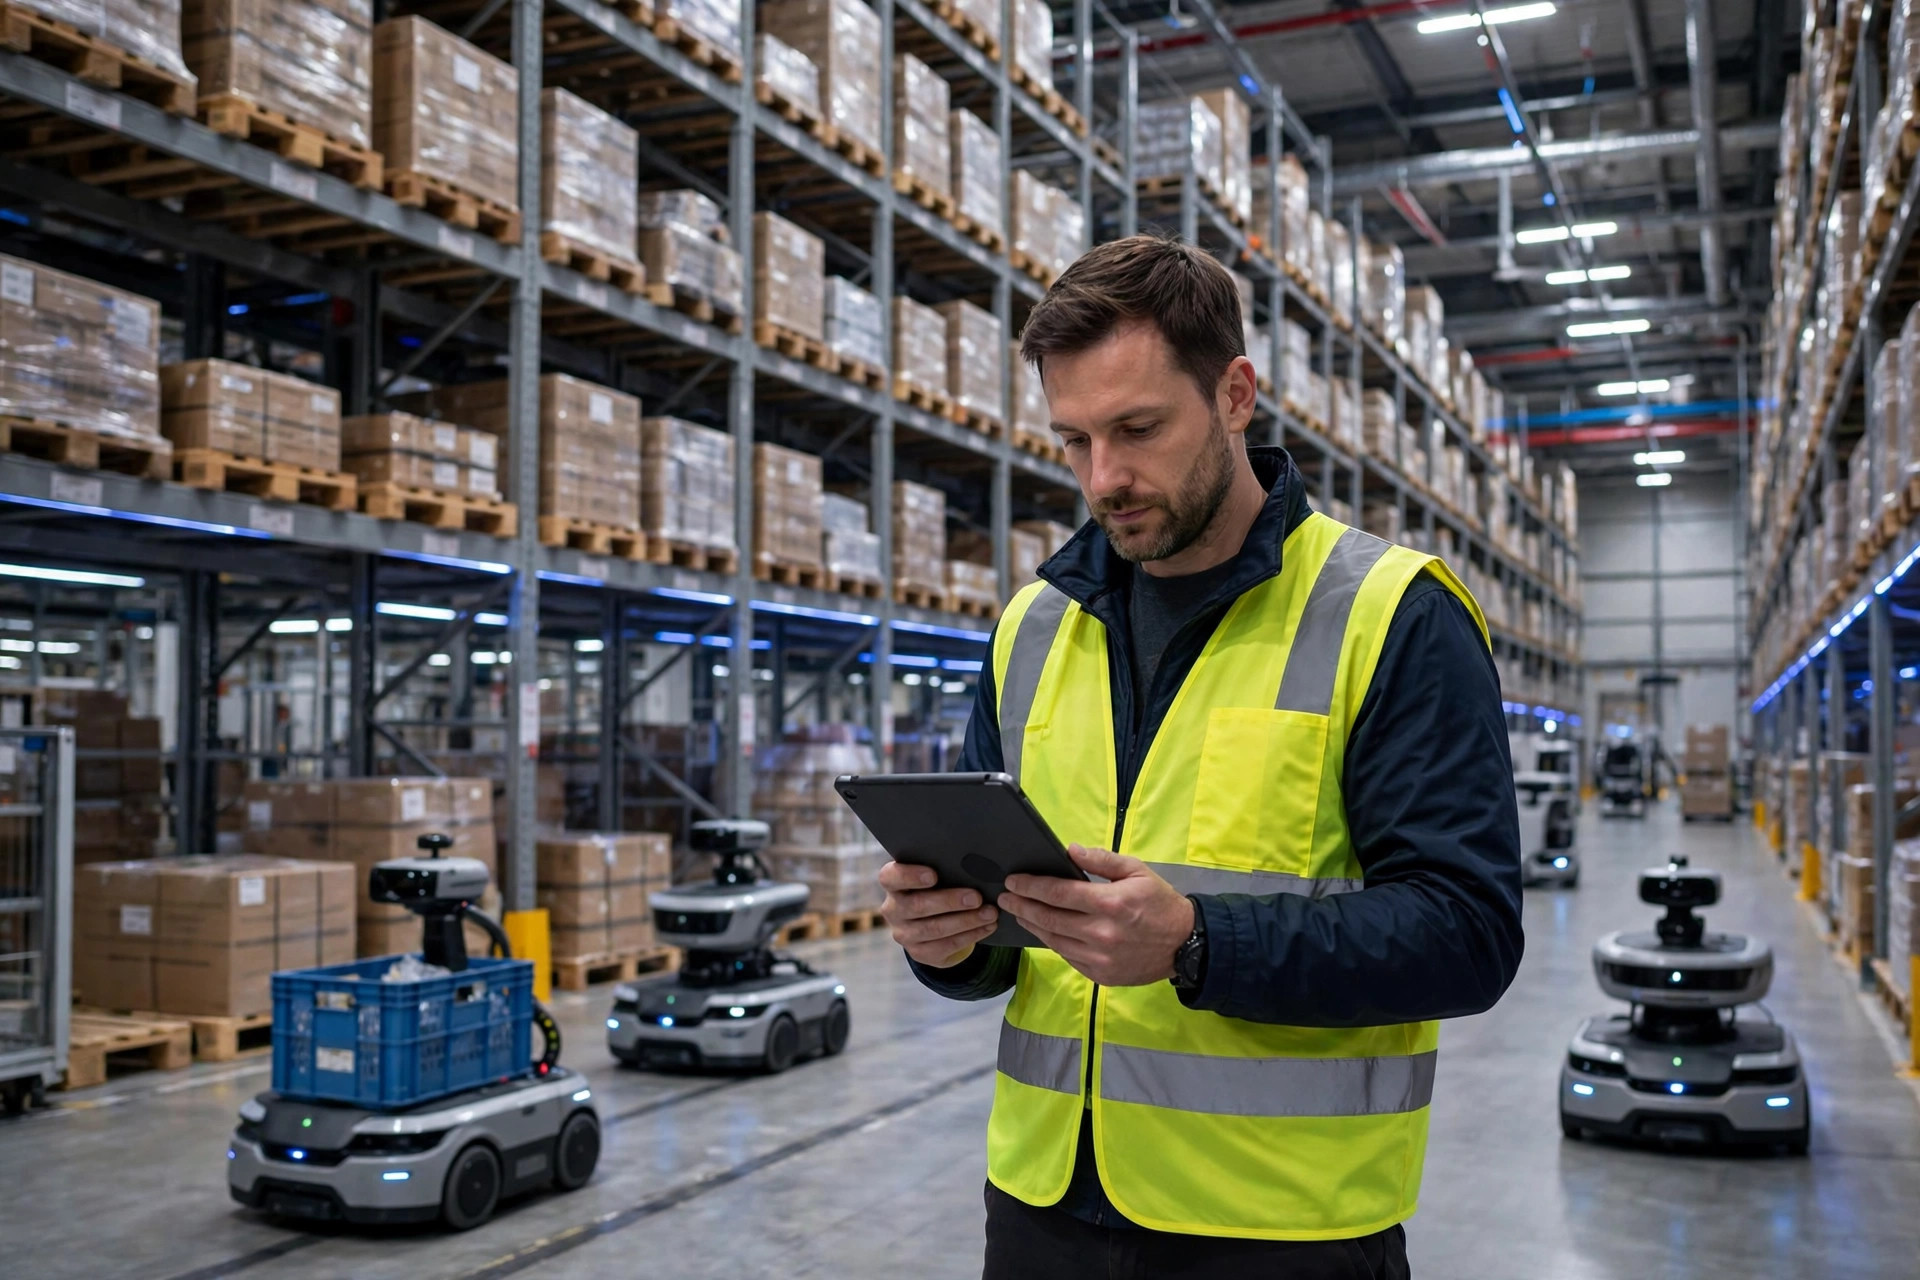
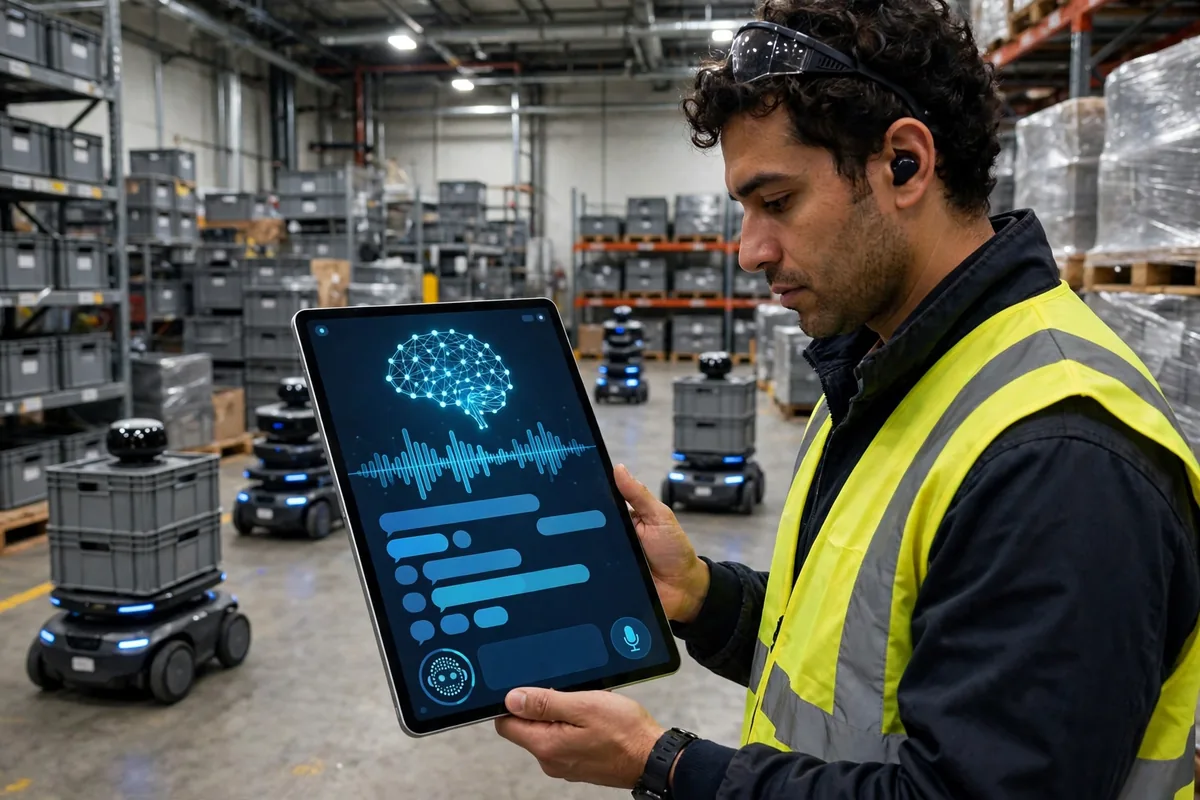
La première étape est l'assistant qui répond aux questions. Un employé demande à un téléphone ou à une tablette où se trouve l'expédition de demain matin, et le système recherche l'emplacement dans le système de gestion d'entrepôt et répond en langage simple. L'obstacle est faible ici, car rien n'est exécuté. Le système ne touche qu'à l'information. À l'automne 2024, j'ai observé un pilote de ce type dans un entrepôt tiers près d'Ontario, en Californie : un superviseur de nuit a demandé à voix haute où était stocké un lot qui devait partir le matin, et le système a lu l'emplacement depuis le WMS. Le pilote a duré six semaines, et le verdict du superviseur était pratique. Cela faisait gagner du temps, a-t-il dit, mais seulement quand les données d'emplacement étaient déjà exactes. Quand les données étaient fausses, une réponse fluide n'était qu'une mauvaise réponse livrée plus vite.
La deuxième étape est le copilote. Il cesse de se contenter de répondre et commence à aider les gens à juger : quelles commandes préparer dans cette vague, quelle zone est sur le point de s'engorger compte tenu du plan de réception du jour, ou un brouillon de note de passation pour l'équipe suivante. Cette étape touche au processus, et avec le processus vient la question de la responsabilité. Si une suggestion est fausse, qui en est responsable ? Le système dit-il à quel point il est sûr de lui ? Les démonstrations ne montrent jamais ces questions. Les opérations réelles les soulèvent chaque jour.
La troisième étape est l'exécution autonome. Le système décide seul du réapprovisionnement, des transferts et des changements de vague, les personnes examinant les exceptions. La forme réaliste la plus proche n'est pas l'automatisation complète mais l'autonomie restreinte : une autorité à l'intérieur d'une famille de produits, d'une zone, d'une équipe, tout ce qui sort de ce périmètre étant renvoyé à une personne. Traiter cette étape comme une prise de contrôle du jour au lendemain, c'est mal comprendre le fonctionnement des entrepôts.
Il n'y a pas de raccourci. Un entrepôt où l'assistant qui répond aux questions ne peut pas fonctionner de manière fiable ne fera qu'amplifier ses erreurs avec un copilote. Un copilote dont personne n'examine ni ne corrige les suggestions ne peut pas évoluer vers l'exécution autonome. Chaque étape doit produire des résultats vérifiables à petite échelle avant de mériter un périmètre plus large.
L'IA générative et la question de l'argent
Un chercheur regarde la technologie à travers son grand livre, pas à travers ses gros titres. Le grand livre de l'IA générative comporte trois postes, et chacun doit énoncer ses prémisses clairement, sinon les chiffres ne veulent rien dire.
Le tableau ci-dessous est un exemple hypothétique. Tous les chiffres sont inventés pour montrer la méthode, et ne proviennent de la comptabilité d'aucun entrepôt réel.
| Coût ou bénéfice | Exemple hypothétique | Comment le vérifier |
|---|---|---|
| Pilote de réponse aux questions | Environ $60,000, intégration et trois mois d'essai compris | Vérifier le devis du fournisseur ligne par ligne |
| Temps de superviseur gagné sur les recherches | Supposons 40 minutes par jour, à $28 de l'heure | Mesurer deux semaines de relevés de temps |
| Étape du copilote, dépense supplémentaire | Supposons $120,000 de plus, changements de processus compris | Ventiler en logiciels, intégration et formation |
| Capacité supplémentaire par vague | Supposons 90 commandes de plus par jour | Comparer le volume sortant sur les mêmes heures avant et après |
| Coût de correction des mauvaises réponses | Supposons $2,000 par mois de travail de correction | Compter les vrais tickets de correction |
Voici un jugement à contre-courant qu'il vaut la peine de formuler avant l'arithmétique : le bénéfice le plus surestimé de l'IA générative dans un entrepôt est la réduction des effectifs, et le plus sous-estimé est la diminution des retouches. Un assistant qui répond aux questions ne supprime pas un poste. Il supprime les quarante interruptions par jour qui brisent la concentration d'un superviseur. Une bonne suggestion du copilote est précieuse non parce qu'elle est rapide, mais parce qu'elle empêche un nouvel employé de commettre une erreur qu'un travailleur expérimenté repérerait d'un coup d'œil. Un business case fondé sur la suppression de postes est faux le jour même de sa signature.
Les délais méritent la même retenue. L'étape de l'assistant qui répond aux questions peut atteindre un pilote utilisable dans la plupart des entrepôts de taille moyenne en un an. L'étape du copilote exige d'abord des données de processus propres, et cette préparation prend souvent plus de temps que le travail sur le modèle lui-même. L'exécution autonome apparaîtra d'abord seulement dans un petit nombre d'entrepôts dotés de bases de données solides et de gammes de produits stables, et elle commencera de façon restreinte. Toute feuille de route qui comprime les trois étapes en une seule année devrait recevoir une question : où est le travail de préparation des données dans le plan ?
Ce que l'IA générative ne peut pas encore faire sur le terrain
Le premier obstacle est celui des données. Les données de l'entrepôt vivent dans le WMS, l'ERP, les tableurs et la tête du personnel expérimenté, et le même article peut porter trois noms différents dans trois systèmes. L'IA générative tolère les données sales bien moins que les humains. Une personne qui voit un emplacement erroné le corrige grâce à son expérience. Un modèle énonce la mauvaise réponse avec assurance. Il n'y a pas de raccourci pour contourner la gouvernance des données, et les entrepôts qui la sautent le paient pendant le pilote.
Le deuxième obstacle est la responsabilité. Quand un copilote suggère et qu'un système exécute, la question de savoir qui est responsable d'une erreur doit être écrite dans le processus avant la mise en service, et non débattue après un incident. L'approche la plus sûre est l'autorité graduée : les suggestions courantes à faible risque peuvent s'exécuter automatiquement, les actions à haut risque nécessitent une confirmation humaine, et chaque décision automatisée laisse une trace qui peut être suivie, examinée et arrêtée.
Le troisième obstacle est l'acceptation sur le terrain. Les travailleurs de première ligne jugent un nouvel outil à un seul test : aide-t-il ou gêne-t-il ? Si un assistant qui répond donne une réponse inutile deux fois sur dix, les travailleurs cessent de demander dès la troisième tentative. Les chiffres qui comptent le plus pendant un pilote ne sont pas les scores des démonstrations mais les nombres réels d'utilisations et de contournements. Ces deux chiffres sont plus honnêtes que n'importe quelle enquête de satisfaction.
Au total, la séquence est claire. Rendez l'assistant qui répond suffisamment solide pour que les travailleurs l'utilisent vraiment. Placez le copilote dans un ou deux scénarios concrets et faites-le tourner jusqu'à ce que ses suggestions puissent être examinées. Ne parlez d'exécution autonome que lorsque les données, la responsabilité et la confiance sont toutes en place. Cet ordre est lent, et c'est le seul ordre qui fonctionne dans un entrepôt.
En regardant trois ans plus loin, la forme la plus probable de la technologie d'IA générative en entrepôt n'est pas un robot qui parle mais une couche invisible d'aide : dans la zone de recherche du WMS, dans les suggestions de planification des vagues, dans les notes de passation. Pour juger si un entrepôt l'utilise vraiment, sautez l'événement de lancement et vérifiez deux choses : les travailleurs lui posent-ils vraiment des questions chaque jour, et les superviseurs consultent-ils vraiment ses suggestions quand ils planifient les équipes et les vagues ? Si les deux réponses sont oui, la troisième étape n'est pas loin. Si l'une des réponses est non, la question honnête est de savoir ce qui manque encore, et la réponse est généralement les données, la responsabilité ou la confiance.
Par Dr. Chen, Chercheur en chaîne d'approvisionnement Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.