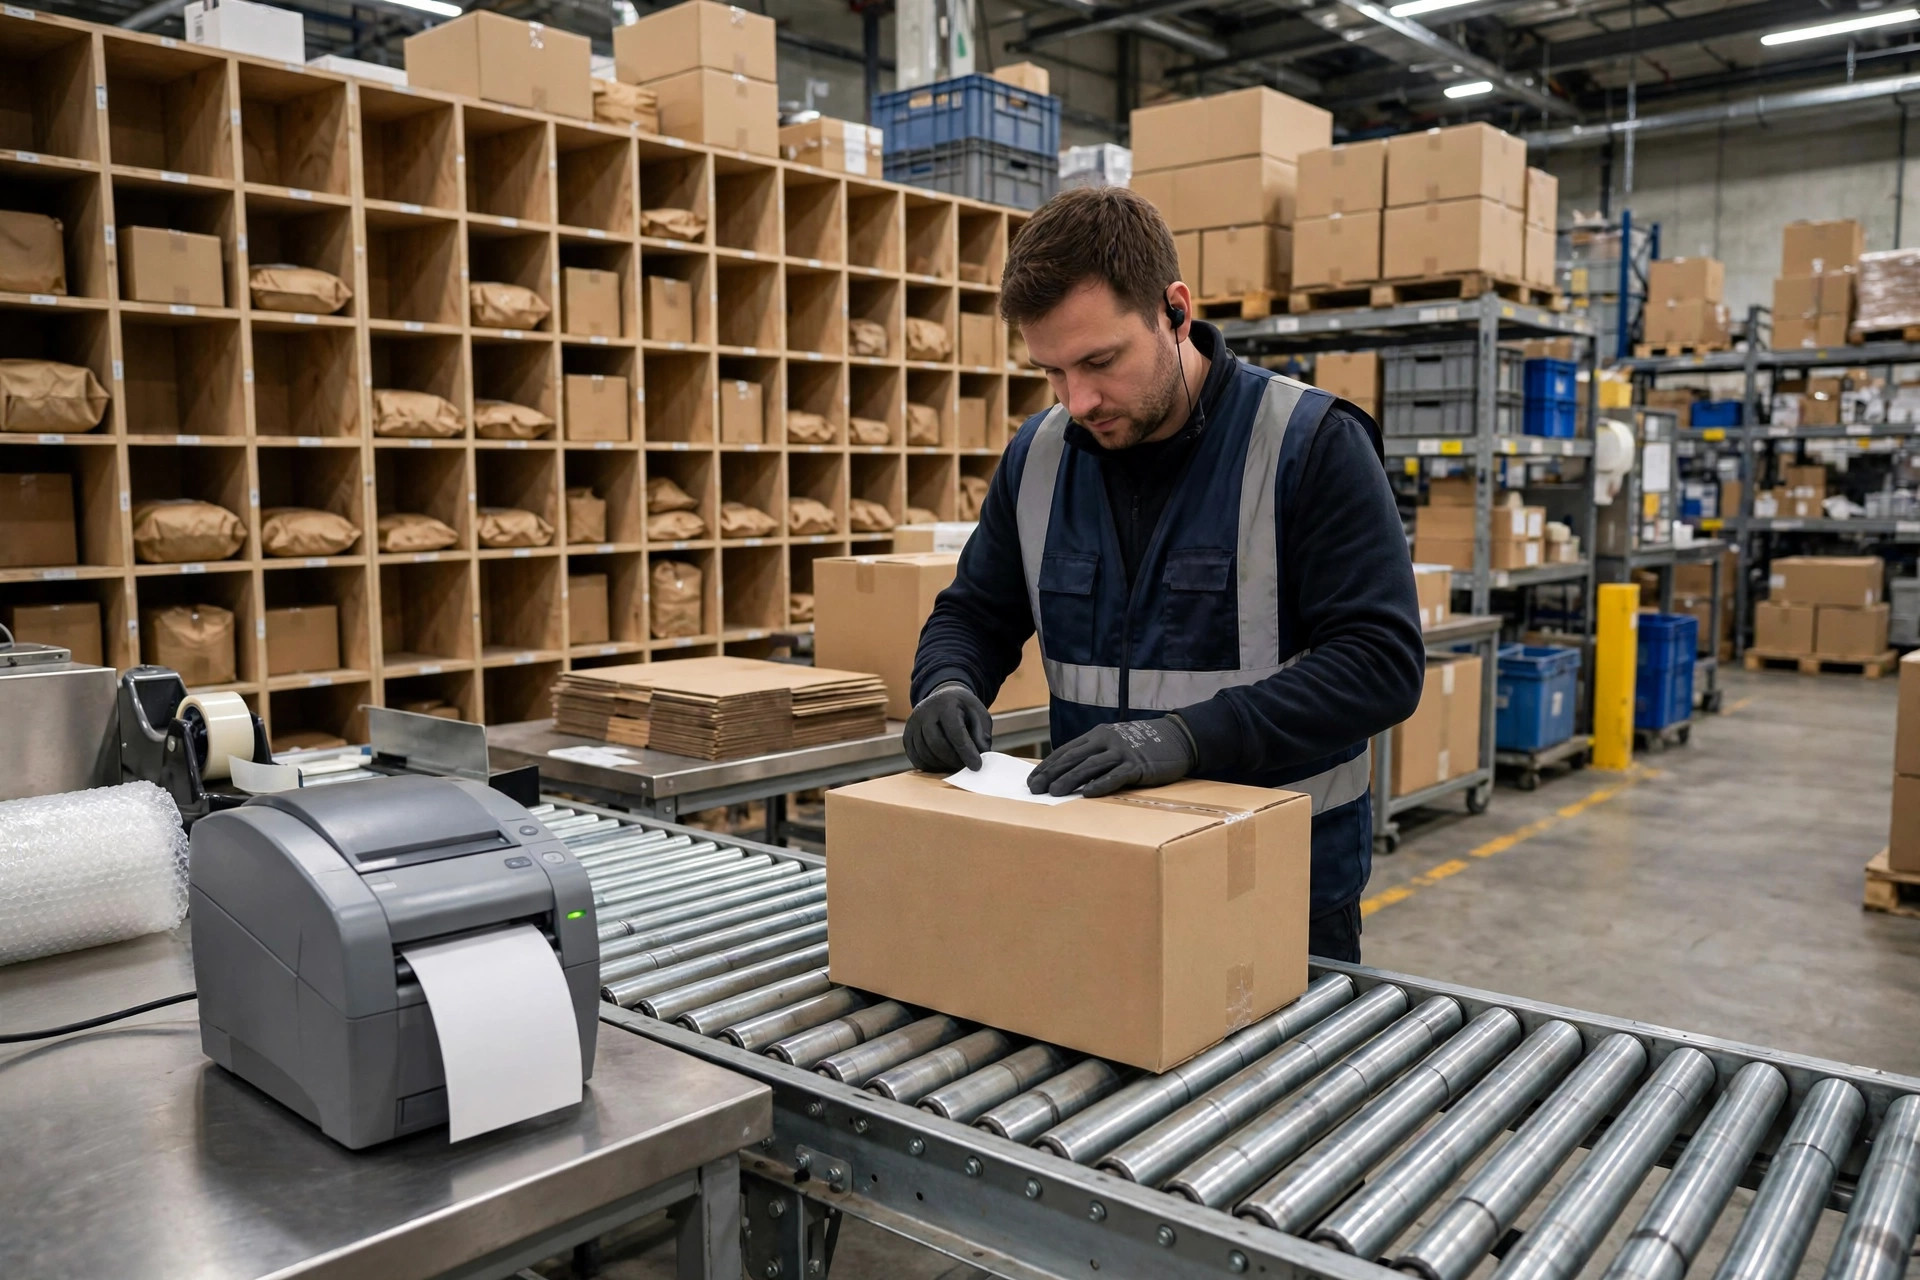
En 2019, dans un entrepôt 3PL à Ontario, en Californie, j'ai assisté à cette scène en direct : trente ou quarante colis empilés au poste d'emballage, un opérateur qui les scannait un par un avec un lecteur portable, le système affichant "étiquette créée" pour chaque commande — mais seulement la moitié des étiquettes étaient réellement sur la table. L'imprimante alimentait le papier sans problème. C'était juste… incomplet. Les appels du service client arrivaient déjà : des acheteurs qui demandaient pourquoi leur suivi n'était jamais mis à jour. Cet après-midi-là, nous avons passé toute la chaîne au peigne fin, et au final le transporteur n'y était pour rien. Notre propre logique de réessais ne transmettait pas de clé d'idempotence. Une requête dont le délai avait expiré avait en réalité réussi côté transporteur ; le système a supposé un échec et a relancé. Le second appel a renvoyé la même étiquette, a écrasé le premier enregistrement, et le premier colis était déjà parti avec l'autre étiquette imprimée collée dessus. Celle qui ne se réconciliait pas, c'était l'étiquette écrasée.
Mon verdict d'entrée : quand les API d'étiquettes du transporteur "perdent" des étiquettes, 90 % du temps ce n'est pas la faute du transporteur — c'est votre logique de réessais et votre machine à états. Des 10 % restants, environ sept parts sont la file d'impression et trois parts le côté transporteur. Ça sonne agressif ? J'ai passé vingt ans dans des entrepôts américains et intégré plus d'API d'étiquettes que je ne peux en compter sur mes deux mains. La cause racine est toujours l'une des six étapes ci-dessous. Voici une chaîne de débogage du symptôme à la cause racine, dans l'ordre. Un après-midi suffit pour la cerner.
Ne blâmez pas encore le transporteur — vérifiez vos journaux de requêtes
Quand ça casse, la première étape, c'est toujours les logs. Pas le tableau de bord du transporteur — l'enregistrement de votre propre système sur le fait que la demande d'étiquette est bien partie et ce que le transporteur a renvoyé.
Où regarder : la table de logs API de votre WMS ou de votre middleware. À quoi ressemble un système sain : chaque appel a un enregistrement avec horodatage, numéro de commande, corps de la requête, corps de la réponse, code de statut HTTP et latence. Vérifiez trois choses.
Premièrement, la requête et la réponse complètes sont-elles persistées ? Beaucoup de systèmes ne stockent que "succès/échec" et jettent le corps de la réponse. C'est une boîte noire. Déboguer des étiquettes perdues sans paires requête/réponse complètes, c'est pratiquement deviner. Le pire montage que j'ai vu ne journalisait que le numéro de commande et "OK" — quand ça cassait, l'équipe devait réconcilier commande par commande dans le portail du transporteur. Ça a transformé un après-midi en trois jours.
Deuxièmement, y a-t-il eu des délais dépassés, et combien de réessais ? Les timeouts sur les API d'étiquettes sont normaux ; les transporteurs ralentissent en pic, parfois au-delà de 10 secondes. La vraie question : avez-vous réessayé après le timeout, et le réessai portait-il une clé d'idempotence ? Un timeout n'est pas un échec — la requête a bien pu réussir côté transporteur pendant que votre système ne recevait jamais la réponse. Un réessai aveugle imprime alors deux étiquettes — ou pire, deux étiquettes partageant un numéro de suivi, votre système ne reconnaissant que la seconde. La première étiquette devient un fantôme : physiquement sur un colis, invisible à votre système.
Troisièmement, le numéro de suivi de la réponse correspond-il à celui stocké dans votre système ? Certaines intégrations confondent le numéro de suivi maître du transporteur avec le numéro au niveau colis et stockent le mauvais champ. L'étiquette n'est pas perdue — vous cherchez au mauvais endroit.
Si vos logs sont complets, cette seule étape révèle le problème 80 % du temps. S'ils sont incomplets, corrigez la journalisation avant de déboguer quoi que ce soit d'autre — sans données, toute conclusion est superstition.
Si une commande frappe l'API deux fois, combien d'étiquettes sortent ?
Étape deux : l'idempotence. C'est la zone sinistrée, et c'est la cause racine de l'histoire par laquelle j'ai commencé.
À quoi ressemble un système sain : le même numéro de commande frappant l'API un nombre quelconque de fois produit exactement une étiquette valide côté transporteur ; les appels répétés renvoient le premier résultat au lieu d'émettre une nouvelle étiquette. Cette garantie vient d'une clé d'idempotence — généralement le numéro de commande plus un identifiant unique métier, envoyé avec la requête.
Où regarder : votre wrapper d'API — la demande d'étiquette transmet-elle réellement un champ d'idempotence ? La plupart des API d'étiquettes de transporteurs en prennent en charge un (vérifiez la dernière documentation du transporteur pour le nom exact du champ), mais beaucoup d'intégrations d'entrepôts ne l'envoient jamais. La variante la plus sournoise : vous en envoyez une, mais à la mauvaise granularité. Utiliser "numéro de commande + horodatage" comme clé, par exemple — l'horodatage diffère à chaque fois, donc c'est comme ne rien envoyer. Chaque réessai émet une étiquette fraîche.
Comment vérifier : prenez une commande à étiquette perdue et comptez combien de fois l'API a été appelée dans les logs, et si chaque appel a renvoyé le même numéro de suivi. Deux appels renvoyant deux numéros de suivi différents, avec seulement le second stocké dans votre système — l'étiquette du premier numéro de suivi est votre étiquette "perdue". Elle existe vraiment, collée sur un colis. Le colis est parti ; votre système ne le sait pas. Ce que voit le service client, c'est "étiquette créée mais aucune mise à jour de suivi".
Et un filet de sécurité au niveau base de données : la colonne d'étiquette/numéro de suivi a besoin d'une contrainte d'unicité. Sans elle, les écritures en double ne lèvent jamais d'erreur — les données sales s'accumulent en silence, et quand vous le remarquez, rien ne se réconcilie. Ajouter cette contrainte ne coûte rien et paie immédiatement.
Étiquette générée, statut jamais écrit : vérifiez votre machine à états
Étape trois : callbacks asynchrones et machine à états. Certaines API d'étiquettes sont asynchrones : vous envoyez la requête, le transporteur répond "accepté", et le fichier d'étiquette réel et le numéro de suivi arrivent par callback quelques secondes ou minutes plus tard.
À quoi ressemble un système sain : le statut de la commande coule proprement — disons, pending → creating → created → printed — chaque transition horodatée. Si le callback n'est pas arrivé, la commande devrait rester à "creating", pas devenir d'une façon ou d'une autre "created".
Où regarder : le journal des transitions de statut. Méfiez-vous des états sautés : le callback n'est jamais arrivé, mais le statut indique "created". C'est généralement un job de polling trop optimiste ou une logique frontend qui marque le succès dès l'envoi de la requête, sans jamais attendre le callback.
La variante plus méchante : le callback est arrivé, mais votre endpoint de callback a échoué — un échec de vérification de signature, un timeout de verrou base de données — donc le transporteur affiche "livré" alors que votre côté ne l'a jamais persisté. Chaque côté raconte sa propre histoire. Vérifiez les logs d'erreur de l'endpoint de callback ; la preuve est presque toujours là. Personne ne la lisait.
Mon verdict : la machine à états est la chose la plus rentable à bien faire dans le pipeline d'étiquettes. Une machine à états qui autorise les états sautés n'est pas une machine à états.
L'imprimante : le bouc émissaire le plus maltraité
Les trois premières étapes sont propres ? Regardez l'impression. Les imprimantes Zebra perdent des travaux plus souvent qu'on ne le pense.
À quoi ressemble un système sain : le fichier d'étiquette entre dans la file d'impression, l'imprimante crache les feuilles une par une, et chaque feuille reçoit une confirmation d'impression. Où regarder : le journal de file du serveur d'impression — chaque travail est-il "terminé" ou assis en "erreur/annulé" ? Les imprimantes Zebra ont une habitude classique : le ruban ou le stock d'étiquettes s'épuise, la tête d'impression surchauffe, et au lieu de le signaler bruyamment, le travail reste simplement bloqué dans la file pendant que le frontend dit "envoyé". L'opérateur ne voit pas de papier, suppose que le système n'a jamais créé l'étiquette, et appuie de nouveau sur imprimer — et sans poignée de main de confirmation d'impression, ça imprime un doublon.
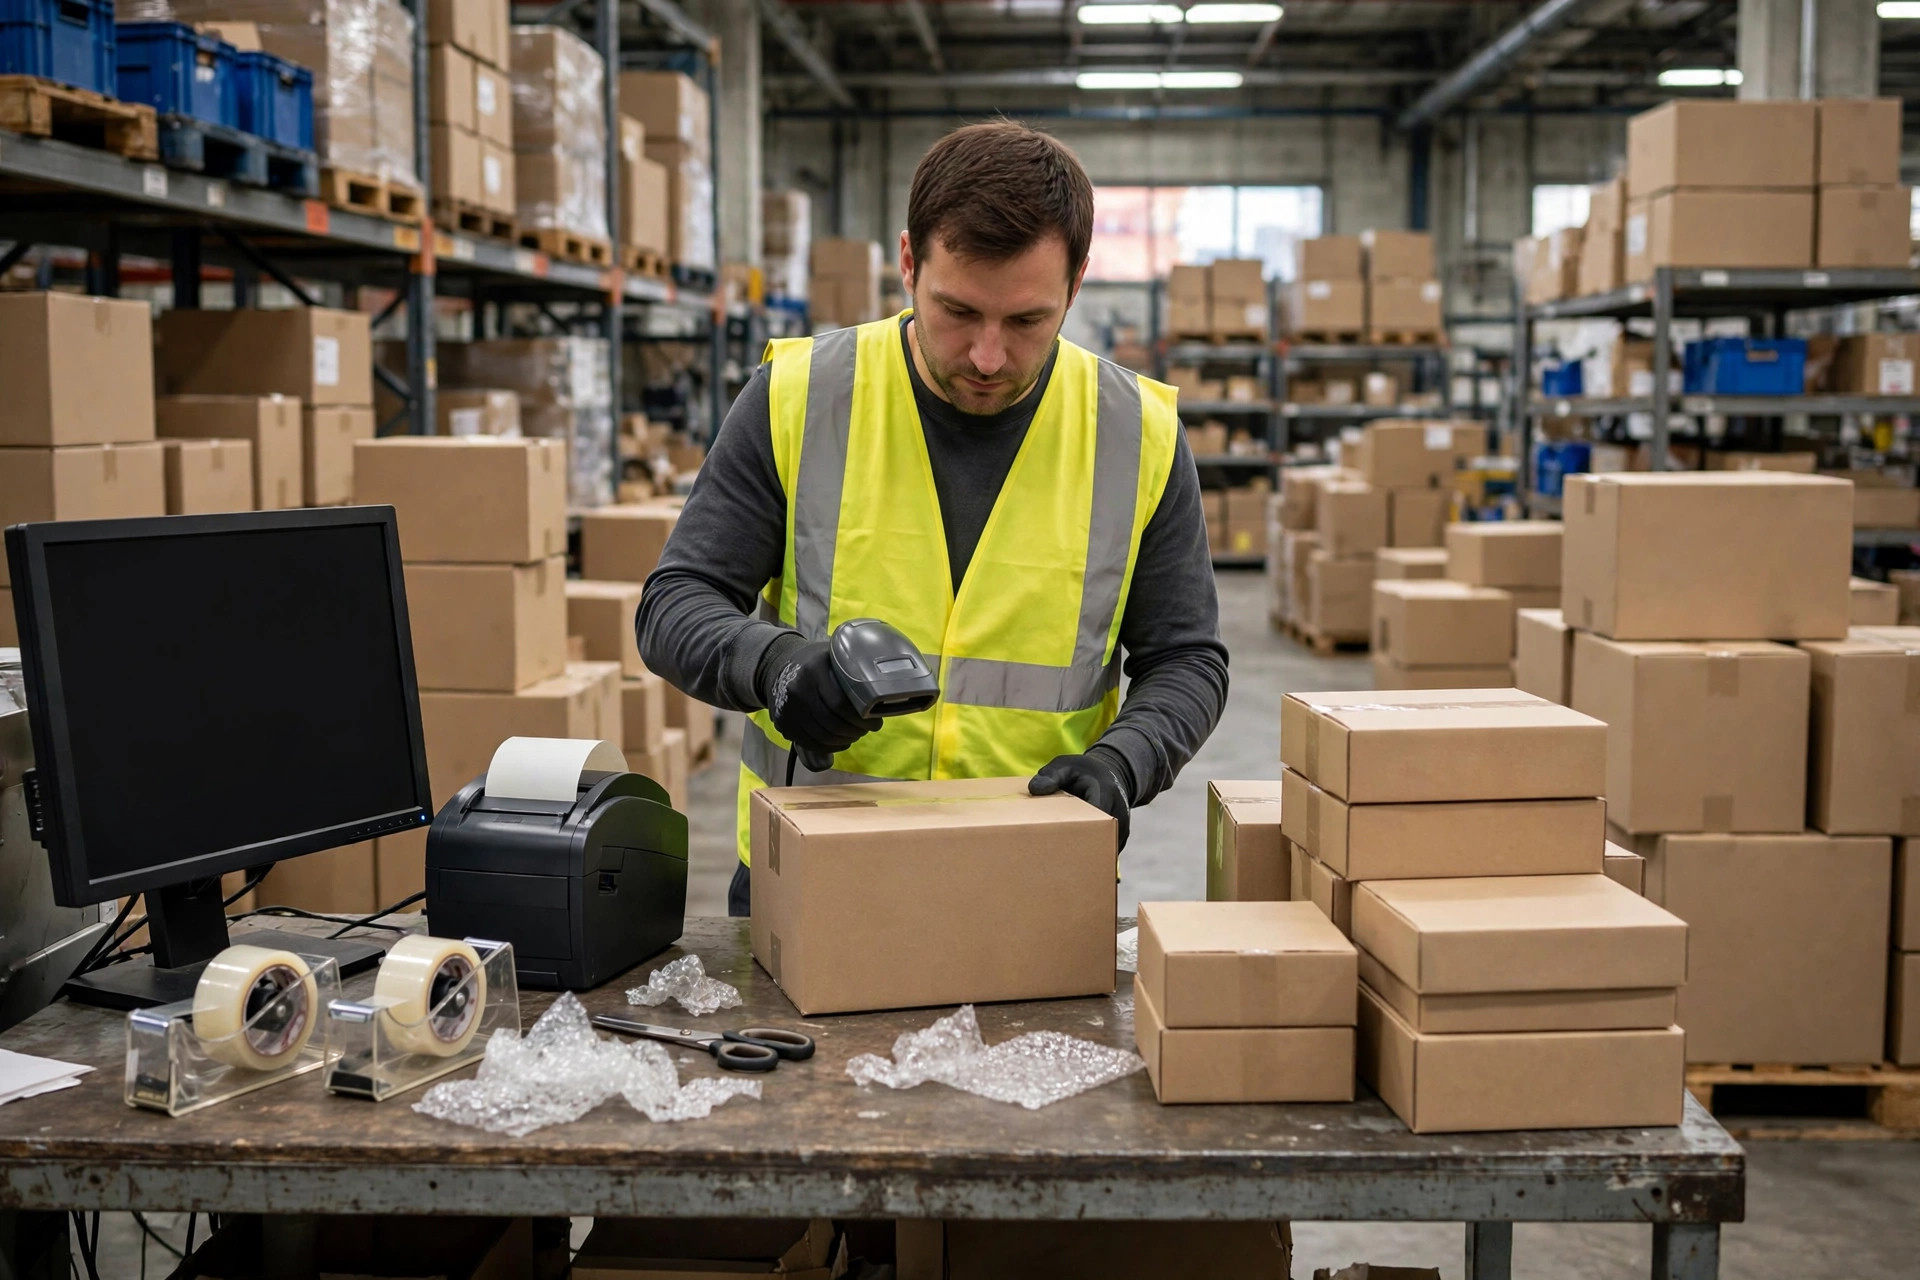
Autre classique : une imprimante réseau tombe et se reconnecte, et tout l'arriéré de la file sort d'un coup. L'opérateur en arrache quelques-unes, les colle, et le reste se mélange — étiquettes mal appliquées et manquées partout. C'est pourquoi ma liste de prévention insiste sur un accusé de confirmation d'impression : l'imprimante accuse réception de chaque feuille, et ce n'est qu'alors que le système fait passer le statut à "printed". Une impression sans accusé est une impression qui n'a jamais eu lieu.
Le côté transporteur : limites de débit et validation d'adresse, avalées en silence
Enfin, le transporteur. La conclusion honnête : les causes vraiment côté transporteur sont rares — quelques fois par an au maximum. Mais elles sont les plus difficiles à investiguer, parce que le problème n'est pas entre vos mains.
Où regarder : les enregistrements d'appels API et codes d'erreur du portail développeur du transporteur. Concentrez-vous sur deux catégories.
Premièrement, la limitation de débit. Pendant la saison des promos et les pics, votre QPS dépasse le quota du compte et le transporteur rejette la requête. Certains renvoient un 429 propre ; d'autres — je vais le dire franchement — un grand transporteur renvoie 200 sur certains endpoints quand il est étranglé, avec un message d'erreur discret glissé dans le corps. Si votre code ne vérifie que le statut HTTP, il croit que l'étiquette a été créée. Elle ne l'a pas été. C'est un échec silencieux ; en investiguant, lisez le corps de la réponse, pas seulement le code de statut.
Deuxièmement, les échecs de validation d'adresse. Les adresses américaines sont pointilleuses — un chiffre erroné dans le numéro d'appartement ou de suite, une inadéquation ZIP+4, et la validation côté transporteur rejette la commande. Cela devrait revenir comme une erreur d'adresse claire, mais certaines intégrations avalent les erreurs de validation en exceptions génériques, ne journalisant que "échec de création d'étiquette". L'opérateur voit l'échec, saisit la commande manuellement — avec une adresse légèrement différente de celle enregistrée dans le système — le colis part, et rien ne se réconcilie. Pour cette catégorie, la validation d'adresse en amont compte dix fois plus que le débogage a posteriori.
Je ne citerai pas ici de tarifs ni de chiffres de limitation spécifiques ; les politiques des transporteurs changent vite, alors fiez-vous à la dernière politique publiée sur leur site officiel.
Réconciliez quotidiennement : le dernier filet de sécurité, et la première chose que vous auriez dû construire
Étape six, et celle que je veux le plus que vous livriez demain : réconciliez chaque jour votre nombre d'étiquettes avec la facture du transporteur.
La logique est simple : le nombre d'"étiquettes créées" d'hier dans votre système devrait égaler le nombre d'étiquettes d'hier sur la facture du transporteur. Là où ils diffèrent, l'écart est vos étiquettes perdues — quelle que soit l'étape de la chaîne qui les a avalées, les chiffres ne mentent pas.
Comment faire : écrivez un job de réconciliation quotidien qui récupère la facture ou le rapport d'utilisation du transporteur pendant la nuit (la plupart des portails de transporteurs en exportent un) et le rapproche enregistrement par enregistrement avec vos enregistrements d'étiquettes par numéro de suivi. La liste d'exceptions arrive dans les boîtes de réception des opérations et de l'informatique chaque matin. La première exécution peut vous effrayer — c'est la dette historique qui fait surface d'un coup, ce qui est bien. Cela signifie que le mécanisme fonctionnait nu avant.
Je recommande deux niveaux d'alerte. Niveau métier : alertez si aucune étiquette n'est créée pendant 10 minutes en heures d'exploitation — un poste d'emballage ne peut pas passer 10 minutes sans une seule étiquette en fonctionnement normal, donc un déclenchement signifie presque sûrement que l'API est en panne. Niveau réconciliation : escaladez vers un humain si le nombre quotidien d'exceptions dépasse 5. Réglez les seuils sur votre volume, mais ayez des seuils. Une surveillance sans seuils n'est pas une surveillance.
La liste de prévention : faites ces cinq choses et les étiquettes perdues disparaissent pratiquement
Déboguer soigne la maladie ; prévenir garde en bonne santé. Cinq points, classés par rapport coût-bénéfice :
| Point | Que faire | Coût |
|---|---|---|
| Politique de réessai sur timeout | Réessayer uniquement sur timeout, toujours avec une clé d'idempotence ; maximum 3 réessais avec backoff exponentiel | Une demi-journée de dev |
| Unicité du numéro de suivi | Index unique sur la colonne du numéro de suivi ; les écritures en double échouent bruyamment | Quelques minutes |
| Resserrez la machine à états | Aucun état sauté ; les commandes restent en "creating" jusqu'à l'arrivée du callback, puis escalade vers revue manuelle en cas de timeout du callback | 1–2 jours |
| Accusés de confirmation d'impression | Les accusés de l'imprimante pilotent la transition de statut ; pas d'accusé signifie "non imprimé" | Nécessite la coopération du serveur d'impression |
| Job de réconciliation quotidien | Comparaison automatique la nuit, envoi de la liste d'exceptions par e-mail, escalade au-delà de 5 exceptions | 1 jour |
En plus : conservez des logs requête/réponse complets pendant au moins 90 jours. Ne vous plaignez pas du stockage. Quand un litige d'étiquette perdue atterrit sur votre bureau, ces logs sont votre preuve.
Une vraie question pour vous laisser : ce soir, allez vérifier combien de vos commandes ont frappé l'API d'étiquettes plus d'une fois le mois dernier. Ce nombre est la borne supérieure de votre population d'étiquettes fantômes. Vous risquez de perdre le sommeil — mais c'est toujours mieux que d'être réveillé par le service client.
Traduit de l'anglais. En cas de divergence, la version anglaise fait foi.