Lo diré desde el principio: cuando una actualización de WMS u OMS sale mal, rara vez el problema es el sistema en sí. El problema son las integraciones de terceros que nadie incluyó en el plan del proyecto.
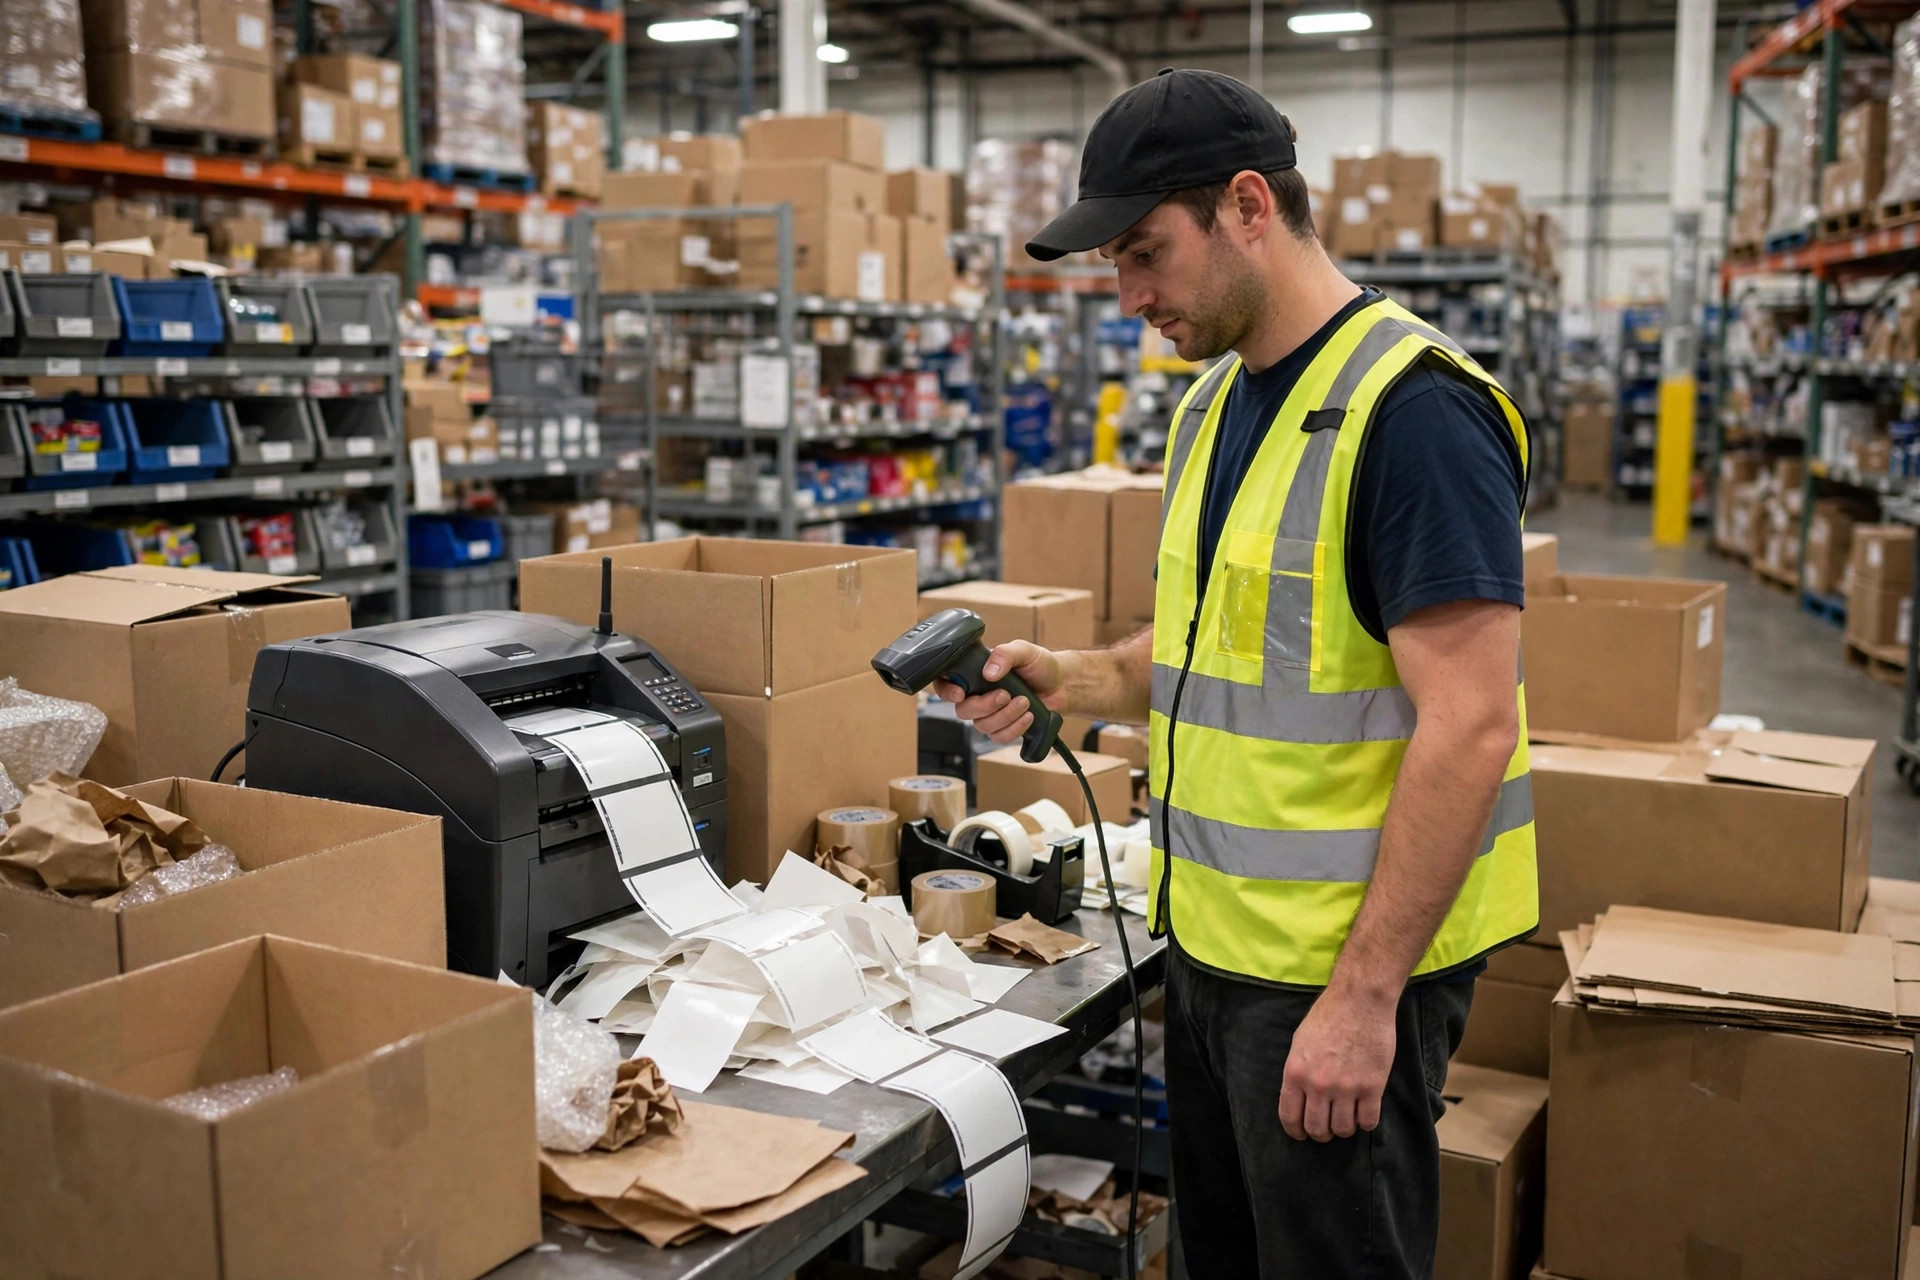
En 2024 estuve en una instalación 3PL de 120,000 pies cuadrados en Ontario, California, viendo cómo se desarrollaba un desastre de actualización de libro de texto. El almacén estaba dejando una versión del WMS que había usado durante casi una década. El equipo del proyecto había pasado tres meses preparándose: ensayos de migración de datos, capacitación de usuarios, recorridos de rutas de picking, de todo. El go-live era el lunes a las 8 a.m. A las 9 ya sonaban los teléfonos sin parar: las APIs de etiquetas de los transportistas habían dejado de funcionar en conjunto, miles de etiquetas de envío estaban atascadas en la cola de impresión y los operarios estaban de pie sin hacer nada con sus escáneres RF en la mano. La causa raíz, una vez que la encontramos, era casi insultante: la nueva versión había cambiado un campo del payload de confirmación de envío de opcional a obligatorio, y el middleware que hablaba con el servicio de etiquetas electrónicas del transportista había sido escrito cinco años atrás por un ingeniero que ya se había ido. Nadie en el plan de actualización sabía que ese código existía.
Habrían bastado diez minutos para arreglarlo, si alguien hubiera sabido dónde mirar.
Haz el inventario antes de tocar nada
Antes de que arranque cualquier actualización, hago que el equipo haga una sola cosa primero: convertir cada integración de terceros en una única hoja de inventario, sin excepciones. Las columnas son simples: nombre de la integración, contraparte (qué transportista, qué marketplace, qué ERP o TMS), protocolo, quién es dueño del código, cuándo fue la última llamada exitosa y a quién llamar cuando se rompe.
Esa columna de «última llamada exitosa» es donde están enterrados los muertos. Muchas integraciones parecen vivas en el papel pero están efectivamente muertas: una devolución de llamada de devoluciones de un pequeño transportista de hace tres años, un archivo nocturno de conciliación enviado a finanzas que nadie revisa. Las integraciones más peligrosas durante una actualización no son las que corren cada minuto; son las medio olvidadas. Nadie las recuerda, los planes de prueba no las cubren y, aun así, algún cron job a las 2 a.m. sigue invocándolas.
Hay un truco tosco pero brutalmente efectivo para construir este inventario: saca 90 días de llamadas de integración salientes de tus logs de producción y compáralos con la lista hecha a mano. Lo que no coincida es casi con seguridad algo que se te pasó. Cuando aquel almacén de Ontario hizo su post-mortem, este ejercicio sacó a la luz tres integraciones más que nadie recordaba.
Luego está el problema de la documentación. La documentación de las APIs de los proveedores coincide con el código que realmente corre quizá la mitad de las veces, si tienes suerte. No confíes en la documentación: confía en la captura de paquetes. Antes de la actualización, elige tus integraciones principales (creación de etiquetas, devoluciones de confirmación de envío, sincronización de inventario) y captura un ciclo real de solicitud-respuesta de cada una, campo por campo. Toma menos de un día y elimina la gran mayoría de las sorpresas del tipo «la documentación decía que funcionaba».
No apuestes el almacén a un único corte
Mi posición sobre la compatibilidad de integraciones es simple: nunca confíes en un corte total de golpe. Incluso el WMS más maduro puede cambiar reglas de campos, esquemas de autenticación o formatos de respuesta en una versión mayor. Donde las notas de la versión digan «retrocompatible», lo trato como marketing hasta que lo he probado yo mismo.
El enfoque fiable tiene tres partes, y saltarse cualquiera de ellas es buscarse problemas: pruebas de integración en sandbox, despliegue por fases y un plan de rollback que funcione de verdad.
Las pruebas en sandbox no significan hacer clic dos veces en el entorno de pruebas. Hay que reproducir tráfico real del negocio: toma pedidos de producción, elimina los datos sensibles y lanza el volumen de un día completo a través del sandbox. Observa si las etiquetas se imprimen, si las devoluciones al ERP tienen éxito, si los números de seguimiento vuelven a sincronizarse con los marketplaces. Si el volumen de tráfico es demasiado pequeño, los problemas quedan ocultos. Yo insisto en al menos un día completo de negocio de volumen reproducido, el doble para almacenes en temporada pico.
El despliegue por fases es una prueba de nervios y paciencia. Dirige el 10% del volumen de pedidos a la nueva versión, obsérvalo durante medio día y luego ve aumentando. A algunos les molesta la lentitud: «corta todo de una vez en una ventana nocturna, es más limpio». Más limpio, claro, hasta que una integración se rompe y todo el edificio se detiene. El trabajo extra de un despliegue por fases no es nada comparado con una parada total de la instalación.
Y la mayoría de los planes de rollback son ficción. Uno real responde tres preguntas: ¿cómo vuelven los datos (¿aceptará la versión antigua los documentos creados por la nueva?), ¿cómo vuelven las integraciones (¿dispararán las contrapartes devoluciones dobles cuando cambies de vuelta?) y quién puede decidirlo (a las 3 a.m., cuando algo pinta mal, ¿quién tiene la autoridad para decir «rollback» sin pasar por tres niveles de aprobación?). Si no puedes responder las tres, el plan es papel mojado.
El día del go-live, no mires la CPU de los servidores. Mira los signos vitales de las integraciones: tasa de éxito, tiempo de respuesta y distribución de códigos de error de cada integración principal. Una simple alerta sobre la tasa de éxito detectará nueve de cada diez fallos de integración mucho antes de que llegue la primera queja de un usuario.
Luego viene la parte que la mayoría de los equipos se saltan: la ventana de observación de una semana después del go-live. La mitad de todos los fallos de integración son retardados. El batch de conciliación financiera de fin de mes solo corre una vez al mes: podría no dispararse hasta semanas después de la actualización y fallar en su primera ejecución posterior. La sincronización de inventario de los marketplaces parece ir bien a volumen normal y solo se rompe cuando una promoción dispara el tráfico. Mi regla es simple: durante la primera semana después del go-live, dedica diez minutos cada mañana a revisar el informe de tasas de éxito de integración, prestando especial atención a los trabajos de baja frecuencia: ¿corrieron, dieron error? En la segunda semana puedes relajarte a un día sí y otro no. Solo después de un mes limpio doy la actualización por realmente terminada.
Escribe los criterios de aceptación antes de la actualización, no después. Los míos son tres líneas duras: tasas de éxito de las integraciones principales iguales o superiores al promedio de la semana previa a la actualización, sin ralentización notable en el flujo de extremo a extremo desde la impresión de la etiqueta hasta la confirmación del envío, y cero retrabajos manuales causados por fallos de integración en la primera semana. Si fallas en alguno, todavía hay cabos sueltos: no descorches el champán aún.
Un último trade-off que vale la pena nombrar: algunas integraciones legacy deberían reescribirse durante la actualización, no parchearse una vez más. He visto almacenes con middleware apilado en siete capas de arreglos históricos que nadie se atreve a tocar. Una actualización es una excusa rara y legítima para pagar de una vez esa deuda técnica. Te cuesta dos o tres semanas extra en el cronograma del proyecto, pero te compra años de dormir tranquilo por la noche. Haz los números a largo plazo.
Esto es lo único que puedes hacer mañana: entra en la consola de administración de tu WMS y exporta cada integración externa que se haya llamado en los últimos 90 días. Compárala con la documentación de integración que tengas archivada. Las que no coincidan son tus puntos de explosión más probables en la próxima actualización. Anota sus nombres: esa es la primera línea de tu lista de verificación de compatibilidad.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.