Veredicto por adelantado: un corte de red en el almacén es de dos tipos. Se cae el enlace entre los lectores RF y el WMS — a eso lo llamo un brazo roto. Muere el propio servidor del WMS — eso es un paro cardíaco. Un brazo roto se resuelve con el modo offline de los handhelds; un paro cardíaco solo se supera con tickets en papel más conciliación posterior. La preparación de pedidos y la recepción deben tener contingencia offline. Los dashboards y los reportes son un riesgo que se puede asumir: si se pierde esa apuesta, se miran después; la mercancía igual sale.
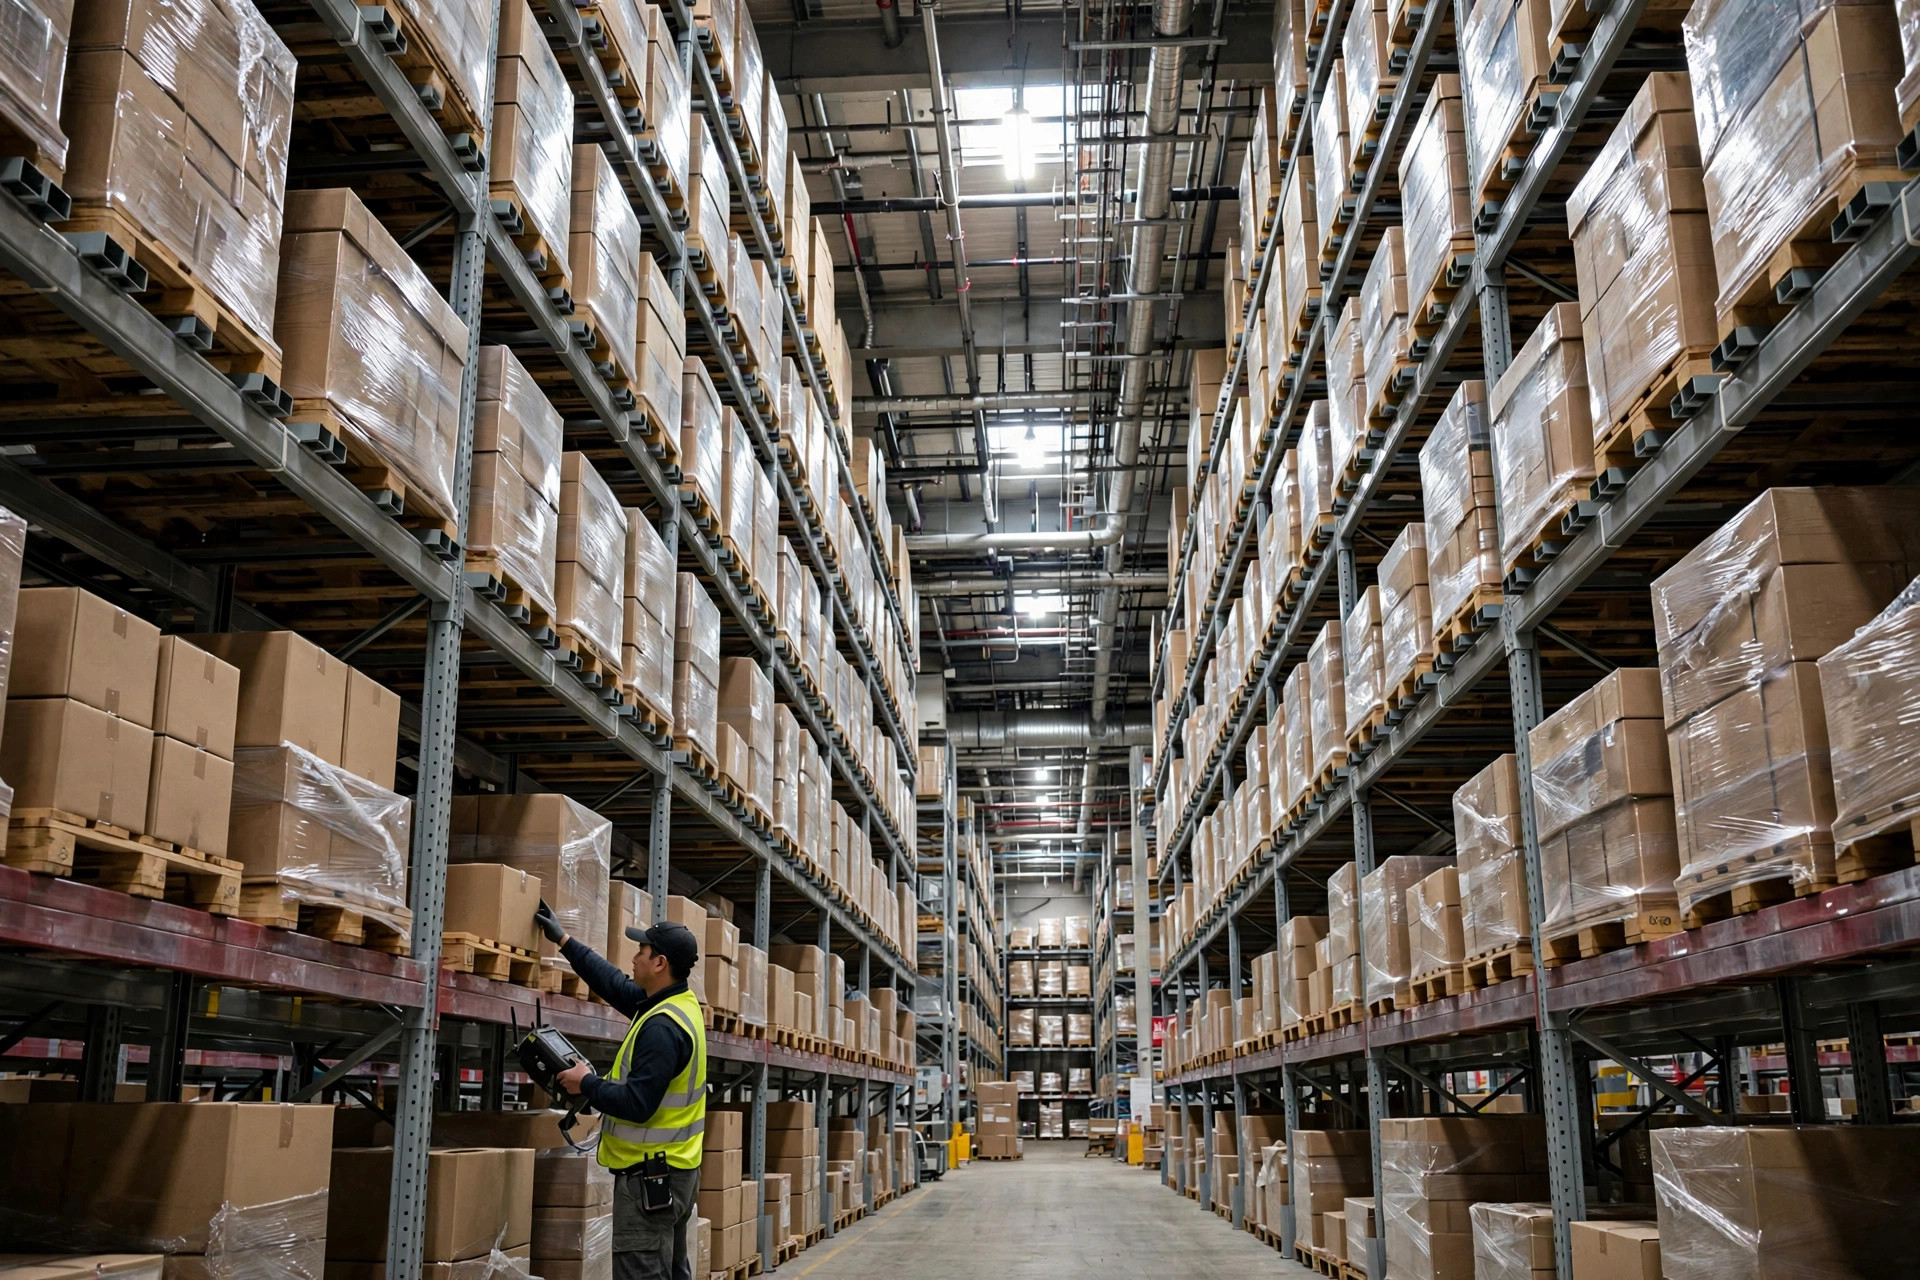
En 2021 estaba liderando una puesta en marcha de WMS en un almacén 3PL de 90.000 pies cuadrados en Ontario, California: 30 handhelds Zebra TC52 en planta, más de 4.000 pedidos de salida al día en temporada alta, todo movido por lecturas RF. Una tarde falló el aire acondicionado de la sala de equipos, el switch central se sobrecalentó y se reinició, y el WiFi se apagó durante 40 minutos. Cada pantalla de terminal se iluminó con «conexión fallida» mientras los preparadores se quedaban en los pasillos sin nada que hacer. Durante 40 minutos el almacén estuvo efectivamente parado — no por falta de mercancía, sino porque nadie sabía qué preparar ni dónde colocarla. Después de ese día, la contingencia offline entró en la lista de aceptación de cada proyecto WMS que toco. Sin contingencia, no hay puesta en marcha.
Cuando se cae la red, ¿los lectores RF pueden seguir escaneando?
Sí — pero solo si la aplicación del handheld tiene un verdadero modo offline, no el que aparece en la presentación comercial.
Muchos proveedores de WMS anuncian soporte offline cuando lo único que su aplicación móvil realmente almacena en caché es la pantalla de inicio de sesión, sin ningún dato de tarea guardado localmente. No tomes la demo al pie de la letra. Durante la aceptación, desenchufa y prueba: con la red caída, ¿puedes seguir haciendo picking, putaway y conteo cíclico por escaneo, con cada lectura guardada en el dispositivo? Si la respuesta es sí, eso es modo offline.
Dos cosas tienen que cumplirse para que funcione. Antes de empezar el turno, el sistema debe enviar a cada terminal las tareas de la ola del día, los datos maestros de ubicaciones y la biblioteca de códigos de barras de artículos — un dispositivo Android de clase Zebra TC52 almacena decenas de miles de registros de tarea sin sudar (consulta la documentación de tu proveedor para los límites exactos). Una vez que se cae la red, cada lectura queda sellada con fecha y hora y se encola localmente, y luego se sube en orden cuando vuelve la conectividad. Si falta cualquiera de las dos mitades, todo es teatro.
Aquí hay una trampa en la que caí de lleno. En Ontario, en cuanto volvió la red, 30 terminales volcaron sus lecturas encoladas al servidor a la vez y dejaron la interfaz de datos del WMS en timeout: aproximadamente la mitad de los registros nunca se escribió, y la otra mitad se escribió dos veces. Lo cerramos con dos configuraciones. Regulación de subidas en el lado del terminal — lotes escalonados, no una avalancha. Y controles de idempotencia en el lado del servidor — número de serie del dispositivo más marca de tiempo como clave única, duplicados descartados al llegar. Si esas dos no están en tu lista de aceptación, tu modo offline es decoración.
Reanudar desde el punto de interrupción es la misma idea aplicada a las tareas. Una ola de picking muere a mitad de un corte; cuando vuelve el enlace, la tarea debería continuar desde la línea interrumpida, no volver a descargar la ola completa. Eso significa que el progreso de la tarea se escribe localmente en tiempo real y la subida lleva un marcador de «líneas completadas». Pruébalo explícitamente durante la aceptación: corta la red en la línea 20, termina el resto offline, restaura, y comprueba si el sistema respeta esas 20 líneas. Si no, se devuelve.
Si el servidor muere de verdad, ¿cómo operas en papel sin caos?
Un servidor muerto está fuera del alcance del modo offline — los pocos datos en caché de un terminal no aguantan un turno completo. Ahí es cuando los tickets en papel toman el relevo. Pero el papel hecho sin cuidado es peor que quedarse quieto: una vez que los libros son un desastre, pasarás tres días desenredándolos después de la recuperación.
Tres cosas tienen que estar listas antes de que llegue el desastre, y las tres son innegociables. Tickets de picking de emergencia preimpresos, guardados en el armario de la oficina del supervisor. Cada línea de la plantilla lleva un espacio para código de barras — código de barras de ubicación, código de barras de artículo, campo de cantidad — siempre código de barras más dígitos legibles juntos. ¿Por qué? Porque durante el registro posterior, el administrativo puede escanear el papel en lugar de teclear los SKU a mano: más rápido, y muchísimos menos errores. En nuestro muestreo post mortem en Ontario, los tickets de SKU puramente manuscritos volvieron con una tasa de error de registro de 3 a 5 veces el nivel normal (medido en ese proyecto, aproximado); los tickets con código de barras salieron esencialmente limpios.
La numeración de tickets es la segunda pieza. Cada ticket de emergencia necesita un número único — algo como EMRG-fecha-secuencia. El supervisor registra a mano qué tickets se entregaron a quién y cuáles volvieron. Papel sin números significa que a la hora de conciliar nunca sabrás si un ticket se perdió, y un ticket perdido es un problema irresoluble.
La tercera pieza es la regla de las dos personas para el registro posterior. Después de que vuelve la red, una persona introduce los datos del papel en el WMS mientras otra verifica por muestreo alrededor del diez por ciento (aproximado — fija tu propia tolerancia). Hasta que el registro posterior termine, las ubicaciones afectadas quedan bloqueadas: ningún movimiento en vivo permitido. Mezcla transacciones en vivo con registro posterior y los libros nunca cuadrarán.
Una parte del plan B en papel se pasa por alto constantemente: la recepción. Con el servidor caído, no llegan ASN, así que la mercancía entrante va directo a un área de staging, registrada en papel por placa del remolque, conteo de piezas y marcas, con fotos. Las transacciones de recepción esperan hasta que el sistema vuelva. Esa área de staging tiene que estar marcada de antemano — no vayas a buscar espacio en el suelo en plena crisis.
Una vez que vuelve la red, ¿qué concilias primero?
Red arriba no significa operación normal. Yo trabajo tres cosas en un orden fijo, y el orden importa.
Primero las marcas de tiempo. Que las marcas registradas offline coincidan con la hora del servidor decide la secuencia de tu libro de inventario. Terminales y servidores deben sincronizarse a una fuente NTP; una deriva de unos minutos y los registros offline y online se intercalan mal, y las diferencias de conteo resultantes te volverán loco. Cuando acepto un diseño offline, deliberadamente desvío el reloj de un terminal 10 minutos, corto su red, y observo si el sistema lo detecta. Un diseño que no puede detectar eso no pasa la aceptación.
Segundo, duplicados y pérdidas. Exporta el registro de subida de la cola offline y compáralo línea por línea con la tabla de transacciones de inventario del WMS: ¿alguna lectura se escribió dos veces (brecha de idempotencia)? ¿Alguna lectura desapareció (timeout de subida)? Revisa primero picking y putaway — son los movimientos de alta frecuencia; recepción y conteo cíclico pueden esperar su turno.
Por último, el cierre del papel. Retira los tickets de emergencia uno por uno: tickets emitidos, tickets devueltos, tickets registrados — los tres números deben coincidir antes de darlo por terminado. Si falta uno, sigues el registro manuscrito del supervisor hacia abajo. Aquel corte de 40 minutos en Ontario tomó una tarde entera de conciliar (medido en el proyecto). Cuarenta minutos caídos, cuatro horas de conciliación — informa a dirección de esa proporción con antelación, o asumirán que todo está bien en cuanto vuelvan las barras del WiFi.
Y no informes de «recuperado» hasta que el informe de conciliación esté firmado. Mi regla: hasta esa firma, el estado del almacén se mantiene como «operaciones restringidas» hacia el exterior.
Tres cosas que puedes hacer esta semana
- Haz una prueba de desenchufar. Elige una ventana fuera de pico, apaga un AP en la zona de picking — o simplemente pon un terminal en modo avión — y mira si la aplicación puede terminar una ola offline con todos los datos intactos después de reconectar. En veinte minutos sabrás si el modo offline de tu WMS es real.
- Imprime 50 plantillas de tickets de picking de emergencia. Hazlas en el formato de código de barras más dígitos de arriba y guárdalas bajo llave en la oficina del supervisor. En el próximo corte de servidor, al menos tendrás papel.
- Sincroniza NTP en cada terminal y servidor. Entra en cada handheld, compara su reloj con el del servidor, y corrige cualquier deriva de más de un minuto. Es la inversión de contingencia más barata que jamás harás.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.