En 2019, trabajé en un go-live de WMS con un almacén 3PL en Ontario, California: 80,000 pies cuadrados, 12,000 SKU. En la primera semana después del corte, la tasa de errores de recogida saltó del 2% al 9%. El servicio al cliente quedó sepultado bajo las llamadas. El software funcionaba bien. Las integraciones funcionaban bien. Tras tres días de investigación, el equipo de implementación encontró el verdadero problema: los datos migrados del sistema antiguo. Más de 800 SKU no tenían código de barras, más de 300 tenían las unidades de medida hechas un desastre (cajas y unidades sueltas mezcladas) y unas 50 ubicaciones no coincidían entre el sistema viejo y el nuevo. El propietario gastó $400,000 en un sistema nuevo y quedó derrotado por un puñado de hojas de cálculo.
Mi veredicto, desde el principio: la limpieza de datos maestros es el trabajo de mayor retorno de cualquier proyecto de WMS. No cuesta casi nada, y si la omites, cada dólar que gastes después se irá en limpiar el desastre que deje. La mayoría de los retrasos de go-live que he visto no tenían nada que ver con el software. Eran problemas de datos.
Mucha gente cree que migrar datos es exportar una tabla. No lo es. Los datos del sistema antiguo están escritos para humanos; los datos del WMS están escritos para máquinas. Una persona lee "unas 2 cajas" y lo entiende. Una máquina no: las unidades equivocadas rompen el algoritmo de reposición, los códigos de barras ausentes paralizan el flujo de escaneo y las ubicaciones equivocadas envían las tareas a la nada.
Lista uno: datos maestros de SKU, cinco campos, sin excepciones
Los SKU son la parte más sucia de los datos maestros. Repasa esta lista punto por punto:
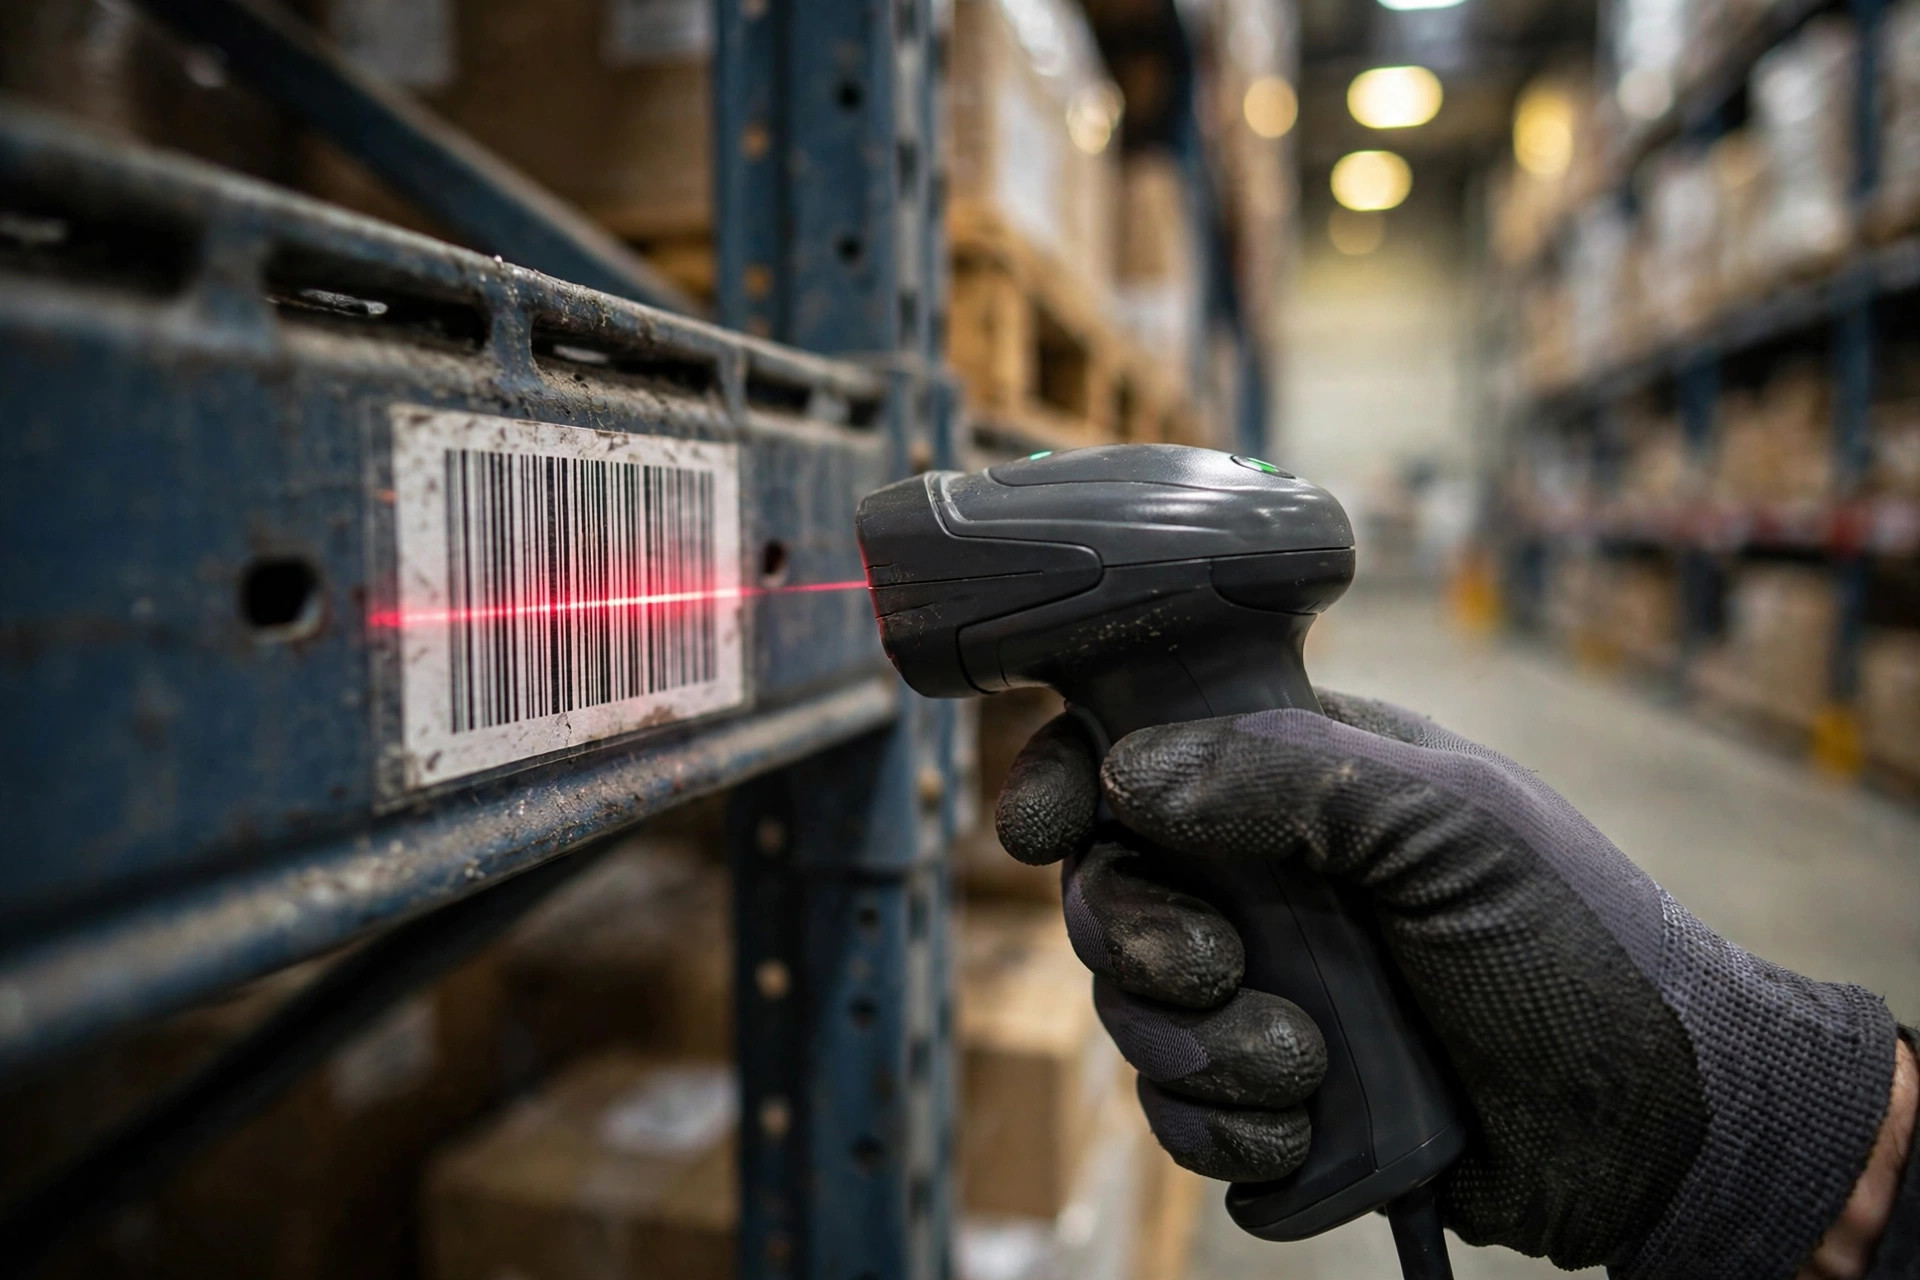
Códigos de barras. Cada SKU necesita al menos un código de barras escaneable, un UPC o un código interno. El peor caso que vi: 800 de 12,000 SKU sin código de barras, y la recepción se hacía a ojo mirando las cajas. La solución no tiene glamour pero funciona: cuatro semanas antes del go-live, saca todos los SKU sin código de barras y pégales una etiqueta de código de barras interno. No te digas que los "añadirás después del go-live". Después del go-live no tendrás tiempo de etiquetar nada.
Unidades y conversiones. Unidades sueltas, paquetes internos, cajas, palets: cada nivel necesita un factor de conversión. La trampa clásica es un SKU con varias unidades: compras recibe en cajas, ventas envía en unidades sueltas, y el sistema antiguo solo registraba cajas. Antes de importar al WMS, completa cada conversión "1 caja = 24 unidades", o cada cantidad de tarea de recogida saldrá mal.
Peso y dimensiones. Estos dos campos alimentan el cálculo de fletes y el slotting. Los SKU sin peso no se pueden usar en la optimización de carga; los SKU sin dimensiones rompen el cálculo de cubicaje del motor de reposición. El método práctico: pesa y mide 200 SKU representativos y estima el resto por familia de producto. Cualquier cosa es mejor que dejar los campos en blanco.
Atributos de lote y caducidad. Los almacenes de alimentos, farmacia y cosmética deben marcar si un SKU lleva gestión de caducidad. Este campo decide si el WMS activa la lógica FEFO, y cambiarlo después significa reconstruir el proceso.
Marcas de mercancías peligrosas. Los SKU con baterías o líquidos se marcan desde el principio: determina si pueden compartir zonas con mercancía general. Arreglarlo cuando ya aparece el jefe de bomberos es demasiado tarde.
Lista dos: datos maestros de ubicaciones, donde las ubicaciones fantasma son el asesino número uno
Los datos de ubicaciones son más traicioneros que los de SKU porque nadie los mira en el día a día. Tres puntos:
Un solo esquema de codificación. Los códigos de ubicación antiguos y nuevos deben mapear uno a uno. He visto un sistema antiguo usando "A-01-02" frente a uno nuevo que esperaba "A0102": la importación truncó los códigos y 300 ubicaciones simplemente no existían en el sistema nuevo. La tabla de mapeo necesita confirmación humana, línea por línea. No confíes en el script.
Atributos de ubicación. Cada ubicación se etiqueta: cara de recogida, almacenamiento a granel, zona de devoluciones o zona de excepciones. Si los atributos están mal, el sistema repondrá palets completos en un hueco de recogida de 6 pies donde físicamente no caben.
Elimina las ubicaciones fantasma. Las ubicaciones que existen en el sistema pero no en el almacén - o en el almacén pero no en el sistema - hay que recorrerlas antes del go-live. Mi método: dos equipos verificando en cruz. Una persona toma la lista del sistema y busca cada ubicación en el almacén; otra recorre el almacén etiquetando y conciliando de vuelta al sistema. Dos personas pueden recorrer 80,000 pies cuadrados en dos días.
Lista tres: saldos iniciales - mejor tres días lento que un registro equivocado
Una vez que los datos están dentro, los saldos de inventario tienen que estar bien. Mi regla de hierro: hacer un conteo completo de pared a pared antes del go-live, no un conteo por muestreo. Un 98% de precisión por muestreo suena bien, pero el 2% restante de diferencias detonará como excepciones de recogida en la primera semana.
Usa el conteo para hacer tres cosas a la vez: marca el stock muerto y liquida lo que puedas - no lleves datos basura al sistema nuevo; reetiqueta el inventario viejo con números de lote no estándar; y aísla todo lo que tenga menos de 30 días de vida útil restante para que salga primero después del go-live.
Mi cronograma habitual: empezar la limpieza de SKU en T menos 6 semanas, empezar el recorrido físico de ubicaciones en T menos 4, hacer el conteo completo y congelar datos en T menos 2 (después del congelamiento, el sistema antiguo solo envía, no recibe nada), y hacer el ensayo de migración en T menos 1. Para un almacén de 10,000 SKU, dos personas pueden terminar toda la limpieza en tres semanas. Compáralo con omitirla: al menos seis semanas de retrabajo después del go-live, más la confianza del cliente que quemes.
Lo que cuesta realmente omitirla
Volviendo a ese almacén de Ontario. Los datos sucios salieron en vivo, los errores de recogida llegaron al 9% en la primera semana, y en la segunda semana el cliente empezó a invocar las penalizaciones por precisión del contrato 3PL - la mayoría entran en vigor por debajo del 98.5%. En la tercera semana, el propietario detuvo toda la incorporación de nuevos clientes y asignó a dos personas a tiempo completo a tres semanas de retrabajo: reetiquetar códigos de barras, rellenar conversiones de unidades, recorrer cada ubicación.
El daño: más de $20,000 en mano de obra de retrabajo, más de $10,000 en penalizaciones, un mes de retraso del proyecto (otros $30,000 en honorarios de consultoría). Total superior a $60,000. La limpieza que omitieron habría costado menos de $10,000 y dos semanas. La limpieza de datos no es un costo. Es la póliza de seguro más barata de todo el proyecto.
Los datos necesitan un responsable
Las listas de verificación no sirven sin responsables. Nueve de cada diez esfuerzos de limpieza que se estancan lo hacen porque "todos trabajan en ello y nadie es el responsable". Mi reparto:
Los datos de SKU pertenecen a compras o al equipo de producto. Solo ellos saben cuántas configuraciones de empaque tiene realmente un SKU. Que el personal del almacén adivine desde una hoja de cálculo saldrá mal. Un responsable con nombre por familia de producto: su visto bueno significa que ese lote está terminado.
Los datos de ubicaciones pertenecen a las operaciones del almacén. Es su almacén; solo quienes lo recorren a diario pueden encontrar las ubicaciones fantasma. Los jefes de turno recorren, el consultor toma notas - no al revés.
Los saldos iniciales llevan doble firma de finanzas y del almacén. Los saldos iniciales en el sistema nuevo se convierten en los números iniciales de los libros contables. Si no cuadran, el cierre de mes será un infierno. La doble firma significa que operaciones es dueña de las cantidades y finanzas de los dólares.
Otra regla de hierro: el consultor de implementación aporta plantillas y reglas de validación, pero nunca es dueño de los datos. Pon en el contrato que la preparación de datos es responsabilidad del cliente, o cada retraso se convertirá en "los datos no estaban listos" - su tarjeta para salir de la cárcel.
Ensaya la migración: ejecútala dos veces antes de la real
Los datos limpios no van directo a producción. El movimiento estándar es dos ensayos:
Primera ejecución, muestra del 10%, revisando la lógica: códigos de barras duplicados, conversiones de unidad en blanco, códigos de ubicación que el sistema nuevo no encuentra. La validación puede ser vergonzosamente simple: un CONTAR.SI para códigos de barras duplicados en Excel, un BUSCARV contra el mapa de ubicaciones. Lo simple funciona.
Segunda ejecución, volumen completo, con cronómetro: 12,000 SKU más 8,000 ubicaciones - ¿cuánto tarda la importación y cuánto una reversión? Esos dos números definen la ventana de tiempo de tu noche de go-live. Mi estándar: importación completa más validación en menos de cuatro horas. Más que eso significa que los datos o el script necesitan trabajo antes de fijar una fecha de go-live.
Después del congelamiento en T menos 2, el sistema antiguo solo envía - sin SKU nuevos, sin cambios de ubicación. Dos semanas de recepciones nuevas van a un registro manual y se ingresan el primer día después del go-live. El aviso de congelamiento llega a cada persona afectada, y la firma en papel es lo mejor. Lo que más temes en un congelamiento es que alguien edite en silencio el sistema viejo - una edición allí es una diferencia en el sistema nuevo.
Una cosa que puedes hacer mañana: exporta tu tabla de SKU del sistema antiguo y fíltrala de tres formas: sin código de barras, sin peso, con múltiples unidades. Cuenta las filas en rojo. Ese número es la exposición real al riesgo de tu proyecto de WMS. Limpia primero esa tabla, y luego habla de fechas de go-live.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.