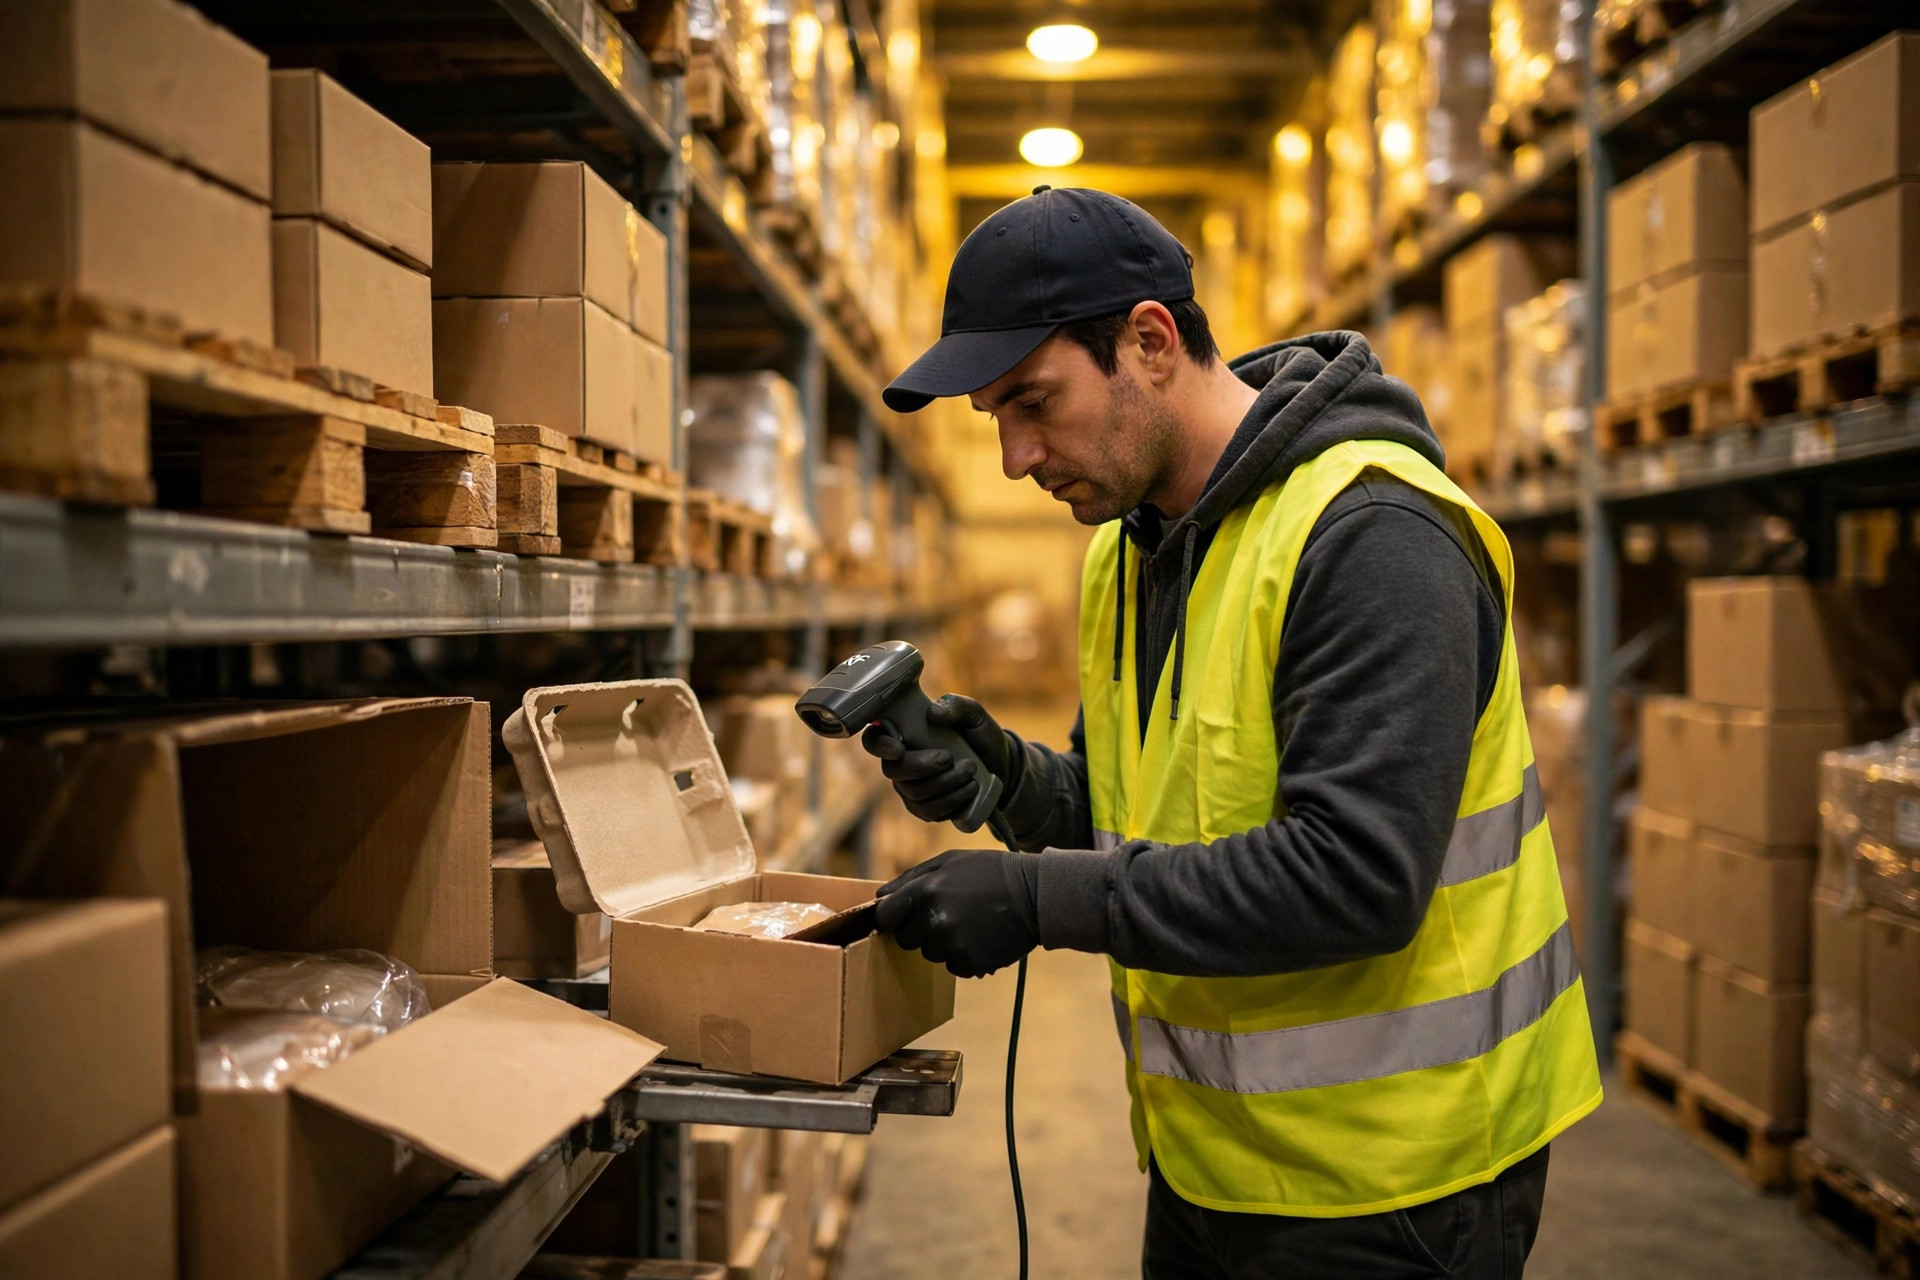
Noviembre de 2023, la semana antes de Acción de Gracias. Estaba en un almacén 3PL en Ontario, California, despachando 18,000 pedidos al día en temporada alta. A las 4 de la tarde, el gerente de operaciones me plantó una hoja de cálculo delante: 140 tickets de excepción en los primeros 20 días de noviembre — recogidas incorrectas, existencias que nadie podía encontrar, inventario que no cuadraba con los libros. El servicio al cliente se ahogaba en devoluciones y quejas. Tasa de error: 1.2%.
Su WMS había entrado en producción el año anterior, una implementación de seis cifras con muchas funciones. Pero la gestión de excepciones tenía un campo de «notas» — quien encontraba un problema escribía una frase en las notas, tomaba una foto y lo gritaba en un chat de grupo: «¿de quién son estas mercancías?»
Se puede imaginar el resto. Las notas se escribían, las mercancías seguían perdidas; el chat gritaba, y tres días después nadie lo recordaba. Un mes después cambiaron a una «hoja de responsabilidad de excepciones»: cada excepción entraba al sistema, fluía con un plazo, y escalaba automáticamente al vencerse. En enero de 2024, la tasa de error era 0.35%. Sin personal nuevo, sin sistema nuevo.
En veinte años de almacenes, he visto a demasiadas operaciones volcar dinero en estrategias de picking, algoritmos de oleadas y automatización mientras la gestión de excepciones sigue aparcada en «fase dos». Mi veredicto es contundente: sin gestión de excepciones de ciclo cerrado, su WMS es solo medio sistema.
Cuatro excepciones que todo almacén encuentra
Veinte años después, lo digo claro: el 90% de las excepciones cae en cuatro categorías. Conózcalas a fondo, y su sistema tendrá una oportunidad real.
Recogidas incorrectas. Artículo equivocado, cantidad equivocada, ubicación equivocada. El plato diario del almacén de e-commerce: producto de la ubicación A termina en la caja del pedido B. La raíz suele estar en el paso de confirmación de recogida — el escáner nunca leyó el código de barras de la ubicación, o lo leyó y el WMS se saltó la segunda comprobación. Cada pedido detectado en la estación de verificación cuesta 15–20 minutos de investigación inversa: quién lo recogió, qué oleada, qué queda en el estante.
Ubicación a ninguna parte. Recepción coloca el producto en una ubicación que no existe en el WMS, o en el nivel equivocado — el sistema dice nivel 4, la realidad dice nivel 2. En la siguiente recogida, el sistema envía a alguien a un hueco vacío, y el operario quema dos viajes averiguándolo. Esta es la que más desgasta porque nunca falla del todo. Solo ralentiza todo, invisible en todos los informes de gestión.
El sistema dice que hay stock, el estante dice lo contrario. La vieja fuente de cada diferencia de inventario cíclico. El WMS muestra 50 unidades en la ubicación A; el estante tiene 47. Las causas varían: una devolución tomada prestada antes del procesamiento de entrada, un daño no reportado, una recepción sobreregistrada sin ajuste. Una vez abierto este ticket, congele primero la ubicación — ajustar el inventario sin congelar solo planta una mina para la siguiente recogida.
SKU equivocado en la oleada. La más escurridiza de las cuatro: la planificación de oleadas mete un SKU en la oleada incorrecta, o una oleada sale con un SKU que no debería estar. Solo se detecta en verificación, y la mercancía ya preparada para carga tiene que deshacerse. El responsable no suele ser el operario sino el planificador de oleadas — por eso nadie se ofrece a reclamarlo.
Un ticket de excepción necesita cuatro estados en el WMS
Que las excepciones se cierren de verdad depende de una sola cosa: una cadena de estados completa en el sistema. Mi estándar para los clientes es cuatro estados, sin saltarse ninguno.
Creado. Quien lo encuentra lo crea, en 30 segundos. Recogedores, verificadores, receptores — todos tienen derecho a crear tickets. Un ticket necesita tres cosas: tipo de excepción, ubicación o SKU, y una foto. Sin foto, el revisor puede devolverlo directamente.
Reclamado. El ticket se enruta automáticamente a un responsable: las recogidas incorrectas van al líder de picking del turno, los errores de ubicación al equipo de ubicación, las diferencias de inventario al rol de control de inventario (IC). Ventana de reclamación: 2 horas. Si se vence, el ticket escala automáticamente al supervisor. Esta es la pieza clave de toda la cadena — los tickets sin escalado se pudren en el sistema.
Verificado. Otra persona verifica la corrección; quien la hizo no tiene la última palabra. Para una recogida incorrecta, el verificador recuenta la ubicación original — la cantidad cuadra, la ubicación cuadra, la foto está subida. Para una diferencia de inventario, el verificador extrae el historial de transacciones de ese SKU de los últimos 7 días y confirma que la explicación de la diferencia se sostiene. Verificar tu propia corrección no es verificación.
Cerrado. Solo después de que la verificación pasa. Cerrar requiere elegir un código de causa raíz: escaneo omitido, ubicación incorrecta, datos del sistema, problema de recepción aguas arriba, etc. Los códigos de causa raíz son para la dirección — saque el informe mensual, vea qué causa domina, y corrija esa primero el mes que viene.
En los cuatro estados, un ticket cuesta unas 25 minutos de mano de obra. Suena mucho, hasta que lo compara con un ticket pudriéndose en un chat de grupo durante tres días y resurgiendo como queja y reembolso. Esos 25 minutos son los 25 minutos más baratos del edificio.
Una hoja de responsabilidad que fija quién y qué tan rápido
La cadena de estados es el esqueleto; la hoja de responsabilidad es el músculo. Esta es la hoja que le di al almacén de Ontario — cópiela:
| Tipo de excepción | Creado por | Responsable | SLA | Estándar de cierre |
|---|---|---|---|---|
| Recogida incorrecta | Verificador | Líder de picking del turno | 4 horas | Recuento de la ubicación original, la cantidad cuadra con el sistema, foto de la ubicación subida |
| Diferencia de inventario | Contador cíclico / recogedor | Especialista de IC | 24 horas | Ubicación congelada, historial de transacciones de 7 días revisado, motivo de la diferencia y número de ajuste archivados |
| Error de ubicación | Receptor / recogedor que encontró el hueco vacío | Líder de ubicación | 8 horas | Producto movido a la ubicación correcta, código de barras de ubicación escaneado y confirmado, foto subida |
| SKU equivocado en oleada | Verificador | Planificador de oleadas / supervisor de turno | 4 horas | Oleada corregida o replanificada, pedidos afectados re-verificados |
La hoja se colgó en la pared de la oficina y en la página principal del módulo de excepciones del WMS. Al vencer el SLA, el sistema envía correo y mensaje de texto al objetivo de escalado automáticamente. Los líderes se quejaron una semana; un mes después, el tiempo medio de cierre de tickets bajó de 31 horas a 6.
Ahora calculemos el «impuesto de excepciones»
Un ticket promedia 25 minutos de mano de obra. Con salarios de almacén en California de $18–$22 la hora, digamos $20 — son $8.30 de mano de obra directa. Pero eso es solo la calderilla.
Una recogida incorrecta que sale del edificio: $8–$12 en flete de devolución, 10 minutos de tiempo de servicio al cliente, otra ronda de flete de salida para reenviar, y pérdida de clientes que ni siquiera se puede medir. Siendo conservadores, una excepción filtrada cuesta $40–$60 todo incluido.
El almacén de Ontario generaba 140 tickets al mes. Digamos que la mitad se filtraba, a $50 cada uno: $3,500 al mes, $42,000 al año. Ese es el impuesto de excepciones — lo paga lo presupueste o no, en quejas, reembolsos y horas extra.
Por eso llamo a la gestión de excepciones la prioridad número dos de cualquier puesta en marcha de WMS. La número uno es hacer que la recepción y el despacho funcionen. La número dos es el ciclo de excepciones. Los algoritmos de oleadas y las integraciones de automatización pueden esperar — cuanto más rápido corra su flujo principal, más rápido se filtran las excepciones, y sin un ciclo solo está poniendo un turbocompresor a su tasa de error.
Olvide el pensamiento de «fase dos». Dos cosas mañana por la mañana: primero, configure tres tipos de tickets de excepción en su WMS — excepciones de recogida, diferencias de inventario, errores de ubicación. Hasta tres tipos vencen a un chat de grupo. Tipo, foto, responsable, plazo — ponga esos cuatro campos en marcha. Segundo, imprima la hoja de responsabilidad y cuélguela en la pared: quién crea, quién reclama, qué tan rápido se cierra, qué cuenta como cerrado — cada línea clavada.
Y una pregunta para llevar a casa: el mes pasado, ¿cuántas excepciones tuvo su almacén — y cuántas se cerraron de verdad frente a las que quedaron olvidadas en silencio? Saque ese número y sabrá exactamente cuánto impuesto de excepciones pagó.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.