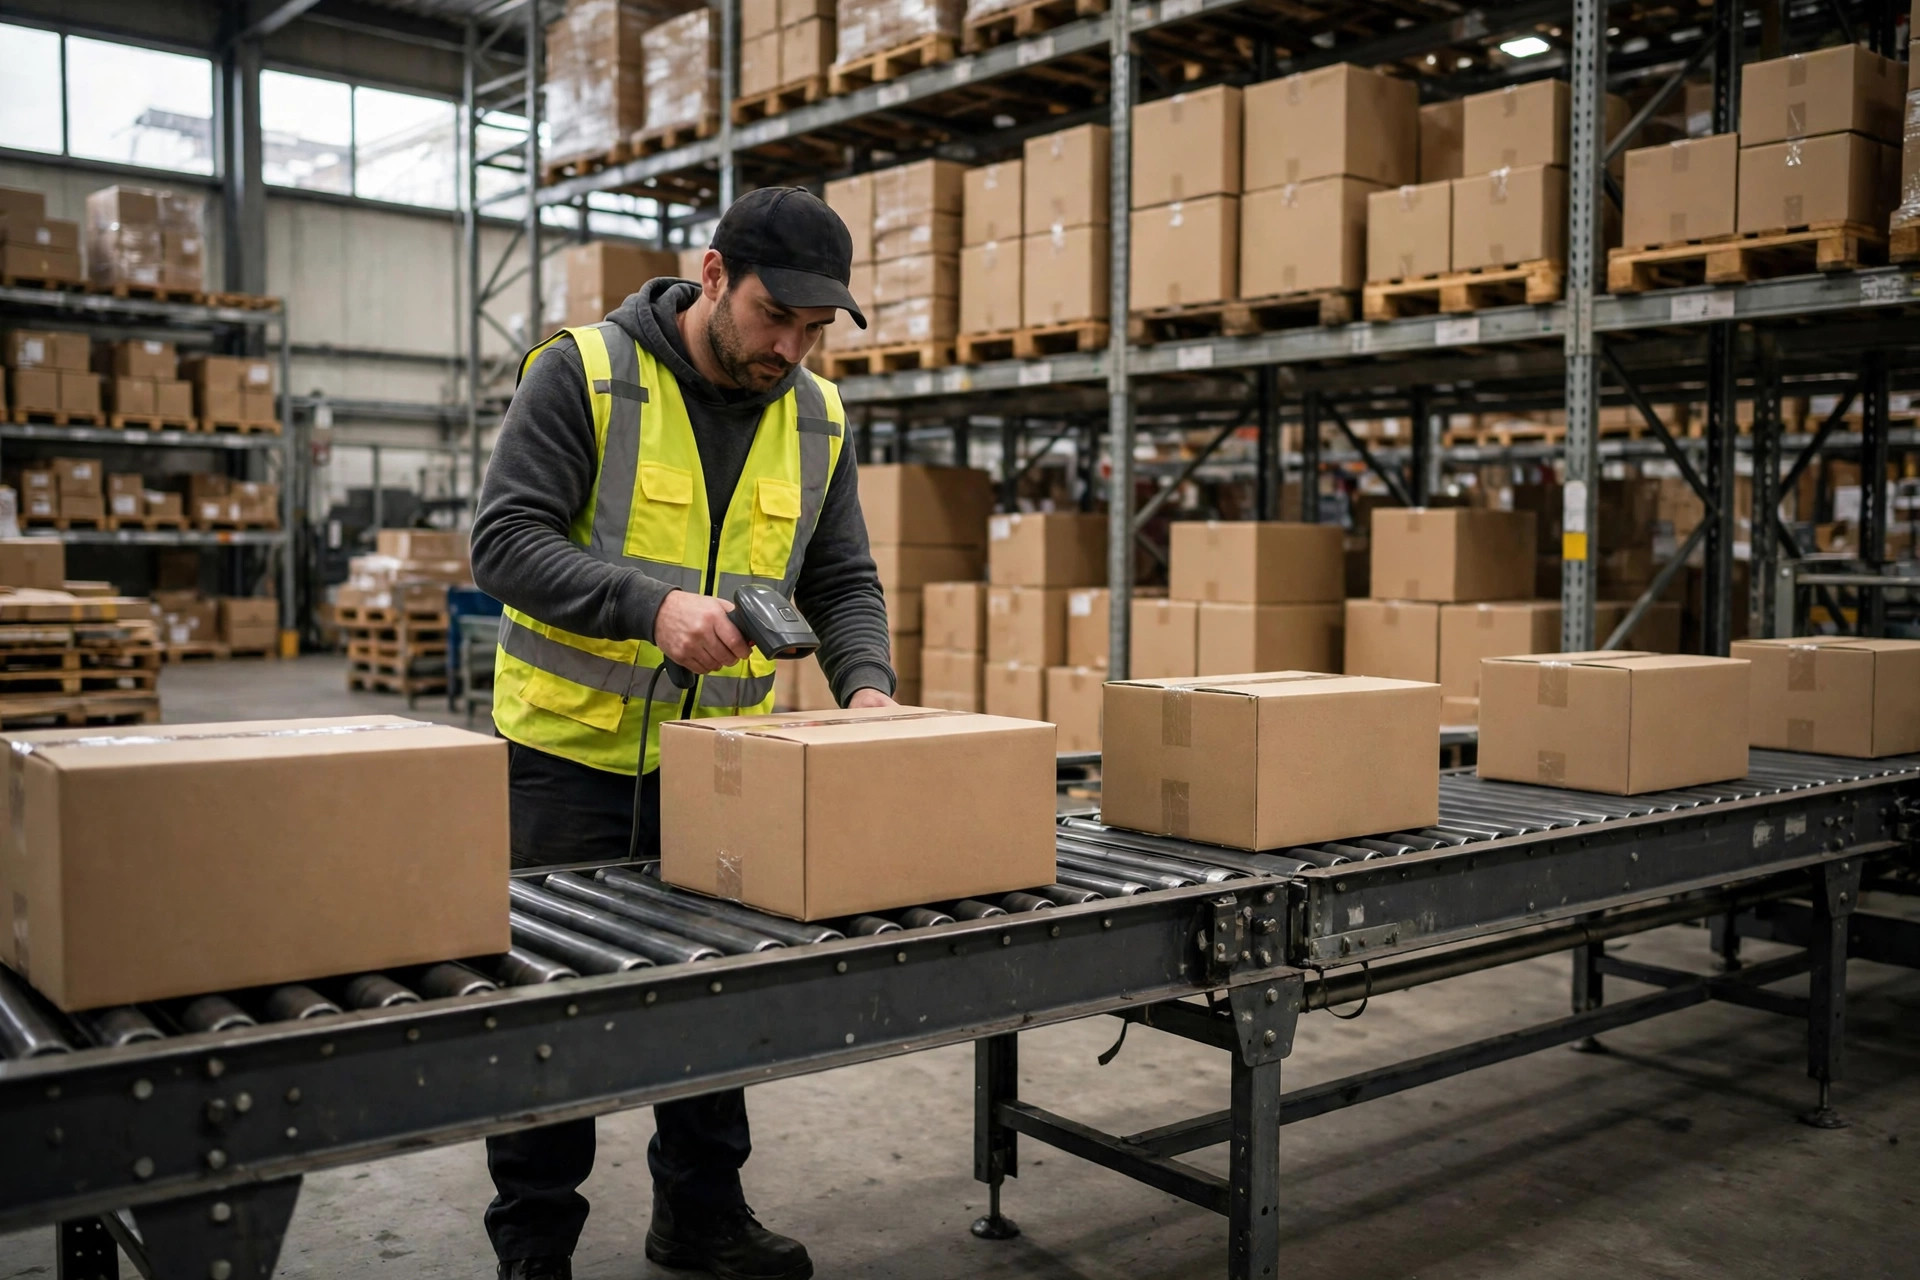
Cuando un almacén se prepara para salir en vivo con un WMS, el paso más subestimado rara vez es la elección del software. Es la limpieza de datos. Las demos de los proveedores siempre se ven fluidas, pero en el momento en que entran datos reales al sistema, la verdad sale a la luz: un producto con tres códigos de artículo, registros de ubicaciones que aún enumeran estanterías desmanteladas hace meses, una cantidad por caja escrita como 24 cuando la caja física contiene 20. Un sistema no puede juzgar qué fila es correcta. Solo puede ejecutar errores más rápido y de forma más exhaustiva que la hoja de cálculo a la que sustituyó.
Los proveedores de implementación llevan años diciendo esto en retrospectivas públicas: una gran parte de los retrasos en la salida en vivo se deben a los datos maestros, no a funciones que faltan. Hay una regla aproximada en el sector, que un error en un sistema heredado se convierte en una cadena de errores en uno nuevo. La regla no tiene una base estadística rigurosa, pero su dirección es correcta. Un WMS vincula inventario, asignación de tareas y facturación a los mismos registros maestros, así que un solo campo desalineado se propaga aguas abajo. Tratar la higiene de los datos maestros como una puerta formal de salida en vivo, en lugar de una tarea para la noche anterior al lanzamiento, es una de las decisiones más baratas que puede tomar un proyecto.
En el otoño de 2024, un almacén de terceros en la provincia de Zhejiang que gestiona pequeños electrodomésticos se preparaba para pasar de hojas de cálculo y una herramienta heredada a un WMS. Su catálogo superaba los 8,000 SKU, y un recuento de existencias de muestra halló que aproximadamente uno de cada diez sufría de codificación duplicada: la misma tetera eléctrica llevaba un código para los canales en línea, otro para los canales fuera de línea y un tercero asignado por un cliente contratista. Tras la salida en vivo, las tareas de picking se emitían por código, así que tres códigos se trataban como tres productos distintos. El stock parecía abundante en pantalla, pero los operarios descubrían a mitad de una oleada que perseguían las mismas mercancías con números distintos. La línea se detuvo durante dos días mientras el equipo reconstruía las reglas de fusión de códigos. La lección no es complicada. Los códigos duplicados en la era de la hoja de cálculo solo parecían desordenados. En la era del WMS, detienen la línea.
Qué cubre realmente la limpieza de datos: cinco archivos maestros
El alcance de la limpieza puede mantenerse concreto. Cinco archivos maestros cubren la mayor parte. Los datos maestros de artículos van primero en términos prácticos: un producto físico conserva un código principal, y cualquier otro código se convierte en una correspondencia, con el historial preservado en lugar de eliminado. Campos de especificación como modelo, variante y color necesitan una única convención de nomenclatura, no abreviaturas en unas filas y nombres completos en otras. Los datos maestros de ubicaciones siguen: código de ubicación, tipo de ubicación y posición física deben corresponderse uno a uno, y las estanterías desmanteladas o los pasillos renumerados deben eliminarse de la tabla al mismo tiempo que cambian en planta. Las unidades de medida y las configuraciones de caja forman otro archivo: la cadena de conversión de cada unidad a caja y a palé debe revisarse línea por línea, ya que los errores de cantidad por caja están entre las fuentes más comunes de discrepancias en recepción. Los códigos de barras son otro: los códigos de caja interior, caja exterior y palé del mismo producto no deben repetirse ni intercambiarse, y las pruebas de escaneo deben cubrir cada segmento de código. Los saldos de inventario son el último archivo, y el más difícil: el saldo del sistema, el recuento físico y los registros financieros deben conciliarse antes del lanzamiento, no arrastrarse al nuevo sistema como una discrepancia inicial.
Los saldos tienden a dejarse para el final del calendario, por razones comprensibles. Un recuento completo detiene la línea, necesita mano de obra y obliga al equipo a enfrentarse a desórdenes heredados. Pero lanzar con un saldo poco claro entrega al nuevo sistema un punto de partida falso, y cada análisis de variación posterior se acumula sobre él. Un enfoque viable clasifica las discrepancias en tres bandas: los artículos cuya fuente puede rastrearse se ajustan en el acto; los artículos que no pueden rastrearse pero son pequeños en cantidad y valor van a una lista de vigilancia bajo seguimiento separado; los artículos que no pueden rastrearse y son grandes deben resolverse antes de la salida en vivo. Los umbrales de esas bandas deben quedar por escrito con antelación y firmados tanto por el gerente del almacén como por finanzas, no decididos solo por el consultor de implementación.
Congelación y delta: el ritmo de la limpieza de datos antes de la salida en vivo
La limpieza también tiene una dimensión que los proyectos suelen pasar por alto, que es el ritmo. Los datos no se mantienen limpios una vez lavados. El almacén sigue recibiendo, expidiendo y devolviendo mercancías cada día, y los registros recién limpiados se ensuciarán de nuevo con negocio nuevo a menos que se congelen. La práctica común es fijar un punto de congelación: después de él, los cambios en datos maestros solo pasan por un formulario de aprobación, cada cambio entra en una lista delta, y la lista delta se carga en bloque en el nuevo sistema el día del lanzamiento. Una ventana de congelación de una a dos semanas suele bastar. Alargarla mucho más y los equipos de negocio empiezan a sortear el proceso con cambios informales, lo que crea datos sucios nuevos.
Un almacén de comercio electrónico en Guangdong se topó exactamente con esto a principios de 2025. El equipo había limpiado sus datos un mes antes del cambio, pero no fijó ningún mecanismo de congelación. Tres días antes del lanzamiento, operaciones añadió más de 200 productos nuevos para afrontar una promoción, sin pasar por la aprobación de códigos, y los nuevos artículos entraron directamente en el sistema heredado. El día del lanzamiento, el nuevo sistema no tenía configuración de caja para esos productos, y la recepción se paralizó durante medio día. La retrospectiva añadió una regla: durante la ventana de congelación, solo el administrador de datos maestros crea códigos de artículo nuevos. Los equipos de negocio pueden solicitar códigos, pero no los crean. La regla parece burocracia extra. En la práctica, pone el delta en un solo par de manos.
Igualmente merece la pena decidir con antelación qué debe corregirse antes de la salida en vivo y qué puede esperar. Los elementos que bloquean flujos esenciales pertenecen al primer grupo: códigos duplicados, configuraciones de caja faltantes, ubicaciones inexistentes, códigos de barras repetidos, saldos sin conciliar. Corregirlos después del lanzamiento significa detener la línea. Los elementos que afectan a la granularidad de informes y a las dimensiones estadísticas pertenecen al segundo grupo: categorías de artículos demasiado generales, campos de marca faltantes, información histórica de lotes incompleta. Esos no bloquean la recepción ni la expedición y pueden ir a una lista de gobernanza posterior al lanzamiento. La línea divisoria tiene una única prueba: ¿hará que un trabajador de primera línea se detenga a mitad de tarea durante el trabajo normal?
La factura del retrabajo: por qué la limpieza de datos sale más barata cuanto antes se hace
El coste del retrabajo puede estimarse con un marco sencillo. Un error detectado durante la preparación cuesta aproximadamente medio día de tiempo de una persona corregirlo. El mismo error detectado durante las pruebas arrastra repeticiones de casos de prueba y revisiones de material de formación, multiplicando el coste varias veces. Detectado en la semana de lanzamiento, trae paradas de línea, verificación manual y explicaciones a clientes, multiplicando el coste de nuevo. Detectado un mes después del lanzamiento, el error ya se ha extendido por pedidos, registros de stock y facturas, y la limpieza es la más cara. La tabla siguiente da múltiplos relativos, no estadísticas precisas. Los múltiplos exactos varían según la operación, pero la dirección ascendente es consistente.
| Etapa de descubrimiento | Consecuencia típica | Coste relativo | | --- | --- | --- | --- | | Preparación | Un registro maestro corregido | 1x | | Pruebas | Registro corregido más pruebas de regresión | De 3x a 5x | | Semana de lanzamiento | Parada de línea más verificación manual | Alrededor de 10x | | Un mes después del lanzamiento | Rastreo entre documentos más ajustes de facturas | 20x o más |
Este marco lleva a un juicio contraintuitivo: depurar los datos maestros hasta dejarlos cien por cien limpios a menudo no es el mejor uso del esfuerzo. Algunos registros históricos conciernen a productos descontinuados o clientes que ya no operan con el almacén, y el gran trabajo dedicado a esos registros rinde poco. Un objetivo mejor es defectos casi cero en los elementos que bloquean el lanzamiento, con el resto colocado en una lista de gobernanza posterior al lanzamiento para trabajarla durante aproximadamente tres meses. Perseguir una limpieza absoluta alarga el calendario de lanzamiento, y un calendario que se alarga erosiona la paciencia del lado del negocio con el proyecto. El objetivo de la limpieza no es la perfección. Es un suelo operativo sobre el que el trabajo de primera línea pueda correr sin tropezar.
Una tendencia merece atención. En los últimos años, los módulos de gobernanza de datos maestros han aparecido con más frecuencia en las descripciones de producto de los proveedores de WMS, a veces como funciones independientes, a veces dentro de kits de implementación. Eso sugiere que el sector ha reconocido que los fallos de salida en vivo están pasando de carencias de funciones a carencias de datos. Mirando hacia adelante, la calidad de los datos puede convertirse en una dimensión de evaluación discreta en la selección de sistemas de almacén: antes de comprar un sistema, pregunte si sus datos pueden alimentarlo directamente. Si la respuesta es no, el presupuesto del proyecto debe reservar dinero y tiempo para la limpieza desde el principio, en lugar de descubrir en vísperas del lanzamiento que no se puede pasar la puerta de datos. Si los compradores empezarán a puntuar a los proveedores por la honestidad con que evalúan la preparación de datos, en lugar de por la fluidez de sus demos, es una pregunta abierta, y la respuesta dará forma a cómo se venda la próxima ronda de implementaciones.
Por Dr. Chen, Investigador de la Cadena de Suministro Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.