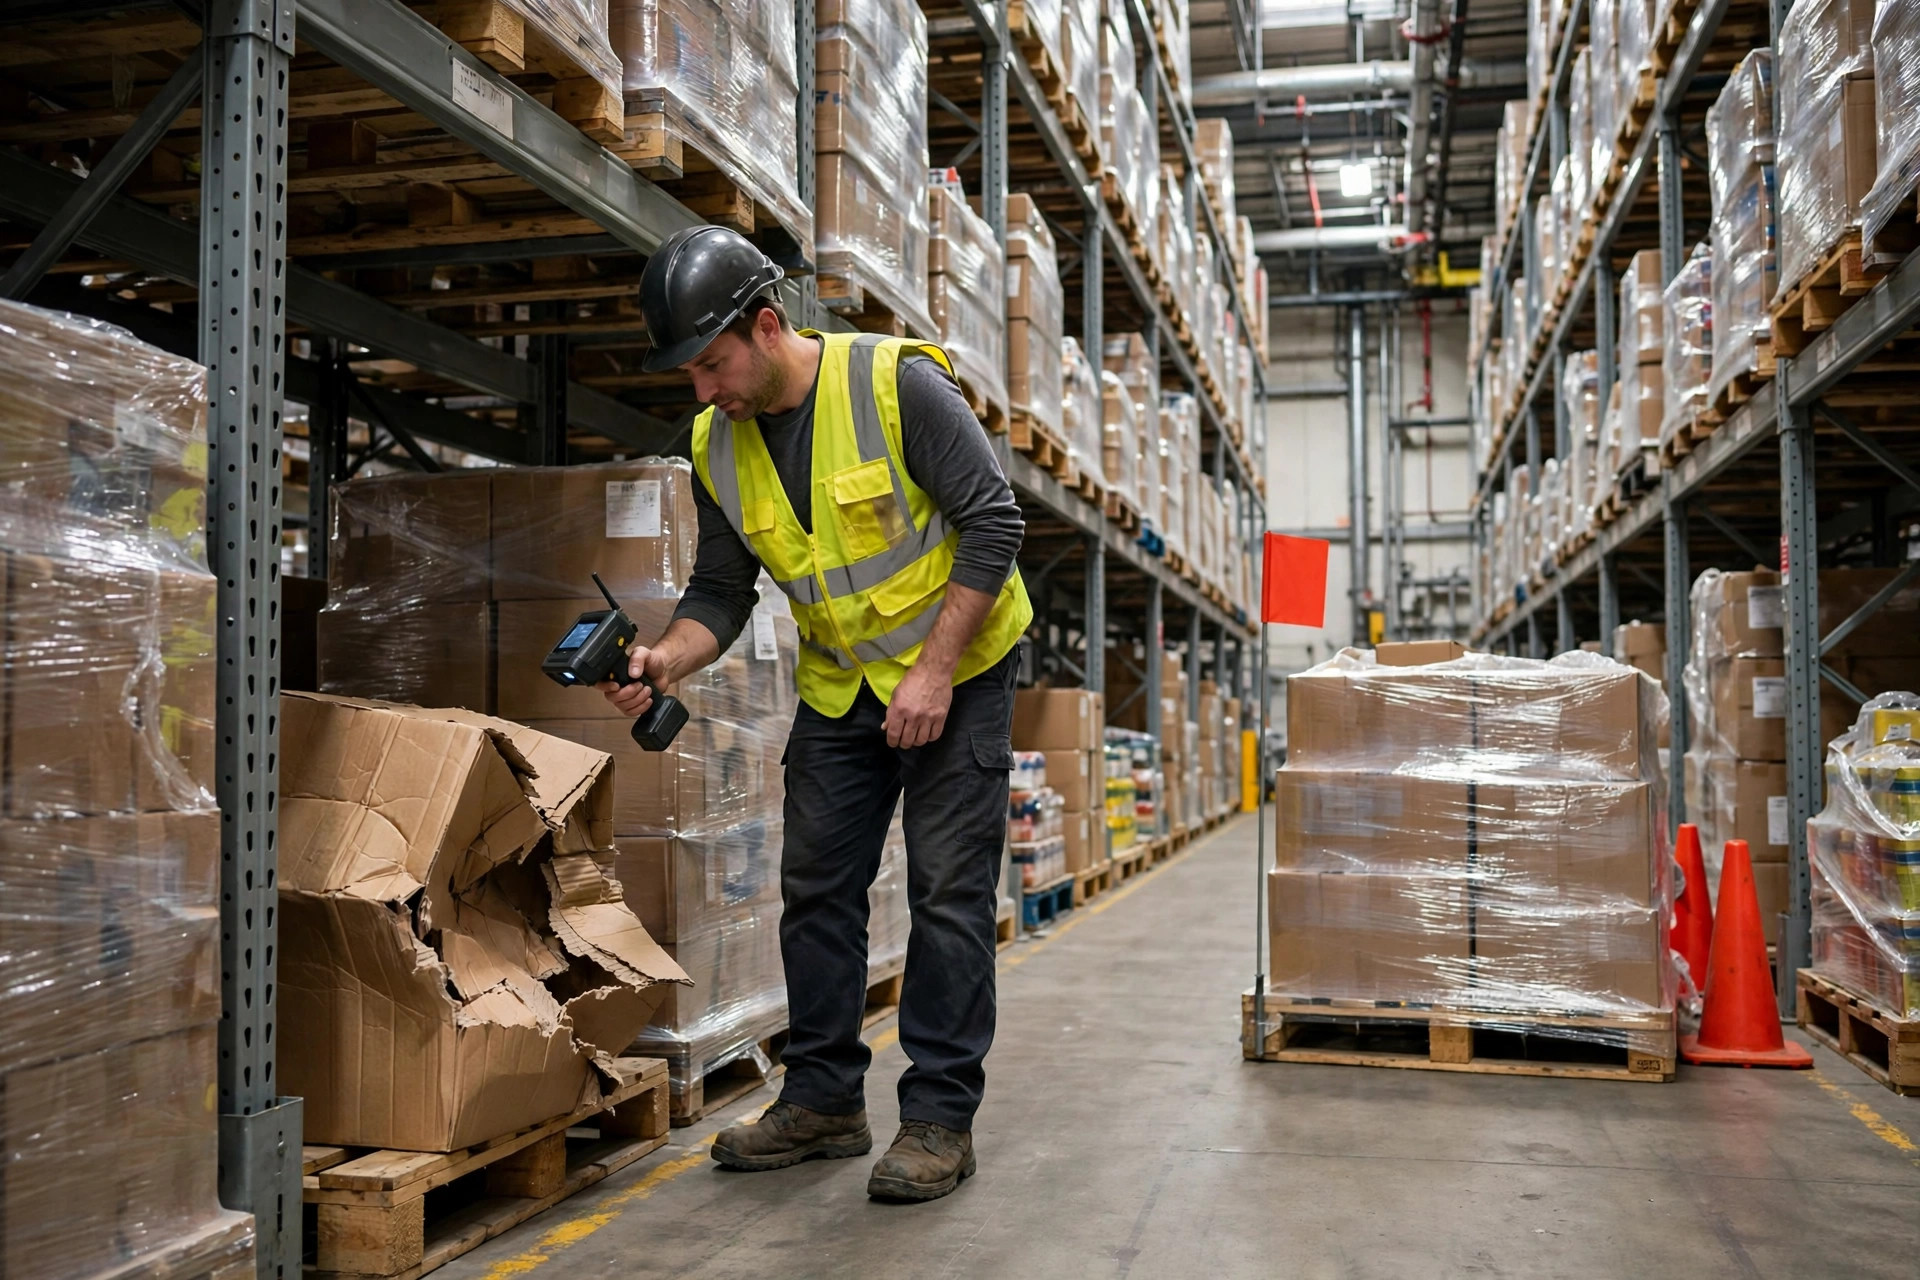
Era una mañana de miércoles de marzo de 2024, y yo estaba en un almacén 3PL de 120,000 pies cuadrados en Ontario, California, viendo cómo su WES recién instalado procesaba su primera ola de un día pico. Un operario empujaba su carro por el pasillo C-07, se detenía frente a una ubicación y miraba fijamente su escáner RF. La tarea decía doce unidades. La ubicación tenía siete, y las etiquetas no coincidían con lo que había en el hueco. Tecleó "short pick" y devolvió la tarea al sistema.
Esa parte era normal. Lo que pasó después, no.
El sistema, queriendo ser "servicial", devolvió la tarea directamente a la cola de la ola. Veinte minutos después, otro operario recibió la misma tarea, caminó hasta la misma ubicación y se topó con el mismo muro. Al mediodía, la tarea había pasado de mano en mano entre tres o cuatro operarios, con short pick cada vez, y la luz de consolidación de la ola se negaba a ponerse en verde. Todo el lote de salida quedó esperando en el muelle mientras el camión del transportista pitaba fuera — todo por una unidad que nadie podía encontrar.
El responsable del almacén, de pie junto a mí en el muelle, me dijo algo que nunca olvidé: "Nos costó una fortuna este sistema, y lo que mejor hace es reenviar problemas que no puede resolver."
La mayoría de los almacenes se defienden bien despachando tareas a través de su WES. Lo que de verdad marca la diferencia es lo que pasa después de que una tarea falla — cómo el sistema la captura, la devuelve, la reasigna y cierra el círculo. De eso va este artículo: la mecánica del reflow para las tareas de excepción.
La tarea volvió a la ola. ¿Y después qué?
Empieza por clasificar las excepciones en grupos. En veinte años he visto siempre las mismas cinco, una y otra vez: short picks (stock insuficiente), stockouts (no hay nada en absoluto), unidades dañadas o con marca de calidad, desajustes de escaneo (etiqueta errónea, ubicación errónea) y retenciones de calidad a la espera de liberación por QC. Este paso parece trivial, pero es donde mueren muchos almacenes — configuran treinta códigos de motivo, los operarios con prisa tocan el primero que ven, y cada informe posterior es basura.
Para las rutas de reflow, me quedo con tres. Ni una más.
Primera: de vuelta a la cola de la ola. Encaja con excepciones que otro operario u otro momento pueden resolver — por ejemplo, un short pick donde ya viene en camino la reposición. Pero limita el número de veces. En aquel centro de Ontario, la misma tarea hizo reflow cuatro veces en una mañana. Mi regla: tras tres reflows, la tarea se convierte automáticamente en una tarea manual. No te obsesiones con la configuración. Una ola que no puede consolidarse cuesta mucho más.
Segunda: convertir a tarea manual. Esto es para excepciones que requieren juicio humano — daños, retenciones de calidad. El punto clave: "manual" no puede significar "tirado en una cola que nadie mira". Dirígela a un equipo — los daños van a QC, los desajustes de ubicación al equipo de auditoría — y mantenla visible en el RF, no invisible dentro del sistema.
Tercera: suspender. Esto es para lo temporalmente irresoluble — un problema de lote esperando confirmación del proveedor, por ejemplo — donde tampoco puedes permitir que bloquee la ola. Suspender no es eliminar: necesita una condición clara de reactivación y un tiempo máximo de suspensión, tras el cual se escala automáticamente.
El trade-off es real. Refluir a la ola es lo más barato, pero se arriesga el juego de la patata caliente. Las tareas manuales son lo más fiable, pero la cola manual no para de crecer. Suspender es lo más limpio, pero es fácil olvidarse. Mi enfoque: predefinir la ruta por defecto según el motivo de excepción, de modo que el operario solo seleccione un código de motivo y el sistema enrute por regla. Deja el juicio en manos de las reglas, y el trabajo físico en manos de la gente.
¿Cuánto puede estar sin tocarse antes de convertirse en un problema real?
El reflow es solo el paso uno. El verdadero agujero negro es una excepción que se queda en el sistema sin que nadie la mire.
Recomiendo dos niveles de escalado — no cinco, nadie se acuerda de cinco. Nivel uno: treinta minutos después de creada la excepción sin que nadie la tome, escalar al jefe de turno — ventana emergente en el RF más alerta en la terminal del jefe. Nivel dos: si la excepción está bloqueando la consolidación de la ola, con otras tareas esperando por ella, escalar en quince minutos, directo al supervisor.
Fíjate en que he dicho ventana emergente y alerta en terminal, no correo. En esto me he quemado: un almacén tenía unas reglas de escalado preciosas que enviaban un correo al supervisor en cada tiempo límite. El supervisor recibía más de cuarenta correos del sistema al día y hacía tiempo que había montado una regla de archivado automático. Una caja dañada estuvo en la jaula de excepciones tres días, hasta que un cliente se quejó de una falta. Escalar es robarle la atención a alguien. El correo no puede robarla, así que necesitas algo más ruidoso.
Aquí también hay un trade-off. Si aprietas demasiado el umbral, tienes fatiga de alarmas — los jefes se insensibilizan. Si lo aflojas demasiado, las excepciones expiran en silencio. Mi práctica: empezar apretado los dos primeros meses para sacar a la luz los problemas reales de proceso, y aflojar cuando las cosas se estabilicen. Y una cosa más: registra quién reconoció o tomó la excepción y cuándo. Sin eso, cada post-mortem termina en un juego de culpas sin marcador.
Has registrado todos estos datos de excepciones. ¿Qué miras realmente?
Muchos almacenes registran montañas de datos de excepciones del WES, y luego abren el informe y encuentran "312 short picks" — técnicamente cierto, totalmente inútil. Registra los datos, pero registra los datos correctos.
Registra al menos ocho campos por excepción: número de tarea, SKU, ubicación, código de motivo, marca temporal, responsable, contador de reflows, disposición final. Mantén los códigos de motivo en ocho a diez. Más, y nadie selecciona con cuidado; menos, y el post-mortem no muestra nada. Mi conjunto habitual: short pick, stockout, dañado, etiqueta errónea, confusión de ubicación, retención de calidad, fallo de equipo, otro. Si "otro" supera el quince por ciento, tu lista de códigos está incompleta — añade códigos.
Tres números bastan para la revisión. Olvida la presentación de veinte diapositivas.
Primero, los cinco SKU con más reflows repetidos. Un SKU que hace short pick una y otra vez es casi siempre un problema de slotting o de reposición, no un problema del operario. En aquel centro de Ontario, el SKU patata caliente resultó tener el stock de seguridad por debajo de su volumen medio diario de picks. La reposición nunca se ponía al día.
Segundo, el porcentaje de excepciones que vencen sin cerrarse — observa la tendencia. Si sube, tu capacidad de gestión manual no aguanta el volumen de excepciones. Añade gente o arregla el proceso.
Tercero, los cambios en la mezcla de códigos de motivo. Si "etiqueta errónea" se duplica en un mes, lo más probable es que cambiara el proveedor de etiquetas o que la formación de los nuevos contratados flojeara. Los datos son el síntoma; el proceso es la causa.
Aquí tienes una lista de verificación para contrastar con tu puesta en marcha del WES o tu revisión: ¿hay más de diez códigos de motivo? ¿Hay un tope de reflows? ¿Las excepciones que bloquean la ola tienen su propio reloj de escalado? ¿El escalado depende solo del correo? ¿Las tareas suspendidas tienen una edad máxima y una condición de reactivación? ¿Tus informes pueden sacar los cinco SKU con más reflows repetidos? Si todo esto está bien, tu reflow de excepciones está básicamente sólido.
Volviendo a aquel miércoles. El almacén de Ontario limitó después los reflows a tres, con conversión automática a tarea manual de auditoría en el cuarto — y esa clase de problema cayó en picado en dos meses. Pero aquí va la pregunta que te dejaría: saca los datos de excepciones del mes pasado de tu almacén — ¿qué porcentaje de tareas hizo reflow más de dos veces? Si ni siquiera puedes sacar ese número, entonces por muy elegante que se vea tu diseño de reflow, es decoración.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.