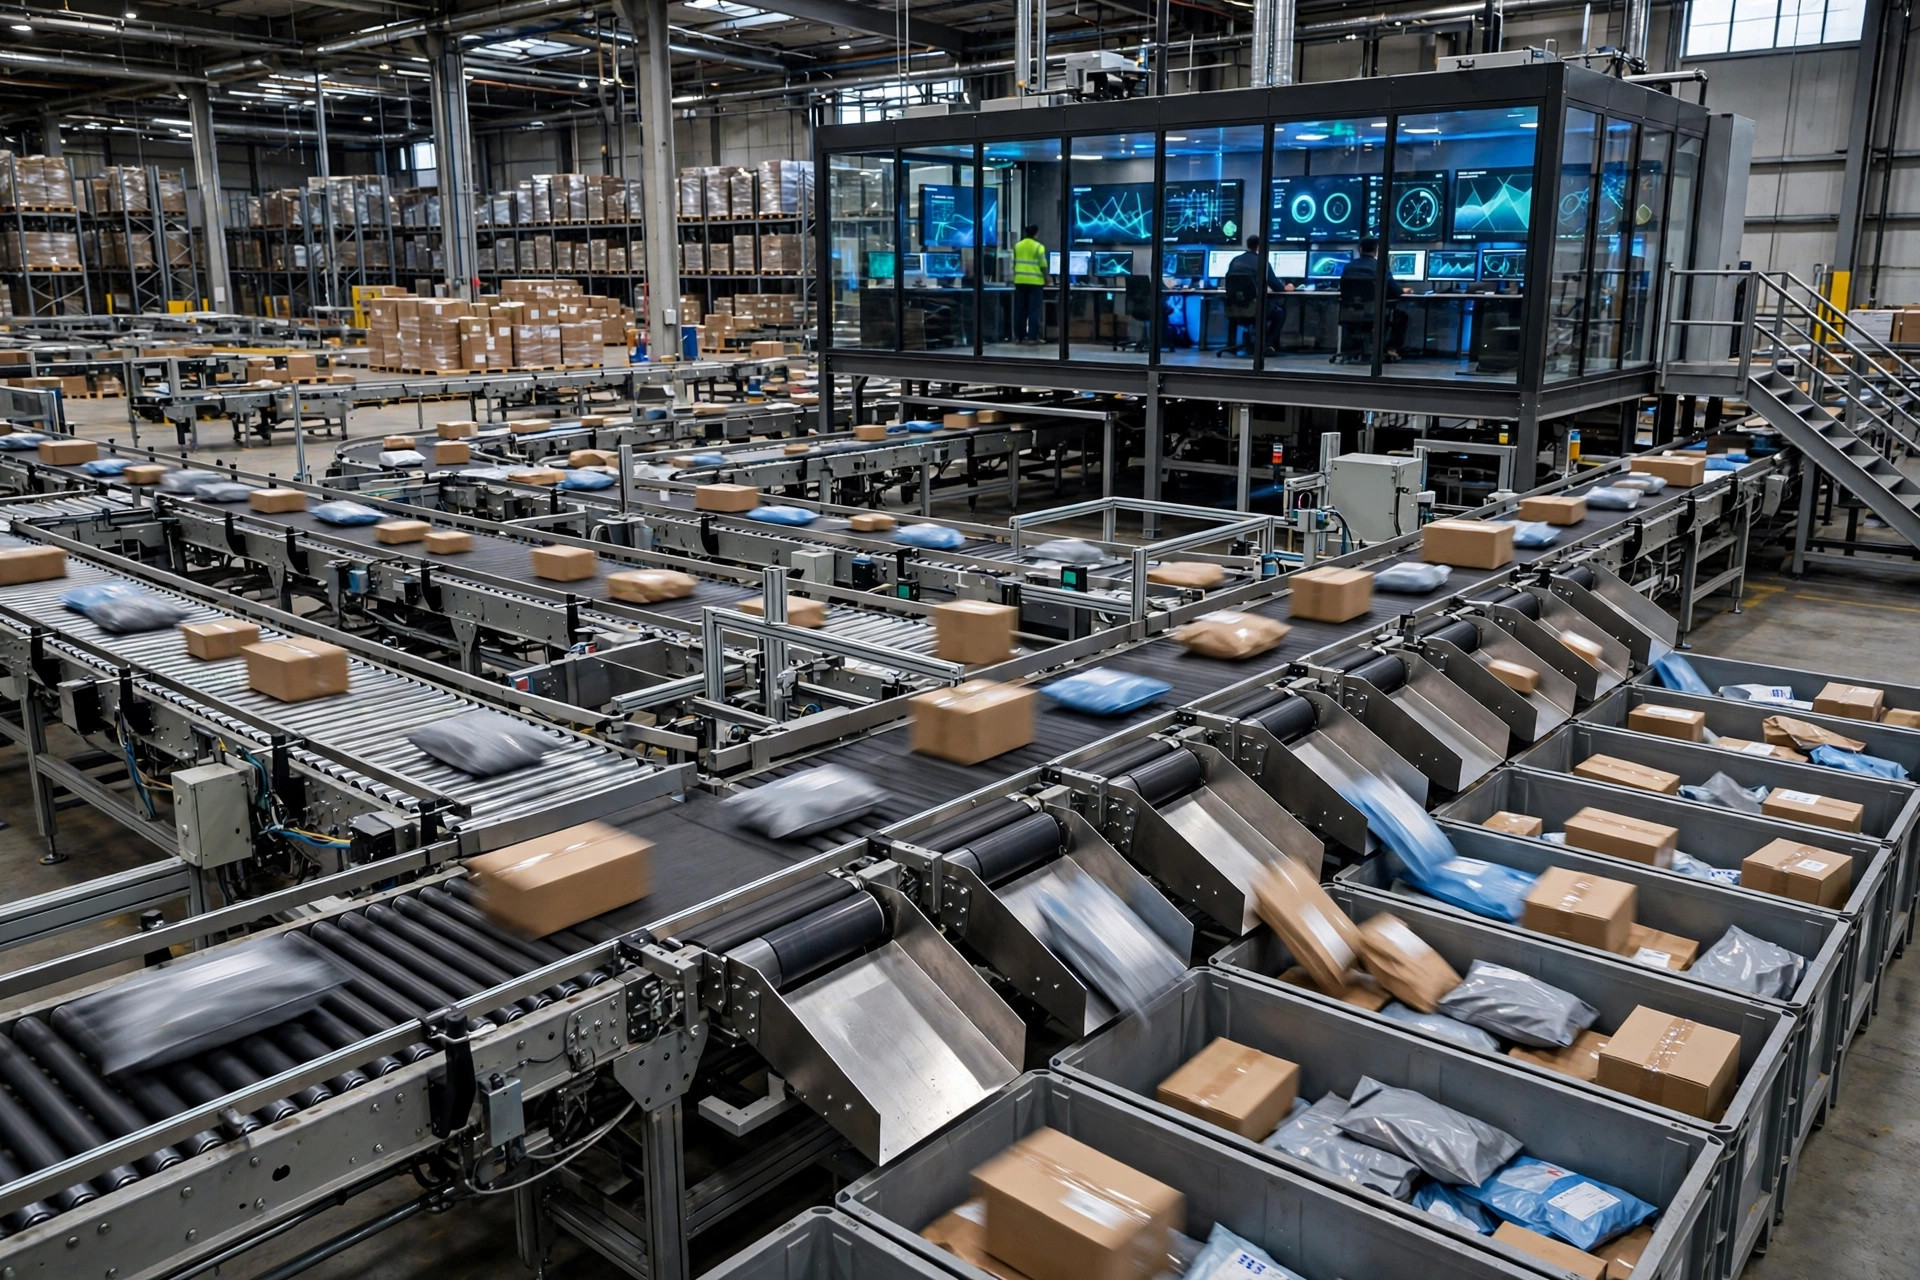
Permítanme empezar con un número que todavía duele: 47 segundos — ahí empezó nuestro peor error de juicio ante un timeout de tarea del WCS.
El pasado noviembre, una caja quedó parada en un desvío de nuestra cinta transportadora de segunda mano durante 47 segundos. El WCS lo declaró un timeout de tarea y lanzó una tarea de reemplazo. Pero la caja no estaba atascada: un fotoojo polvoriento en el desvío simplemente tardaba en reaccionar. La segunda tarea ordenó al empujador desviar la misma caja otra vez, directo al conducto equivocado. Era un pedido urgente. El cliente en Los Angeles esperaba la ubicación en estantería. Pagamos flete urgente y perdimos una tarde buscando una sola caja.
Operamos un almacén de 3,000 metros cuadrados. No podemos permitirnos quemar dinero así. Desde ese día, desarmé por completo nuestro desastre de timeouts del WCS y lo volví a armar. Esto es todo lo que aprendí.
Primero, nuestra situación: cinta transportadora de segunda mano, elevador reacondicionado y un solo AMR nuevo, comprado a plazos. El estándar de las grandes empresas de respuesta de equipo en milisegundos no existe en nuestro mundo. El heartbeat de nuestro PLC usado se duerme de vez en cuando, el WiFi que cruza dos filas de estanterías ralentiza todo, y el AMR puede tardar segundos en confirmar cualquier cosa. Los valores por defecto del WCS asumían equipo nuevo. En nuestro almacén, gritaba timeout una docena de veces al día, y nueve de cada diez eran falsas alarmas.
Los umbrales de timeout de tarea del WCS copiados de los grandes no les servirán
Al principio intenté ser perezoso y copié una tabla de timeouts recomendada por la industria de nuestro integrador. Solo empeoró: la cinta transportadora agotaba el tiempo en 5 segundos y gritaba lobo todo el día, mientras el AMR recibía 30 segundos y el WCS se quedaba esperando tontamente cuando realmente se atascaba.
Luego invitamos a nuestro integrador a tomar algo, y fue entonces cuando por fin lo entendí: un timeout del WCS no es una sola cosa. Son tres capas.
La capa uno es el heartbeat: ¿está vivo el equipo? El heartbeat de un PLC normalmente late cada 1–3 segundos. Si se pierden tres seguidos, el dispositivo está básicamente fuera de línea. Esta capa no tiene nada que ver con las tareas: es solo un registro de presencia.
La capa dos es el ACK: ¿llegó la tarea? El WCS envía una tarea y el equipo dice lo recibí. Una cinta transportadora cableada debería confirmar en 5 segundos: ese es su trabajo. Un AMR por WiFi está bien dentro de 15. Nuestro elevador de segunda mano a menudo necesita 8–10 segundos para confirmar. El estándar de las grandes empresas dice timeout de 5 segundos; nosotros pusimos 12. No hay vergüenza en eso. El equipo es lo que es.
La capa tres es la confirmación de finalización: ¿está hecho el trabajo? Esta es la importante. Una tarea de cinta transportadora puede tardar 1–2 minutos desde el envío hasta que la caja cae en su conducto. Un movimiento de AMR entre zonas puede tardar 5. El umbral de esta capa debe seguir el tipo de tarea: no hay una talla única.
Esta es la tabla por niveles en la que quedamos. Róbela y ajústela:
| Equipo | Timeout de ACK | Timeout de finalización | Notas |
|---|---|---|---|
| Segmento de cinta transportadora | 8 sec | 90 sec | PLC usado, heartbeat que se duerme, margen para el ACK |
| Elevador | 12 sec | 120 sec | Mecánica lenta, la velocidad se reduce a la mitad con carga pesada |
| AMR | 15 sec | 300 sec | WiFi a través de estanterías, las tareas entre zonas reciben tiempo real |
El punto: los umbrales siguen la condición física de su equipo, no una respuesta estándar. Si todo su equipo es nuevo, reduzca estos a la mitad.
Timeout de tarea: ¿reintentar o esperar? Verifique tres cosas primero
Incluso con buenos umbrales, ocurren timeouts: el equipo tiene humores. La pregunta mortal es qué sigue: ¿reenviar o esperar?
Aprendimos esto por las malas. El 18 de noviembre de 2025, alrededor de las 9 PM: nuestro AMR tomó una tarea para mover un palé desde recepción hasta el vestíbulo del elevador. Confirmó en el vestíbulo y esperó el elevador. Luego el WiFi se cayó durante 40 segundos. El trabajo se hizo: solo que el mensaje de hecho nunca llegó.
El WCS no vio confirmación de finalización en 30 segundos, declaró un timeout y envió un segundo AMR (un alquiler de temporada alta) a mover el mismo palé. Cuando volvió el WiFi, la unidad uno reportó tarea completada justo cuando la unidad dos llegaba. Dos robots rodearon un palé. Luego la unidad dos hizo su trabajo: levantó el palé con las horquillas, avanzó dos pasos, encontró su camino bloqueado por la unidad uno y dejó el palé en el carril de incendios.
Esa noche: cuatro personas, dos horas de retrabajo; un carril de incendios bloqueado y una multa por poco del parque industrial; un AMR de alquiler que cobra por hora, quemando tres horas por nada. Después hicimos las cuentas: esa sola noche costó más que añadir dos puntos de acceso WiFi en todo el almacén.
La causa raíz en una frase: una tarea que ya había recibido ACK fue tratada como nunca ejecutada y reenviada. Desde entonces, cada timeout pasa por un marco de decisión pegado junto a nuestra pantalla de control: clasificar primero, luego actuar:
Primero, ¿volvió el ACK? Sin ACK significa que el equipo nunca recibió la tarea, probablemente una falla de comunicación. Reenviar es seguro. Pero verifique primero el heartbeat: si el dispositivo ya ni siquiera está registrando presencia, cien reintentos no ayudarán. Envíe a un humano a mirar el equipo.
Segundo, ¿la tarea es reentrante? Consultas y sincronizaciones de estado: reenvíe libremente. Pero cualquier cosa que haga mover al equipo (transporte, desvío, empuje), si ya recibió ACK una vez, asuma que podría estar haciéndolo ya y nunca reintente automáticamente. El WCS no sabe hasta dónde llegó el trabajo. Reenviar empujar la caja A al conducto 3 cuando el empujador ya la empujó, y el segundo empuje podría golpear a alguna caja inocente B detrás.
Tercero, mire la ola. ¿La carga atorada amenaza el corte de la ola? Si no, espere. Si sí, escale a un humano. No detenga toda una línea por una caja que nadie tiene prisa por recibir.
Nuestra solución barata: un pool de tareas con timeout en una tableta retirada
La respuesta de las grandes empresas son gemelos digitales y retrofits de idempotencia: seis cifras. No podemos quemar ese tipo de dinero. Nuestra solución costó menos de $500.
Tomamos una tableta retirada, la montamos junto a la cinta transportadora y pusimos exactamente una pantalla en ella: el pool de tareas con timeout. Las tareas con timeout ya no reintentan automáticamente. Caen en el pool y se ponen rojas.
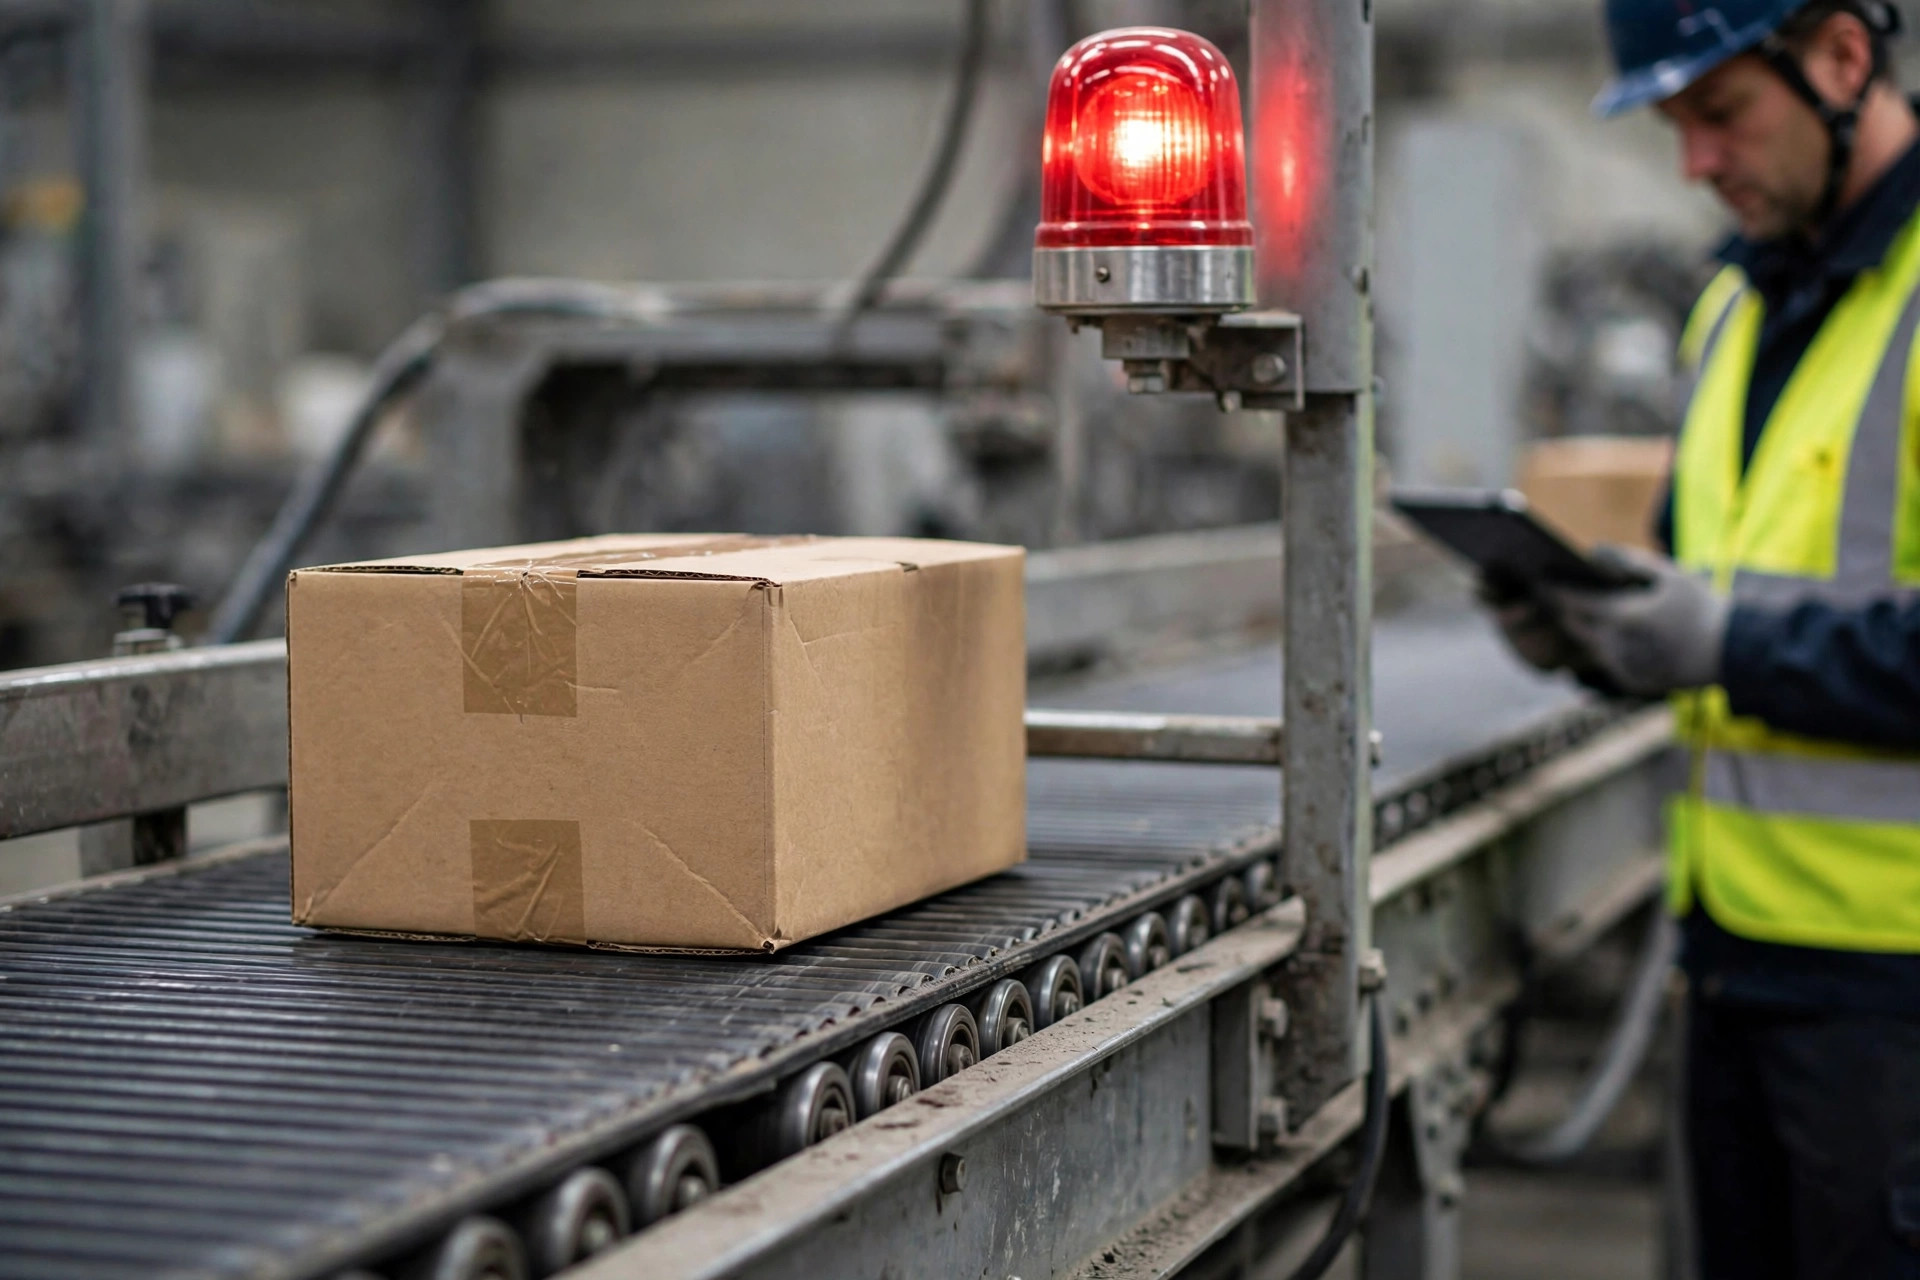
El trabajo del operador es muy simple: ver rojo, caminar, mirar. Los problemas de cinta transportadora se ven a simple vista: ¿realmente atascada o solo lenta? Realmente atascada: toque manejo manual, la tarea pasa a un humano. Solo lenta: toque seguir esperando, y el WCS duplica la ventana de finalización. El equipo nunca recibió la tarea en absoluto: toque confirmar reenvío.
Un mes después de que esa humilde pantalla salió en vivo, los reenvíos falsos pasaron de una docena al día a cero. Unas 20 horas al mes de caza de envíos erróneos, desaparecidas. $500. Valió la pena.
Nuestro SOP de timeout, el pegado en la pared de la sala de control
Una vez que la solución barata funcionó, la escribimos como SOP y la pegamos en la pared:
L1 — automático: solo las tareas sin ACK con heartbeat sano pueden reintentar automáticamente, máximo 2 intentos, con intervalos crecientes (30 segundos, luego 60). ¿Sigue sin nada? Escalar a L2.
L2 — confirmación humana: cualquier tarea con ACK pero sin finalización va al pool de timeout, y un operador confirma en sitio dentro de 5 minutos. El equipo ya lo hizo → el WCS marca completado. Nunca se ejecutó → el humano toca reenviar.
L3 — bloquear el carril: el mismo equipo agota el tiempo 3 veces en una hora, o dos veredictos L2 seguidos de falla de equipo: bloquear el carril, llamar a mantenimiento, y el WCS desvía las tareas a un carril de respaldo si existe.
Y una regla de hierro: el WCS nunca puede disparar dos comandos de ejecución para la misma tarea dentro de 30 segundos. Esa regla se compró con esa noche de noviembre. Está en la configuración ahora, y nadie puede cambiarla.
Una conclusión contraintuitiva: los umbrales de timeout más cortos no son más sensibles. Un umbral de gatillo fácil es un supervisor nervioso gritando por todo. Bombardee a los operadores con falsas alarmas durante un mes y aprenderán a ignorar cada alarma, incluidas las reales. La historia del pastorcito que gritaba lobo se repite en los almacenes a diario. El trabajo de un umbral no es detectar anomalías al instante: es detectarlas cuando importa. Prefiero dejar que un timeout real espere 30 segundos extra a dejar que los falsos muelan la atención de la gente hasta el polvo.
Nuestro WCS es de segunda mano, nuestro equipo es de segunda mano, incluso la tableta está retirada. Pero desde que ordenamos los timeouts, en temporada alta con 8,000 pedidos al día, ni un solo accidente de reenvío.
Los almacenes pequeños tienen su propia forma de sobrevivir: los grandes compran estabilidad con dinero; nosotros la compramos admitiendo la realidad: el equipo tiene humores, los umbrales necesitan margen, y algunas cosas solo necesitan que un humano camine y mire. Admitir eso no da vergüenza. Los accidentes sí.
Por Xiao Ma, propietario de un pequeño almacén
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.