La disyuntiva entre la computación en el borde y la nube para la IA del almacén es una pregunta que hoy aparece en casi todos los proyectos de digitalización de almacenes. Un bando pone la potencia de cómputo en el piso del almacén; el otro envía la inferencia a la nube. Ambos bandos pueden presentar un argumento convincente, y ambos tienen su cuota de lecciones dolorosas. La verdadera pregunta no es qué tecnología es más avanzada. Es lo que la inferencia de IA en el almacén exige realmente en términos de latencia, costo y tolerancia a los cortes de red. Si se separan esos tres requisitos, la respuesta suele resultar distinta de la primera impresión.
El mismo almacén, dos resultados muy distintos
Pensemos en un caso real. En 2024, un almacén logístico de terceros en el este de China que maneja electrónica de consumo introdujo la inspección visual: las cámaras fotografiaban las etiquetas de los paquetes, la IA leía la información de la etiqueta y la cotejaba con los pedidos del sistema, y los paquetes que no coincidían se detenían en la línea. Al principio, el sistema funcionaba en la nube. Una foto subía, el resultado bajaba. En un día normal, todo funcionaba. Entonces, una noche de gran promoción multiplicó el volumen de pedidos varias veces, y los problemas llegaron juntos. El reconocimiento de etiquetas, que antes devolvía el resultado en menos de un segundo, se alargó a varios segundos. Los paquetes en la cinta no podían esperar, así que se liberaban sin revisar, y la tasa de interceptación cayó de forma notable. Peor aún, un breve corte de banda ancha en el parque industrial dejó fuera de servicio toda la línea de inspección durante más de diez minutos, y el equipo tuvo que recurrir a controles manuales por muestreo.
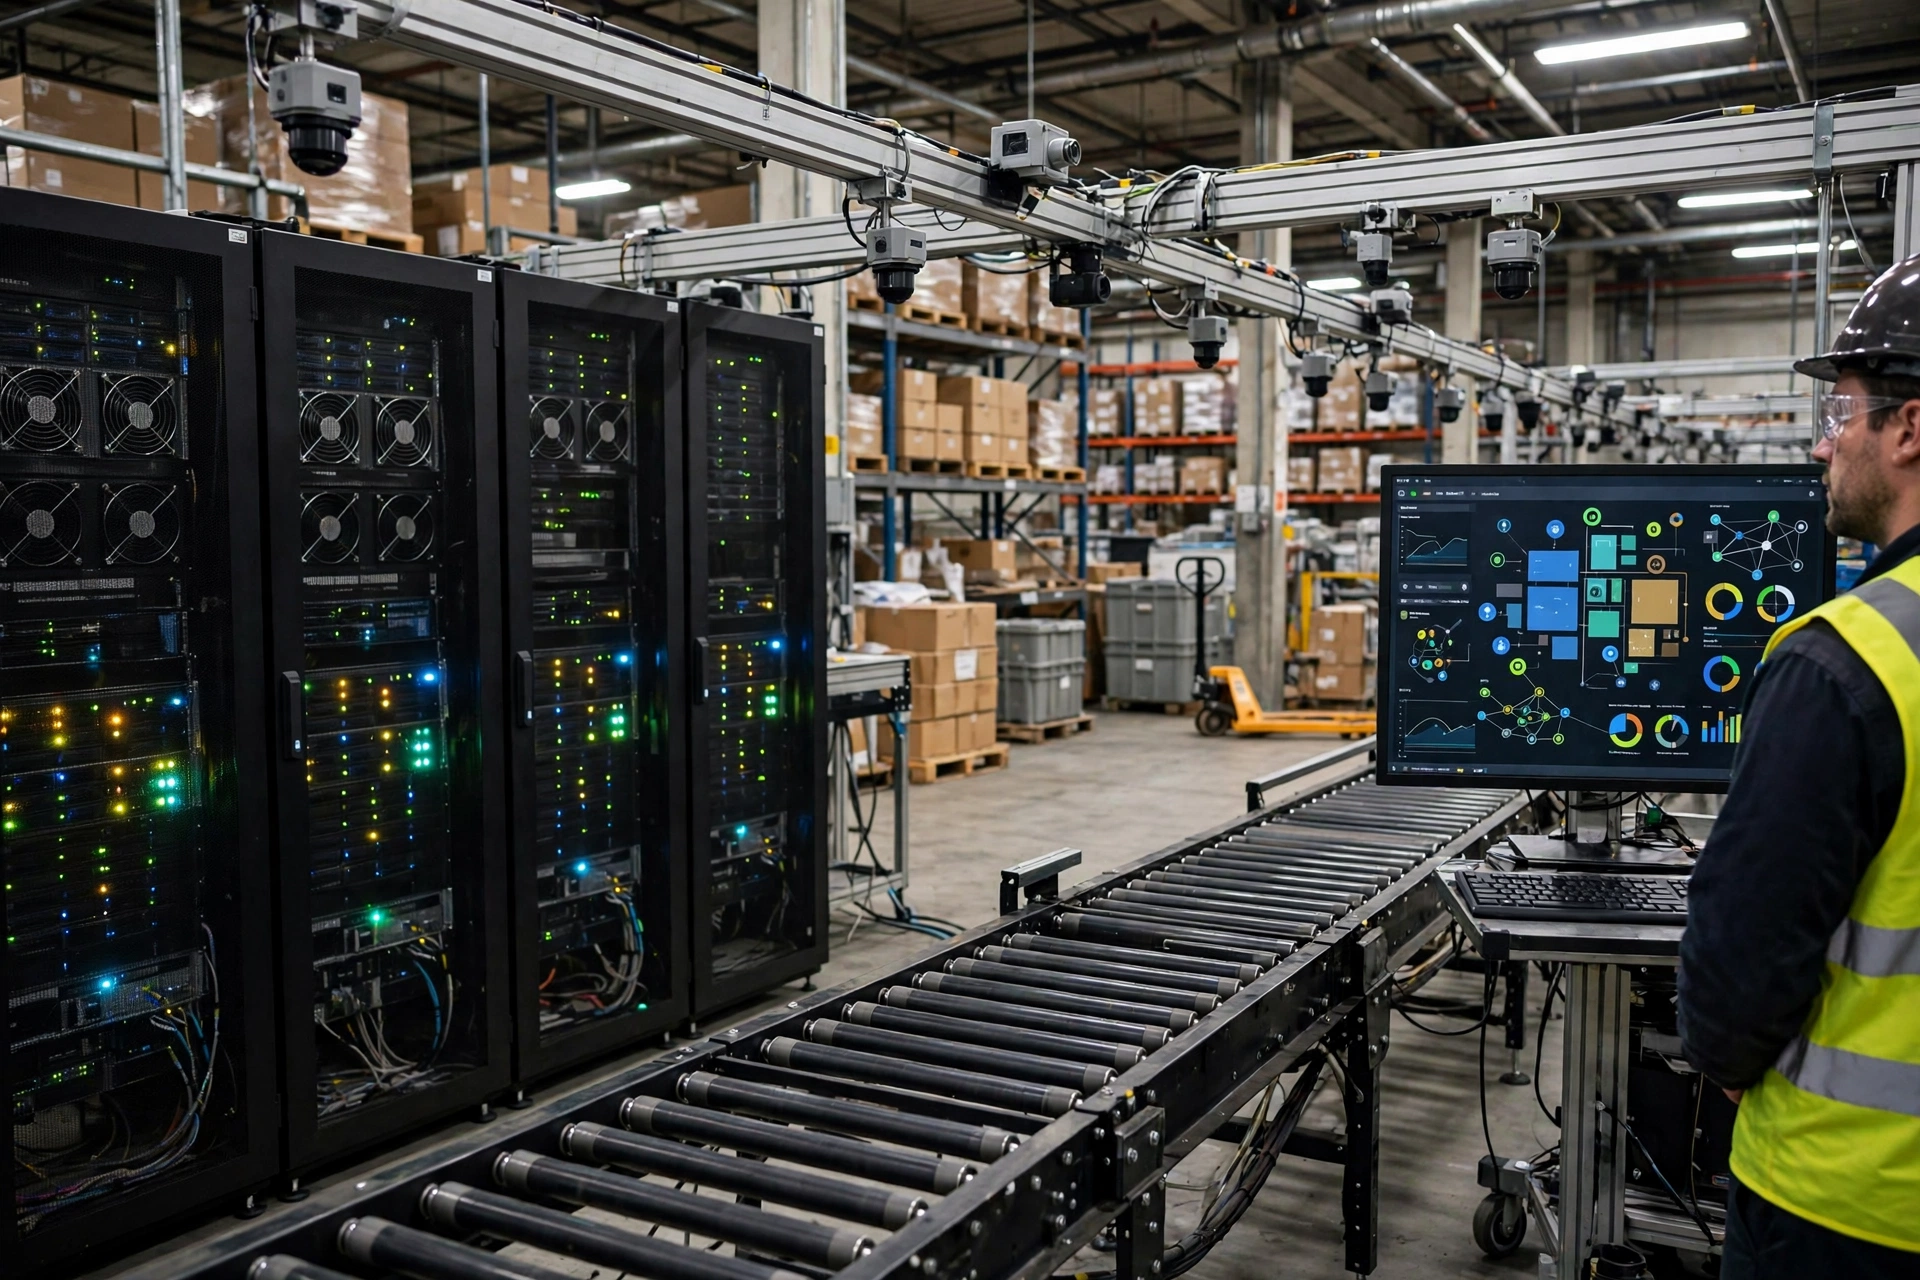
Ese mismo almacén trasladó después la inferencia de inspección visual a servidores en el borde dentro de sus instalaciones. Las cámaras enviaban las imágenes directamente al cómputo local, los resultados llegaban en el acto, y la nube se quedó solo con las actualizaciones de modelos y la agregación de datos. Los tiempos de respuesta volvieron al rango de los milisegundos, y un corte de red ya no detenía la inspección en sí. La lección es sencilla: dónde debería ejecutarse la inferencia de IA en el almacén depende primero de cuánta latencia puede tolerar la tarea. La inspección visual, la verificación de picking y las alertas de anomalías pierden su valor si la respuesta llega medio latido tarde. Pertenecen al borde. La previsión de la demanda, la estrategia de reposición y el análisis mensual de rendimiento, en cambio, no pierden nada si la respuesta llega unos minutos después. La nube es el mejor hogar para ellas.
Un segundo caso viene de una empresa de almacenamiento de ropa. En 2023, adoptó IA en la nube para las preguntas del servicio al cliente y el análisis de excepciones de pedidos, y los resultados fueron buenos. Al año siguiente, el equipo quiso trasladar también la optimización de rutas de picking a la nube. El problema era el volumen de llamadas. La optimización de rutas de picking necesita leer constantemente los datos de ubicación, inventario y pedidos. Cada llamada es pequeña, pero las llamadas son frecuentes, y la facturación en la nube es por llamada. En cuestión de meses, los cargos por llamadas de inferencia crecieron silenciosamente hasta superar el presupuesto original. La revisión encontró el desajuste: las tareas de alta frecuencia en la nube producen una factura que sube más rápido que una compra única de hardware. La nube no era el problema. El desajuste era entre el modelo de facturación y el perfil de la tarea.
Computación en el borde frente a la nube: tres cálculos separados
La latencia, el costo y la resiliencia ante cortes deben calcularse por separado antes de que cualquier comparación tenga sentido.
| Dimensión | Computación en el borde | Inferencia en la nube |
|---|---|---|
| Latencia de inferencia | Cómputo local, normalmente en el rango de los milisegundos, apenas afectado por la red | Depende de los viajes de ida y vuelta por la red, cientos de milisegundos cuando es estable, segundos cuando hay congestión |
| Impacto de un corte | La inferencia local sigue funcionando; solo se pierden las actualizaciones de modelos y la agregación | Las tareas dependientes se detienen por completo hasta que vuelve la red |
| Inversión inicial | Requiere servidores en el borde y aceleradores, mayor costo único | Costo de hardware casi nulo, pago por uso, baja barrera de entrada |
| Costo a largo plazo | Costo mayormente fijo, se amortiza mejor a medida que crece el uso | Crece linealmente con el volumen de llamadas, puede superar al hardware en el borde con alta frecuencia |
| Mantenimiento | Necesita alguien en sitio que entienda de hardware; las actualizaciones de modelos se distribuyen punto por punto | Operaciones gestionadas por el proveedor; una actualización de modelo llega a todas partes a la vez |
| Escalado | Añadir máquinas lleva semanas | La capacidad escala bajo demanda, en minutos |
El costo es el cálculo que más a menudo se hace mal. La gente compara el precio de un servidor en el borde con un mes de facturas de la nube, es decir, un costo único frente a uno mensual. La comparación no tiene sentido. La forma correcta es calcular el costo total de propiedad a tres años: en el borde significa hardware más electricidad más mano de obra de mantenimiento en sitio; en la nube significa cargos por llamadas más transferencia de datos más, posiblemente, una línea dedicada. Tomemos como ilustración un almacén de tamaño mediano. Si la inspección visual ejecuta cientos de miles de inferencias al día, tres años de cargos por llamadas en la nube pueden superar fácilmente el costo único del hardware en el borde. Si solo ejecuta unos pocos miles al día, el hardware en el borde queda infrautilizado y la nube de pago por uso es más barata. La línea divisoria no es la tecnología. Es el volumen de llamadas.
La resiliencia ante cortes es el cálculo que más a menudo se subestima. Las redes de los almacenes no son redes de oficina. La banda ancha del parque, el Wi-Fi interno y las líneas de los operadores pueden fallar cada una por su lado. La pregunta clave es qué procesos deben seguir funcionando cuando se cae la red. La verificación de picking, la inspección de etiquetas y la interceptación de salida no pueden detenerse diez minutos, porque los paquetes equivocados enviados en esa ventana cuestan mucho más recuperarlos que prevenirlos. Ponerlos en el borde es un seguro para la ruta crítica. Los informes, la previsión y el análisis pueden esperar un corte de varias horas sin daño real, así que pueden quedarse en la nube.
He aquí el juicio contraintuitivo: el mayor valor de la computación en el borde a menudo no es la velocidad, sino la estabilidad. Muchos equipos adoptan el borde para ahorrar unos cientos de milisegundos, pero en la mayoría de los escenarios de almacén nadie nota unos cientos de milisegundos. Lo que despierta a un gerente de almacén por la noche es una fluctuación de red que tumba todo el pipeline de IA. La computación en el borde es valiosa primero porque el trabajo continúa cuando la red no lo hace, y solo en segundo lugar porque es más rápida. A la inversa, el mayor valor de la nube a menudo no es el menor costo, sino la menor preocupación. La iteración de modelos, la capacidad elástica y las operaciones externalizadas son invisibles en la factura, pero consumen presupuesto silenciosamente a lo largo de tres años.
Enrutado por escenario: borde o nube para cada carga de trabajo
Al juntar los tres cálculos, la decisión entre la computación en el borde y la nube para la IA del almacén se vuelve sencilla una vez que las tareas se enrutan según sus características:
- Borde: inspección visual, reconocimiento de etiquetas, verificación de picking, alertas de anomalías, monitoreo de la condición de los equipos. Estas tareas comparten tres rasgos: alta frecuencia, tiempo real y tolerancia cero al tiempo de inactividad dependiente de la red.
- Nube: previsión de la demanda, estrategia de reposición, análisis de salud del inventario, informes mensuales de rendimiento. Son de baja frecuencia, pueden esperar, implican grandes volúmenes de datos y se benefician de la iteración rápida de modelos.
- Híbrido: optimización de rutas de picking, planificación de oleadas, programación de mano de obra. Pueden ejecutar una versión ligera en el borde durante el día para responder en tiempo real, y un recálculo más pesado en la nube por la noche para la optimización global.
El despliegue híbrido suena ideal, pero conlleva una trampa: la deriva de versiones de modelos. El borde ejecuta un modelo ligero distribuido hace tres meses, mientras la nube ejecuta un modelo grande actualizado la semana pasada, y ambos pueden discrepar en la misma tarea. La solución es una gestión unificada de versiones de modelos, con las actualizaciones de modelos del borde sincronizadas con la nube y una regla clara sobre qué lado gana en un conflicto. Ese costo de gestión debe presupuestarse en la aprobación del proyecto, o los ahorros del despliegue híbrido se pagarán muchas veces en disputas posteriores.
Una dimensión más es fácil de pasar por alto: la capacidad de mantenimiento. Los servidores en el borde están en el piso del almacén, donde el polvo, la temperatura y las fluctuaciones de voltaje son reales. Las fallas de hardware necesitan a alguien en sitio. Si el almacén no tiene a nadie que entienda de hardware, el costo oculto de mantenimiento de un despliegue en el borde será alto. La nube externaliza las operaciones al proveedor, y el almacén solo gestiona su red y sus cuentas. Para los almacenes pequeños y medianos, este punto a menudo decide el éxito más que cualquier métrica técnica.
La cadena de decisión: primero la tarea, después la ubicación
La pregunta de si la inferencia de IA del almacén va en el borde o en la nube no tiene una respuesta estándar, solo una cadena de decisión: primero, cuánta latencia y cuántos cortes puede tolerar la tarea; segundo, qué le hace el volumen de llamadas a la curva de costos; tercero, si el equipo puede mantener el hardware en el borde. Respondidas esas tres, la ubicación de despliegue se deduce sola.
Una tendencia que vale la pena observar es que ambos lados de la frontera siguen moviéndose. El hardware en el borde sigue abaratándose, y la inferencia en la nube también sigue abaratándose, así que la línea divisoria cambia cada año. Una tarea que hoy pertenece a la nube puede pertenecer al borde el año que viene; una tarea que hoy debe estar en el borde puede cubrirse el año que viene con una línea dedicada en la nube más caché local. Esta no es una decisión única, sino dinámica, que se revisa cada año. Lo que los gerentes de almacén realmente necesitan no es la capacidad de elegir bien una vez, sino el hábito de recalcular las tres cuentas cada año. Los precios específicos deben consultarse en la última política publicada de cada proveedor, y cualquier proyecto debe recalcularse con su propio volumen de llamadas antes de su aprobación.
Por Dr. Chen, Investigador de la cadena de suministro Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.