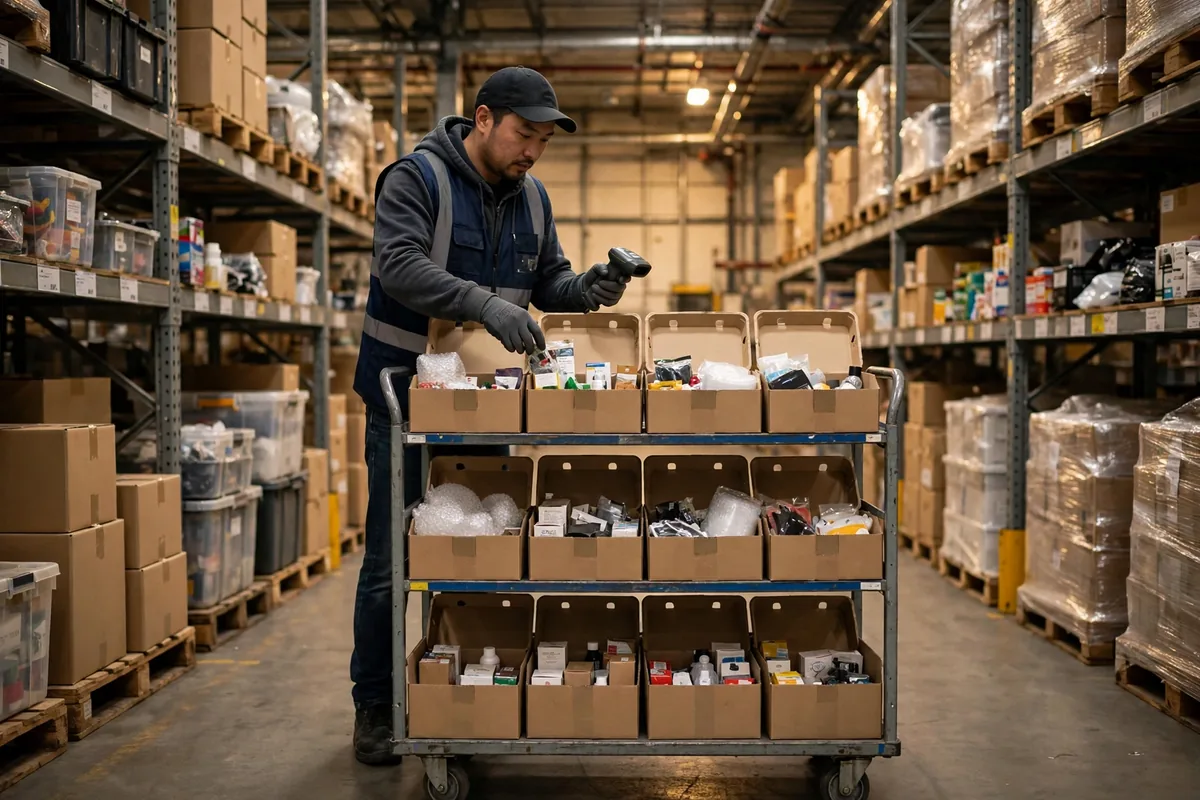
El pasado octubre, el comercial de un proveedor de IA vino a nuestro almacén con un portátil para mostrarnos su sistema. Media hora después, mirando una pantalla llena de mensajes de error, solo acertó a decir una frase: «Vuestros datos de SKU son… especiales». Casi me río en voz alta. ¿Especiales? Nuestro almacén tiene 3,000 metros cuadrados, cuatro personas, algo más de 600 SKU, y nuestros datos tienen verdadera personalidad: una caja de papel tisú tiene tres nombres distintos en el sistema, y se supone que la ubicación A-12-03 guarda 40 cajas, pero en realidad guarda un montón de devoluciones.
Ese día aprendí que la preparación de datos para la IA en el almacén no es un lujo de las grandes empresas. Para un almacén pequeño, es supervivencia. Gartner predice que el 60% de los proyectos de IA que carecen de datos listos para la IA se abandonarán hasta 2026. El proyecto NANDA del MIT descubrió en 2025 que el 95% de los pilotos de IA generativa no produjeron ningún retorno medible. Detrás de ambas cifras hay una sola frase: el modelo no tiene la culpa; los datos fallan primero.
Lo sucios que estaban nuestros datos
Empecemos por los datos maestros: las tablas de SKU, ubicaciones y clientes. Esta es la base sobre la que se apoya la IA. Con una base torcida, todo lo que se construya encima se derrumba.
Nuestro desastre clásico es lo que yo llamo «un producto, muchos códigos». Una marca de papel tisú: compras creó un SKU llamado «Tissue-3ply», operaciones pensó que el nombre era demasiado largo y creó «Tissue 3-ply», y luego un proveedor cambió el paquete de 100 hojas a 120 y alguien creó un tercero. Tres SKU en el sistema, un solo producto físico, el inventario repartido en tres códigos. Cuando la IA calcula la reposición, cree que hay tres productos. La sugerencia no puede ser correcta. Revisé por muestreo nuestros más de 600 SKU y encontré más de 40 duplicados como este, cerca de uno de cada diez.
Las ubicaciones estaban peor. No tenemos un responsable dedicado a las ubicaciones; la mercancía va donde haya un hueco libre, y las ubicaciones del sistema se alejaron de la realidad hace mucho tiempo. En el recuento del año pasado, nuestra precisión de registro de inventario era del 91%: nueve de cada cien ubicaciones no coincidían con los libros. Entrega a la IA datos con un 91% de precisión y pídele que planifique rutas de picking, y los operarios irán a una ubicación, no encontrarán nada y volverán. Eso no es eficiencia. Eso es pagar para fastidiar a tu propia gente. Estas son nuestras propias cifras de recuento, no un referente del sector.
Los datos maestros de clientes no estaban más limpios. El mismo cliente aparece como dos empresas porque un registro dice «XX Trading, Dongguan» y el otro dice «Dongguan XX Trading», con la dirección escrita de dos maneras distintas. La agrupación de la IA los contaría encantada como dos clientes. ¿De quién es la culpa? Nuestra: un almacén pequeño sin nadie responsable de los datos, y un jefe, yo, que solía pensar que «aproximado vale». La IA no acepta «aproximado».
Preparación de datos para la IA en el almacén: tres tipos de datos, en el orden correcto
La preparación de datos para la IA en el almacén, en el orden que nuestro almacén aprendió por las malas: primero los datos maestros, segundo los datos operativos, tercero los datos de equipos. Si te equivocas de orden, el trabajo se desperdicia.
| Tipo de datos | Qué abarca | Cómo se ven los datos sucios | Suficiente para un piloto |
|---|---|---|---|
| Datos maestros | Tablas de SKU, ubicaciones y clientes | SKU duplicados, ubicaciones que no coinciden con los libros, clientes duplicados | Cero códigos duplicados entre los SKU principales; precisión de ubicaciones superior al 95% |
| Datos operativos | Pedidos, picking, registros de recuento cíclico | Escaneos omitidos, diferencias de recuento corregidas a mano, devoluciones registradas tres días tarde | Papeleo del mismo día, registros de picking que coinciden con los números de pedido |
| Datos de equipos | Registros de escáneres, sensores e impresoras | Marcas de tiempo desincronizadas, registros que faltan, errores que nadie lee | Registros que coinciden con los pedidos, marcas de tiempo alineadas con el reloj del sistema |
¿Por qué primero los datos maestros? Los datos operativos son la historia en curso; los datos maestros son el diccionario. Si el diccionario está mal, la historia está mal. Nuestro enfoque: limpiar primero los 200 SKU principales por velocidad de ventas; la cabeza de la lista cubre alrededor del ochenta por ciento de los envíos. Para las ubicaciones, fijar primero una regla de hierro: una ubicación guarda un SKU. La deduplicación de clientes llevó una tarde en su mayor parte.
Los datos operativos vienen en segundo lugar. Los pedidos, los registros de picking y los registros de recuento son el libro de texto del que la IA aprende «cómo funciona realmente nuestro almacén». El libro de texto no puede tener capítulos que falten: operarios que se saltan escaneos para ahorrar tiempo, diferencias de recuento editadas en silencio, pedidos de devolución registrados tres días tarde; todo eso enseña a la IA las lecciones equivocadas. Nuestra regla casera es sencilla: el papeleo de hoy se liquida hoy, y lo que quede para la noche es el primer punto de la reunión de la mañana siguiente.
Los datos de equipos vienen los últimos: registros de escáneres, lecturas de sensores, errores de impresora; el mayor volumen, el menor uso en un piloto inicial. Solo hay que asegurarse de que los registros de escáner se puedan vincular con los números de pedido y de que las marcas de tiempo de los sensores no vayan media hora por detrás del reloj del sistema. Tuvimos exactamente ese problema una vez: un sensor iba 25 minutos por detrás del WMS, y el análisis de temperatura de la IA salió completamente desalineado.
Preparación de datos para la IA en el almacén con poco dinero: sin presupuesto
Una gran empresa contrata consultores para la gobernanza de datos, decenas de miles de dólares por trabajo. Nosotros no podemos permitirnos quemar ese tipo de dinero. Nuestras soluciones son caseras, y funcionan.
Solución uno: Excel es una herramienta de gobernanza. Exporto la tabla de SKU, ordeno por nombre, y los duplicados quedan lado a lado, donde los ojos los cazan. Ordeno después por código de barras, y los códigos que faltan o están duplicados saltan a la vista. Cada viernes por la tarde, el supervisor del almacén y yo dedicamos una hora a revisar 50 SKU. En un mes terminamos los 200 principales. El coste es el tiempo de dos personas; el resultado es una tasa de duplicados que cayó de casi uno de cada diez a prácticamente cero.
Solución dos: que el escáner sea el árbitro. Los operarios solían coger el stock de memoria. Ahora la regla es escanear para confirmar tanto la ubicación como el SKU, y el escáner pita cuando algo está mal. La gente se quejó durante dos semanas. En la tercera semana, los errores de picking habían bajado, y cada ubicación que no coincidía con los libros fue saliendo una por una.
Solución tres: dejar de hacer recuentos sorpresa y hacer recuentos rotativos. Veinte ubicaciones cada mañana antes de empezar a trabajar, todo el almacén cubierto en un mes. Una discrepancia se corrige en el acto, y preguntamos por qué allí mismo: ¿ubicación equivocada o registro equivocado? En tres meses nuestra precisión de inventario subió del 91% a más del 97%. De nuevo, nuestras propias cifras: prueba de que un almacén pequeño puede mejorar sus cifras con métodos caseros.
Ahora las cuentas (ejemplo ilustrativo): cuatro personas, media hora cada una al día en limpieza de datos, suman 60 horas de trabajo al mes. A 30 yuanes la hora, son 1,800 yuanes. Compáralo con lanzar un piloto de IA con datos sucios: las tarifas de implantación del proveedor empiezan en decenas de miles de yuanes, el piloto dura un mes, los datos resultan estar mal, empiezas de nuevo, la tarifa se ha ido, y la temporada alta sigue necesitando humanos para rescatarlo. Esos 1,800 yuanes compran el billete para un piloto que no se estrella.
Aquí está la parte contraintuitiva: cuanto más pequeño es el almacén, antes tiene que hacerse este trabajo. Los grandes almacenes tienen equipos de TI y presupuestos y pueden absorber un fracaso. Cuando un almacén pequeño fracasa una vez, medio año de beneficio se ha ido. No pienses «somos pequeños, tenemos pocos datos, esto es fácil». Pocos datos significa que cada error es una gran parte. Seiscientos SKU, cuarenta duplicados: a ojos de la IA, este almacén no tiene ningún dato limpio.
Consejos para almacenes como el nuestro: limpiar primero, hablar de IA después
Si tú también diriges un almacén pequeño, la próxima vez que un proveedor te diga «solo conéctalo y funciona», haz primero tres preguntas: ¿qué hace tu modelo con SKU duplicados como los nuestros? Cuando una ubicación no coincide con los libros y la ruta de picking es errónea, ¿quién es el responsable? Si el piloto sale mal, ¿es reembolsable la tarifa de implantación? Después de esas tres preguntas, sabrás aproximadamente si merece la pena gastar el dinero.
Todavía no hemos adoptado la IA. Los datos están limpios, y el piloto está programado para la segunda mitad de este año. La presentación de un proveedor no caduca, pero la temporada alta no te esperará. Lava primero las tres tablas, luego conecta los registros operativos, y solo entonces los registros de equipos. Cuando la preparación de datos para la IA en el almacén está hecha, la IA llega como ayudante. Sin ella, la IA llega como un jefe al que tienes que servir.
Los almacenes pequeños tienen su propia forma de sobrevivir: las grandes empresas arrasan con presupuestos; nosotros lo vamos limpiando con nuestras propias manos. Límpialo bien, y un almacén pequeño también puede usar la IA, solo que a nuestro ritmo, no al del vendedor.
Por Xiao Ma, Propietario de un pequeño almacén Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.