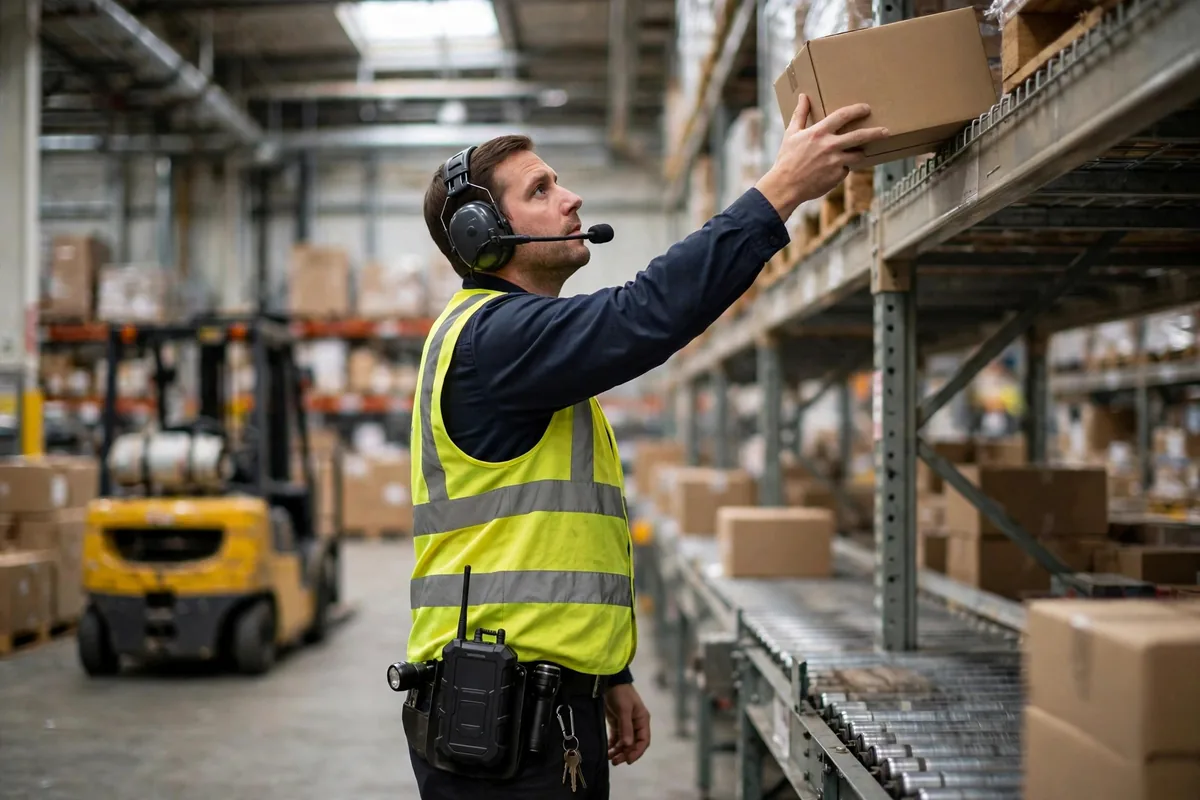
La recogida por voz es hoy equipo estándar en muchos centros de distribución grandes. Los folletos de los proveedores citan todos una precisión superior al 99.9%. Sin embargo, según las cifras publicadas por Dematic, la tasa de error real de la recogida por voz se sitúa entre 0.2 y 2 errores por cada 1,000 artículos recogidos — es decir, entre el 99.8% y el 99.98%. La cifra en sí no es mala. Lo que merece atención es la distribución que hay detrás: los errores de reconocimiento en la recogida por voz no se producen de manera uniforme. Se concentran en tres puntos: el acento, el ruido y el propio mecanismo de confirmación.
Errores de reconocimiento en la recogida por voz: empecemos por los datos
Establezcamos primero la línea base. Un estudio publicado en el Journal of Organizational Behavior Management (Berger and Ludwig, 2007) siguió a 132 selectores de un distribuidor de servicios de alimentación en el sureste de Estados Unidos: tras introducir la selección asistida por voz con retroalimentación inmediata, los errores cayeron de 2.44 por cada 1,000 cajas seleccionadas a 0.94 — una reducción de más del 60%. Un caso práctico publicado por un proveedor cuenta una historia similar desde el otro lado: después de que TaylorMade adoptara la recogida por voz, su equipo de picking se redujo de 20–25 personas a 14–16, mientras que el rendimiento subió de 41 transacciones por hora a 184. Ambos conjuntos de cifras confirman que el valor de la recogida por voz es real, pero su precisión nunca es una cifra aislada. Es función de un conjunto de condiciones.
El ruido es la primera condición. La inteligibilidad del habla empieza a degradarse de forma notable cuando el ruido ambiental supera los 65–70 dB(A), mientras que un centro de distribución típico supera habitualmente los 85 dB(A). Los informes del sector sobre entornos industriales de alto ruido sugieren que la precisión del reconocimiento puede caer de más del 95% a menos del 60%. El rango es tan amplio porque el «ruido» no es una sola variable: el zumbido constante de una cinta transportadora y el pico transitorio de una carretilla elevadora al arrancar dañan el reconocimiento de formas completamente distintas.
El ruido no es el único culpable
El ruido de fondo constante es, paradójicamente, el problema más fácil. Los auriculares industriales modernos manejan razonablemente bien el ruido de frecuencia estable con algoritmos de cancelación de ruido. La parte difícil es lo transitorio: el chirrido de un elevador hidráulico, el rugido del encendido de una carretilla elevadora, el estruendo de las estanterías metálicas, sonidos que llegan de repente, se extienden por un amplio espectro y desaparecen antes de que el algoritmo pueda modelarlos. Luego está la reverberación: en un almacén de gran altura, el sonido rebota en las superficies duras y los límites entre fonemas se difuminan, de modo que el sistema no escucha una cadena limpia de sílabas, sino habla envuelta en eco. La acústica del almacén rara vez es el primer punto de una lista de verificación de aceptación, y sin embargo fija el suelo de cómo rinde la recogida por voz en condiciones reales.
También hay una variable que rara vez llega a la evaluación: el propio auricular. Un operario lo lleva durante ocho horas; el sudor, el deslizamiento y una diadema que se afloja alejan el micrófono de su posición óptima, y el reconocimiento se degrada con ello. Eso es un problema de ergonomía, no de tecnología, pero termina en el mismo registro de «errores de reconocimiento». Evaluar la recogida por voz solo por las tasas de reconocimiento de laboratorio es como evaluar un coche por su consumo anunciado.
El acento: la voz que el modelo nunca ha escuchado
Si el ruido es una variable ambiental, el acento es una variable humana. Los modelos de reconocimiento de voz se entrenan de forma abrumadora con pronunciación estándar, mientras que la mano de obra de picking en un almacén estadounidense suele ser multilingüe y multiacento: hispanohablantes nativos, inmigrantes del sudeste asiático, angloparlantes nativos con acentos regionales; la misma frase sale con vocales diferentes y una entonación diferente. Los primeros sistemas de recogida por voz dependían del locutor: cada trabajador leía una lista de vocabulario para que el sistema construyera un perfil de voz personal, almacenado en un servidor y descargado en el terminal del trabajador al inicio de cada turno. Ese enfoque funciona, pero tiene un coste: los errores de reconocimiento alcanzan su punto máximo en las primeras dos semanas de un nuevo empleado, que es precisamente cuando la rotación es mayor.
La misma trampa existe en otros idiomas. En inglés, «fifteen» y «fifty» son el par clásico; en chino, los números tres, cuatro, siete y diez se confunden a velocidad. El problema subyacente es idéntico: si el vocabulario de confirmación contiene casi homófonos, la probabilidad de error de reconocimiento se amplifica de forma sistemática. Esto no es que los trabajadores «hablen incorrectamente». Es una lista de vocabulario diseñada sin comprobar los pares mínimos.
La paradoja del dígito de verificación: cuando la salvaguarda se convierte en el agujero
El mecanismo central de prevención de errores en la recogida por voz es el dígito de verificación. El sistema anuncia una ubicación, el trabajador lee en voz alta el dígito de verificación publicado en la estantería, normalmente los últimos tres dígitos del código de barras, y solo después de que el sistema lo verifique anuncia la cantidad a recoger. El mecanismo parece hermético, pero tiene un agujero contraintuitivo: el error de reconocimiento más peligroso no es que el sistema escuche mal. Es que el sistema escuche bien.
Un operario veterano que ha trabajado en la misma zona durante meses tiene memorizados los dígitos de verificación. Antes incluso de llegar a la ubicación, el número ya sale de su boca, el sistema lo verifica, todo está en verde, y se recoge el artículo equivocado. El sector lo llama «memorización del dígito de verificación», e incluso existe una patente (EP3038030A1) que propone dígitos de verificación dinámicos, un código diferente para cada interacción, precisamente para impedir que los trabajadores superen la verificación de memoria. Una salvaguarda que falla en manos de trabajadores experimentados merece atención: la curva de error de la recogida por voz no cae de forma monótona. Los novatos están protegidos por el sistema; los veteranos pueden eludir la verificación y hacer que los errores vuelvan a subir.
Las contramedidas no son un misterio. Dígitos de verificación dinámicos, códigos de verificación rotativos, una confirmación adicional por escaneo para artículos de alto valor: todas ya están desplegadas en algún lugar. Lo que comparten es un cambio de responsabilidad, de la «disciplina del trabajador» a la «aplicación del proceso». Cualquier paso de verificación que dependa de que los trabajadores cumplan voluntariamente será eludido bajo la presión de la temporada alta. Eso no es un problema de la naturaleza humana. Es un problema de diseño de procesos.
Mi juicio sobre la tendencia es este: en los próximos tres a cinco años, la reducción de los errores de reconocimiento en la recogida por voz provendrá sobre todo del diseño de procesos, no de esperar a la próxima generación de algoritmos. Los dígitos de verificación dinámicos, los perfiles adaptativos al locutor y la doble confirmación de voz más visión son todas soluciones a nivel de proceso: baratas y rápidas en mostrar resultados. Los algoritmos seguirán mejorando, por supuesto, pero en el entorno del almacén, cada punto porcentual adicional de precisión algorítmica cuesta mucho más que una mejora de proceso que ofrece la misma ganancia.
Queda una pregunta abierta. Cuando la precisión de la recogida por voz ya ha llegado al 99.9% y más allá, ¿quién debería pagar por el 0.1% restante: el sistema, el proceso o las personas? No hay una respuesta estándar, pero determina hacia dónde va la próxima ronda de inversión: a un mejor motor de reconocimiento o de vuelta a los procedimientos de dígito de verificación y al diseño de vocabulario. Mi juicio es lo segundo. El tiempo dará su propia respuesta.
Por Dr. Chen, Investigador de la cadena de suministro Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.