La respuesta corta: sí, se puede actualizar un WMS sin detener el almacén — pero no tiene nada que ver con la suerte. Antes de la noche de la actualización, necesitas tres cosas resueltas: una instantánea (snapshot) a la que realmente puedas volver, un orden de despliegue que vaya del sitio de menor riesgo al de mayor riesgo, y una lista de verificación post-actualización que toma unas cuatro horas completar. Si te saltas cualquiera de las tres, estás apostando. He visto esa apuesta perder tres veces, y cada vez el precio fue un muelle de expedición parado.
Una aclaración antes de empezar: esto trata del WMS — el sistema de gestión de almacenes que gestiona pedidos, inventario y asignación de tareas. No del WCS, el sistema de control de almacenes que acciona transportadores y grúas mediante señales PLC. Las actualizaciones de WCS detienen equipos; las de WMS detienen el flujo de información. Planificaciones distintas, no las mezcles.
Las novedades nunca rompen una actualización de WMS — los periféricos sí
En más de 30 proyectos de implementación y actualización, puedo contar con una mano las actualizaciones que fallaron por una novedad. Cada fallo real que he visto vino de los mismos tres periféricos: escáneres RF, plantillas de etiquetas e integraciones externas. Escáneres muertos, etiquetas que no se imprimen y una conexión EDI silenciosa — eso es un almacén parado.
Un ejemplo real. En 2023, un 3PL con una instalación de 120,000 pies cuadrados en el Inland Empire de California hizo una actualización menor de versión. La actualización en sí tomó 40 minutos, y el equipo de IT publicó "actualización completada" en el chat grupal. A las 6 a.m. del día siguiente, los preparadores ficharon y encontraron las pantallas de tareas desalineadas en sus pistolas RF — la nueva versión había cambiado una longitud de campo que los clientes de escáner más antiguos no podían interpretar. Más de cuatrocientos dispositivos, reinstalados uno por uno, de 6 a.m. a mediodía. Media jornada sin liberar una sola oleada (wave). El dueño del cliente se quedó en el muelle viendo cómo se acumulaban los camiones. Todavía recuerdo su cara.
La lección cabe en una frase: en la noche de la actualización, validar las pistolas RF, las impresoras y las integraciones merece el mismo peso que la actualización en sí. Este es el escollo que he visto tres veces, y cada vez la historia es la misma: "la actualización salió bien, el almacén se detuvo".
La lista de la víspera: contrata primero tres pólizas de seguro
Póliza uno: una instantánea completa. Una copia de seguridad de la base de datos es lo mínimo. También necesitas exportar toda la configuración — estrategias de oleadas (wave strategies), reglas de numeración de ubicaciones, plantillas de etiquetas, permisos de usuario, mapeos de integración. Una instantánea de datos y una instantánea de configuración son dos cosas distintas. Los datos se restauran desde la copia; una estrategia mal configurada tarda más en arreglarse.
Póliza dos: un plan de reversión tan bien escrito que puedas ejecutarlo medio dormido. Un plan de reversión útil responde tres preguntas: quién ordena la reversión (un nombre, no "el jefe de proyecto"); a qué punto se vuelve (la marca de tiempo de la instantánea); y cuánto tarda la reversión (tu RTO). Nuestra regla fija: todo el equipo recorre los pasos de reversión la noche anterior, como un simulacro de mesa. Un plan que nadie ha ensayado equivale a no tener plan.
Póliza tres: una alternativa de negocio para el propio tiempo de inactividad. Hojas de picking en papel impresas por adelantado, escáneres offline cargados, una lista de contactos de emergencia pegada en planta. Si toca revertir, el almacén debe pasar a modo manual en 30 minutos — ese es nuestro estándar interno de proyecto, no una promesa del proveedor. Escríbelo en tu propio plan.
Sobre RTO y RPO, déjame ser preciso: qué tan rápido puedes revertir y cuántos datos puedes permitirte perder depende de cómo tomas la instantánea — no de lo que diga el SLA del proveedor. Nuestra regla práctica: toma una instantánea completa justo antes de empezar la actualización, apunta a un RTO de reversión inferior a dos horas, y un RPO de cero pérdida de datos (todo lo creado después de la instantánea se reingresa desde el rastro en papel). Si no puedes cumplir eso, no programes la actualización en temporada alta.
El orden de despliegue multi-sitio
Para clientes con varios sitios, el orden de despliegue:
| Oleada | Qué sitio primero | Por qué | Ventana de observación |
|---|---|---|---|
| 1 | Sitio de prueba / entorno espejo | Si explota, el negocio ni se entera | Al menos un ciclo de oleada completo |
| 2 | Sitio de menor volumen | Validación con negocio real, riesgo contenido | 24 horas |
| 3 | Sitio de volumen medio | Amplía la muestra de validación | 48 horas |
| 4 | Sitio insignia / de mayor volumen | Tócalo el último | Vigilancia presencial total |
Regla de hierro: la siguiente oleada no empieza hasta que la lista de verificación de la oleada anterior esté toda en verde. He visto este escollo tres veces — alguien decide que la oleada uno "se ve bien" y lanza la oleada dos en paralelo, entonces aparece un bug de cocción lenta y dos sitios caen juntos.
Programar la ventana de inactividad: planifícala para el negocio, no para IT
Una ventana de mantenimiento no es una ventana técnica de IT. Es la ventana que el negocio puede permitirse. Tres pasos:
- Lee primero la curva de volumen. Encuentra la noche de menor volumen en una ventana móvil de siete días. Para 3PLs suele ser el domingo de madrugada; para sitios de e-commerce, revisa el calendario de promociones y mantente a más de 72 horas de cualquier venta.
- Luego haz las cuentas. Un número, calculado con honestidad: ¿cuánto cuesta una hora de inactividad? Volumen diario de pedidos ÷ 24 × margen por pedido × horas de inactividad, más horas extra de recuperación y cualquier penalización de SLA. Usa tus propios números. Esa cifra es tu palanca para pedir la ventana — y para negociar la compensación con el proveedor.
- Por último, fija la línea de disparo de la reversión. Si las funciones clave no se restauran X horas después de empezar la actualización, la reversión se dispara automáticamente — sin "dale 15 minutos más". X va en el plan, y nadie puede cambiarlo esa noche.
Aquí va la idea contraintuitiva: la mayoría de los equipos persigue el "cero tiempo de inactividad" y construye despliegues blue-green con doble escritura que duplican la complejidad. Mi criterio tras más de 30 proyectos — para el 90% de los almacenes, una ventana nocturna bien planificada de dos a cuatro horas es más barata y segura que la arquitectura de cero tiempo de inactividad. La complejidad del "nunca parar" es en sí misma el mayor riesgo. Aclara el compromiso: lo que necesitas es que el negocio nunca se detenga, no que el sistema nunca se detenga. Un almacén puede sobrevivir dos horas con hojas de picking en papel. No puede sobrevivir una actualización de "cero tiempo de inactividad" que nadie sabe reparar.
La validación de cuatro horas post-actualización: escáneres, etiquetas, integraciones
Aún no declares la victoria. Recorre esta lista, punto por punto, en cuatro horas:
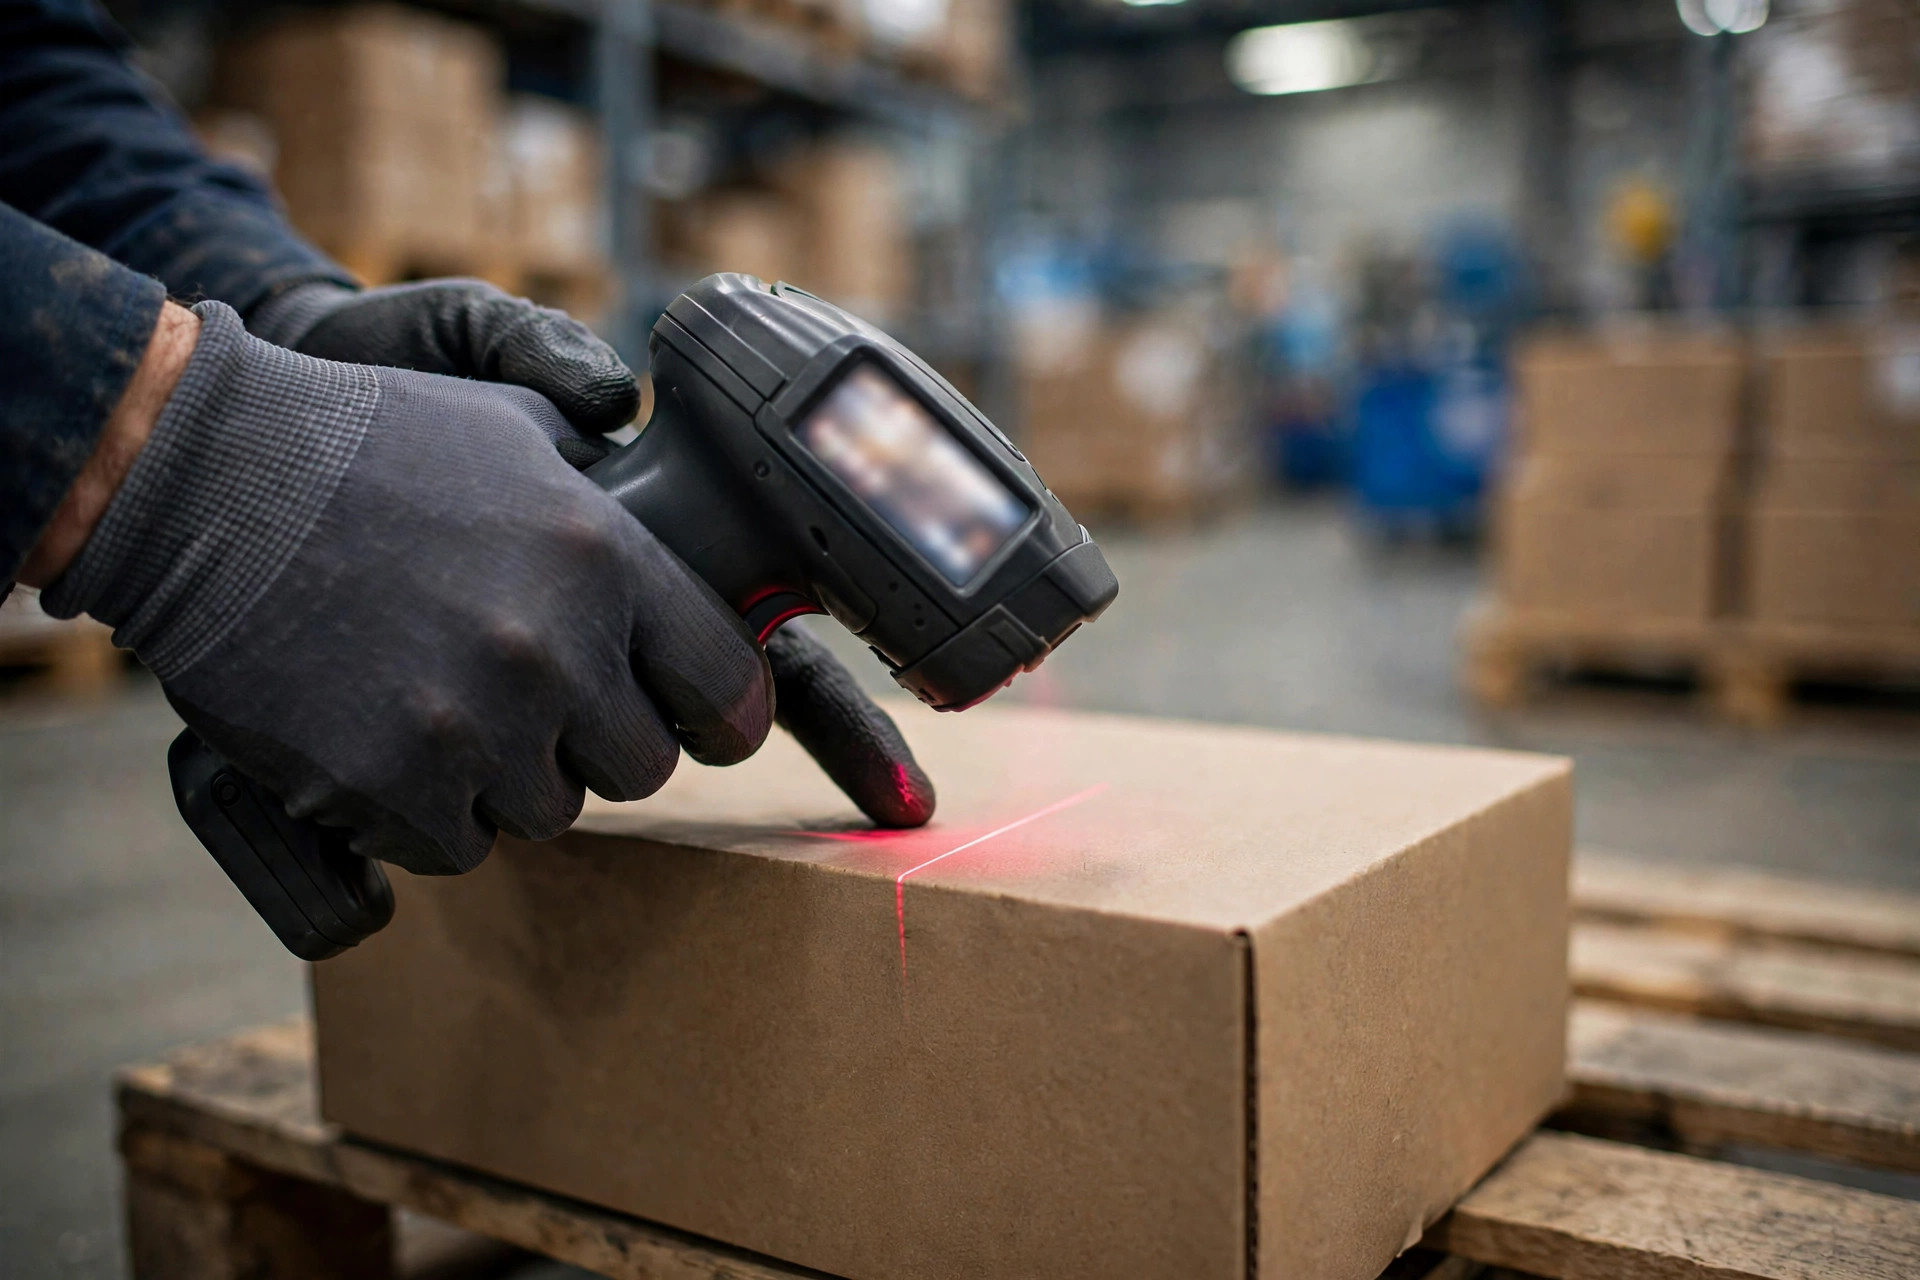
- Escáneres RF: al menos tres unidades de cada modelo en planta, ejecutando el flujo completo recepción → ubicación (putaway) → picking → verificación. En dispositivos antiguos, vigila campos de pantalla desalineados.
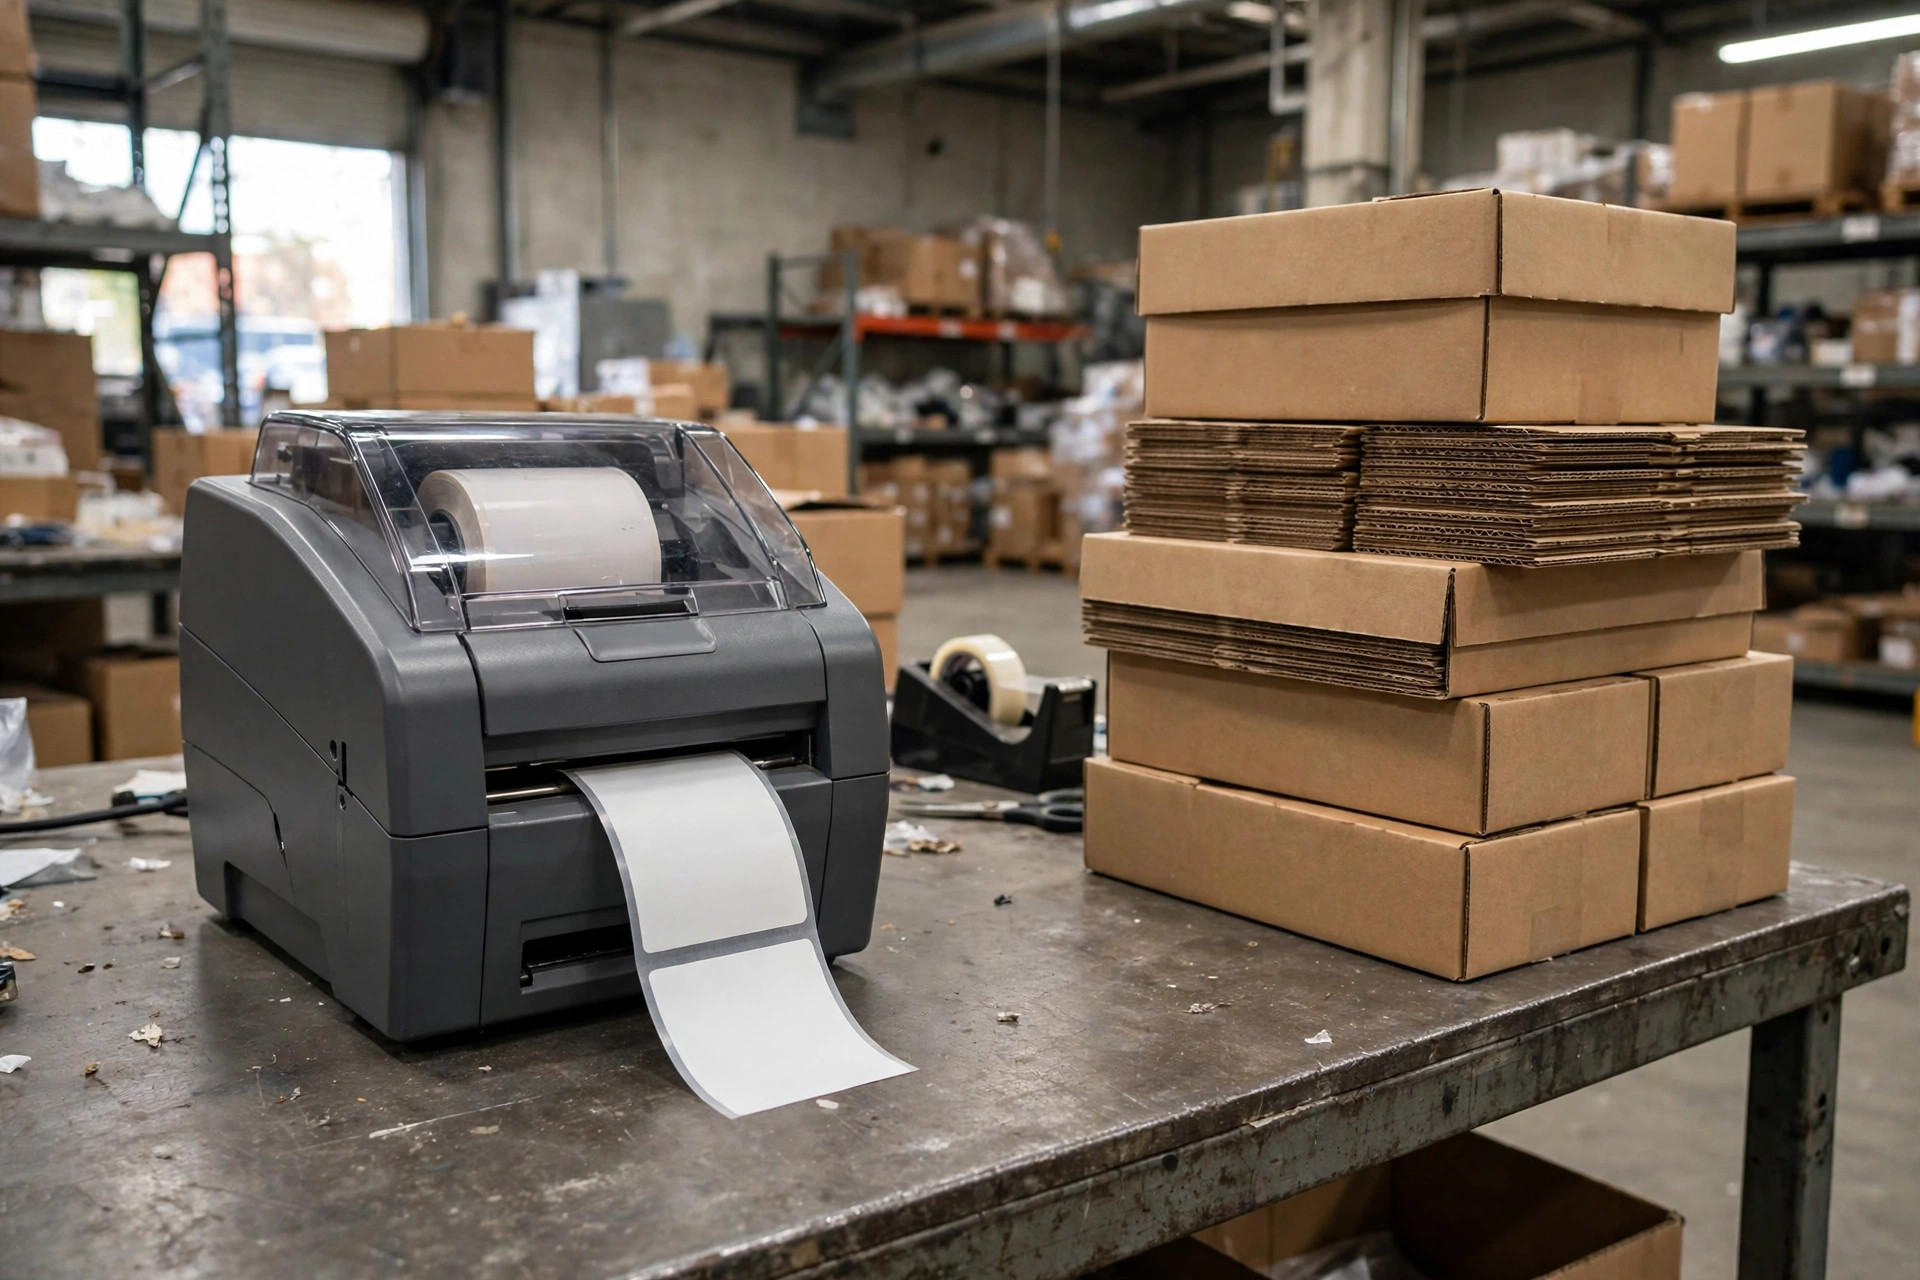
- Plantillas de etiquetas: imprime diez de cada tipo — etiquetas de expedición, etiquetas de cartón y hojas de picking — y escanea cada código de barras para confirmar su legibilidad. La desalineación de plantillas es el bug post-actualización más común.
- Integraciones: ejecuta al menos un pedido de extremo a extremo por cada conexión EDI, marketplace, ERP y TMS. "Conectado" no significa "correcto" — verifica número de pedido, cantidad y dirección en cada prueba.
- Estrategia de oleadas: libera una oleada real y confirma que la lógica de asignación no ha cambiado. Una estrategia mal configurada no lanza errores; reasigna mal en silencio.
- Permisos: inicia sesión con cinco roles distintos y confirma que los menús y derechos sobrevivieron a la actualización.
Actualizaciones forzadas de SaaS: no tienes botón de pausa
Las actualizaciones de WMS on-prem van a tu ritmo. Las de WMS en la nube (SaaS), no. Las ventanas de mantenimiento y los parches forzados siguen el calendario del proveedor, y lo único que puedes hacer es prepararte — no desear que desaparezcan.
Esto no es paranoia. Según el seguimiento público de estado de isdown.app sobre Ongoing Warehouse, un proveedor de WMS en la nube: una caída del sistema el 24 de febrero de 2026 duró unas 4 horas; una interrupción grave del servicio el 25 de junio de 2026 duró unas 5 horas; la duración mediana de incidentes en los últimos 90 días fue de 4 horas 33 minutos. En otras palabras, que un WMS en la nube caiga varias veces al año, durante horas, es una norma documentada — no un cisne negro.
Así que para clientes de WMS SaaS, mi lista siempre tiene tres líneas extra. Una: suscríbete a la página de estado del proveedor y a los avisos de mantenimiento, y confirma que ninguna ventana de mantenimiento del proveedor caiga dentro de las 72 horas de tu noche de actualización. Dos: pon en el contrato las compensaciones y obligaciones de notificación por caídas causadas por el proveedor — las promesas verbales no valen. Tres: mantén listo un plan B offline. Cuando un WMS en la nube cae, ni siquiera puedes tomar una instantánea local. Los documentos en papel y los procedimientos offline son tu único bote salvavidas.
Una última cosa
La actualización más peligrosa nunca es la versión mayor. Es el "parche pequeñito, no necesita pruebas, directo a producción". De las tres explosiones que he visto, dos fueron parches pequeños. Recuerda esto: termina la lista de la víspera antes de dormir, y no declares el éxito hasta que la lista de validación esté toda en verde. Algo que puedes usar mañana: imprime las listas de este artículo y táchalas punto por punto antes de tu próxima noche de actualización. Es la inversión de riesgo más barata en más de 30 proyectos.
Por Lin Xiao, consultor de implementación de WMS
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.