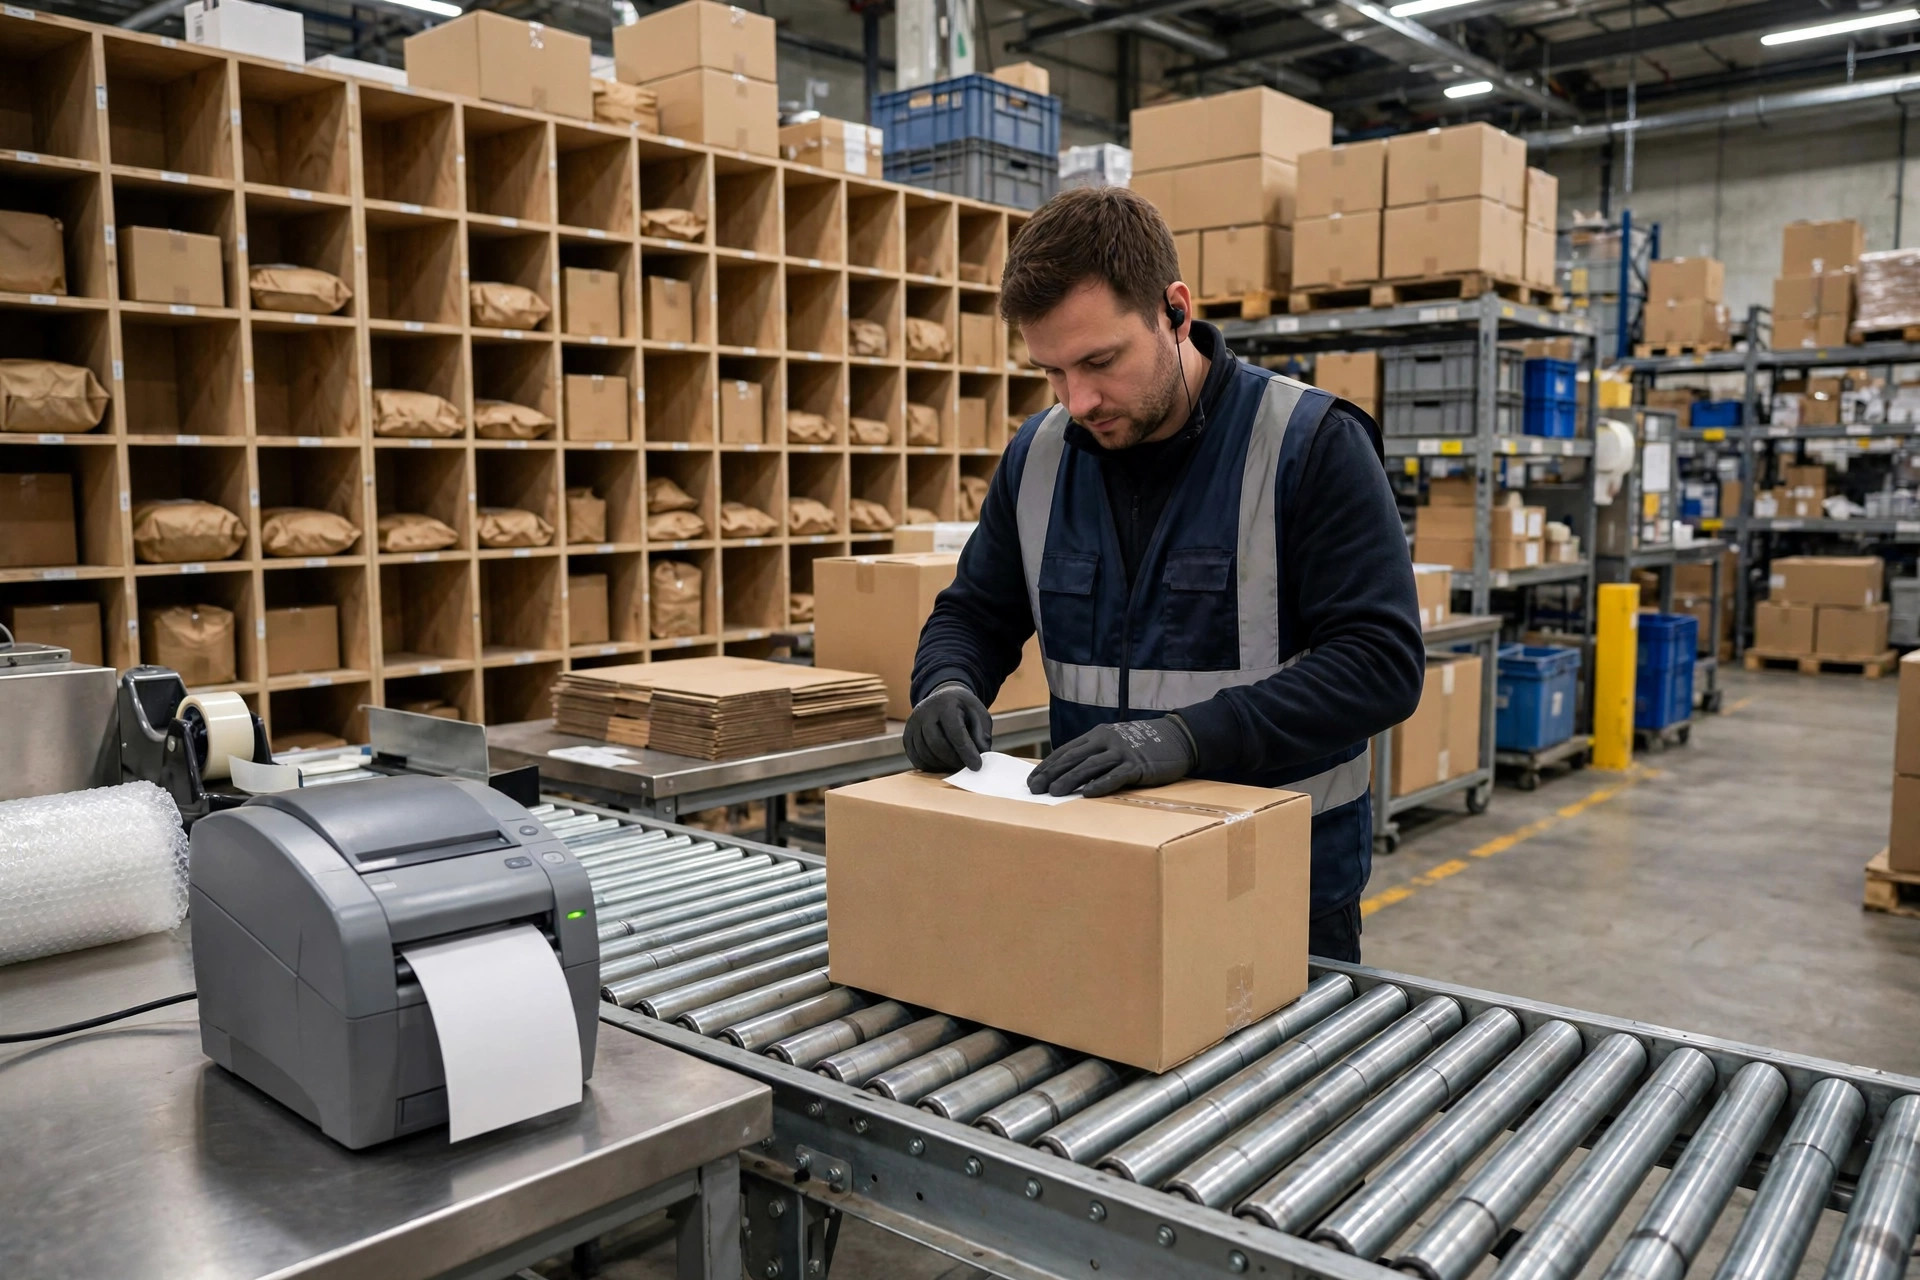
En 2019, en un almacén 3PL en Ontario, California, vi esta escena con mis propios ojos: treinta o cuarenta paquetes apilados en la estación de empaque, un operador escaneando cada uno con un lector manual, el sistema mostrando "etiqueta creada" para cada pedido — pero solo la mitad de las etiquetas estaban realmente sobre la mesa. La impresora alimentaba el papel sin problemas. Simplemente... faltaban. Las llamadas del servicio de atención al cliente ya estaban llegando: compradores preguntando por qué su seguimiento nunca se actualizaba. Esa tarde desarmamos toda la cadena, y al final el transportista no tuvo nada que ver. Nuestra propia lógica de reintentos no enviaba clave de idempotencia. Una solicitud con tiempo de espera agotado en realidad había tenido éxito en el lado del transportista; el sistema asumió un fallo y volvió a disparar. La segunda llamada devolvió la misma etiqueta, sobrescribió el primer registro, y el primer paquete ya había salido con la otra etiqueta impresa pegada. La que no cuadraba era la etiqueta sobrescrita.
Mi veredicto de entrada: cuando las API de etiquetas del transportista "pierden" etiquetas, el 90% de las veces no es culpa del transportista — es tu lógica de reintentos y tu máquina de estados. Del 10% restante, unas siete partes son la cola de impresión y tres partes el lado del transportista. ¿Suena agresivo? Llevo veinte años en almacenes de EE. UU. e integrado más API de etiquetas de las que puedo contar con dos manos. La causa raíz siempre es uno de los seis pasos siguientes. Aquí va una cadena de depuración del síntoma a la causa raíz, en orden. Una tarde basta para localizarla.
No culpes aún al transportista: revisa tus logs de solicitudes
Cuando algo se rompe, el paso uno son siempre los logs. No el panel del transportista — el registro de tu propio sistema sobre si la solicitud de etiqueta realmente salió y qué te devolvió el transportista.
Dónde mirar: la tabla de logs de API de tu WMS o tu middleware. Cómo se ve sano: cada llamada tiene un registro con marca de tiempo, número de pedido, cuerpo de la solicitud, cuerpo de la respuesta, código de estado HTTP y latencia. Revisa tres cosas.
Primero, ¿se guardan completas la solicitud y la respuesta? Hay muchos sistemas que solo almacenan "éxito/fallo" y tiran el cuerpo de la respuesta. Eso es una caja negra. Depurar etiquetas perdidas sin pares completos de solicitud/respuesta es básicamente adivinar. El peor caso que vi solo registraba el número de pedido y "OK" — cuando algo se rompía, el equipo tenía que conciliar pedido por pedido en el portal del transportista. Eso convirtió una tarde en tres días.
Segundo, ¿hubo tiempos de espera agotados y cuántos reintentos? Los timeouts en las API de etiquetas son normales; los transportistas se ponen lentos en temporada alta, a veces más de 10 segundos. La verdadera pregunta: ¿reintentaste después del timeout y el reintento llevaba una clave de idempotencia? Un timeout no es un fallo — la solicitud bien pudo tener éxito en el lado del transportista mientras tu sistema nunca recibió la respuesta. Un reintento a ciegas entonces imprime dos etiquetas — o peor, dos etiquetas compartiendo un número de seguimiento, con tu sistema reconociendo solo la segunda. La primera etiqueta se convierte en un fantasma: físicamente pegada en un paquete, invisible para tu sistema.
Tercero, ¿el número de seguimiento de la respuesta coincide con el que guarda tu sistema? Algunas integraciones confunden el número maestro de seguimiento del transportista con el número a nivel de paquete y guardan el campo equivocado. La etiqueta no se perdió — estás buscando en el lugar equivocado.
Si tus logs están completos, solo este paso revela el problema el 80% de las veces. Si están incompletos, arregla el logging antes de depurar cualquier otra cosa — sin datos, toda conclusión es superstición.
Si un pedido llega a la API dos veces, ¿cuántas etiquetas salen?
Paso dos: idempotencia. Esta es la zona de desastre, y es la causa raíz de la historia con la que abrí.
Cómo se ve sano: el mismo número de pedido golpeando la API cualquier número de veces produce exactamente una etiqueta válida en el lado del transportista; las llamadas repetidas devuelven el primer resultado en lugar de acuñar una etiqueta nueva. Esa garantía viene de una clave de idempotencia — normalmente el número de pedido más un identificador único de negocio, enviado con la solicitud.
Dónde mirar: tu envoltorio de API — ¿la solicitud de etiqueta realmente transmite un campo de idempotencia? La mayoría de las API de etiquetas de transportistas lo soportan (revisa la documentación más reciente del transportista para el nombre exacto del campo), pero muchas integraciones de almacén nunca lo envían. La variante más traicionera: lo envías, pero con la granularidad equivocada. Usar "número de pedido + marca de tiempo" como clave, por ejemplo — la marca de tiempo es distinta cada vez, así que es lo mismo que no enviar nada. Cada reintento acuña una etiqueta nueva.
Cómo verificarlo: toma un pedido con etiqueta perdida y cuenta cuántas veces se llamó a la API en los logs, y si cada llamada devolvió el mismo número de seguimiento. Dos llamadas que devuelven dos números de seguimiento distintos, con solo el segundo guardado en tu sistema — la etiqueta del primer número de seguimiento es tu "perdida". Realmente existe, pegada en algún paquete. El paquete se envió; tu sistema no lo sabe. Lo que ve atención al cliente es "etiqueta creada pero sin actualizaciones de seguimiento".
Y un último seguro a nivel de base de datos: la columna de etiqueta/número de seguimiento necesita una restricción de unicidad. Sin ella, las escrituras duplicadas nunca dan error — los datos sucios se acumulan en silencio, y cuando lo notas, nada cuadra. Agregar esa restricción no cuesta nada y paga de inmediato.
Etiqueta generada, estado nunca escrito: revisa tu máquina de estados
Paso tres: callbacks asíncronos y la máquina de estados. Algunas API de etiquetas son asíncronas: envías la solicitud, el transportista responde "aceptado", y el archivo real de la etiqueta y el número de seguimiento llegan por callback segundos o minutos después.
Cómo se ve sano: el estado del pedido fluye limpio — digamos, pending → creating → created → printed — cada transición con su marca de tiempo. Si el callback aún no llegó, el pedido debería estar en "creando", no haberse convertido de alguna forma en "creado".
Dónde mirar: el log de transiciones de estado. Cuidado con los estados saltados: el callback nunca llegó, pero el estado dice "creado". Eso suele ser un trabajo de polling demasiado optimista o lógica del frontend que marca éxito en el momento en que se envía la solicitud, sin esperar el callback.
La variante más desagradable: el callback llegó, pero tu endpoint de callback dio error — un fallo de verificación de firma, un timeout por bloqueo de base de datos — así el transportista muestra "entregado" mientras tu lado nunca lo guardó. Cada lado cuenta su propia historia. Revisa los logs de error del endpoint de callback; la evidencia casi siempre está ahí. Nadie la estaba leyendo.
Mi veredicto: la máquina de estados es lo que más vale la pena hacer bien en el flujo de etiquetas. Una máquina de estados que permite estados saltados no es una máquina de estados.
La impresora: el chivo expiatorio más injusto
¿Los tres primeros pasos están limpios? Mira la impresión. Las impresoras Zebra pierden trabajos más a menudo de lo que crees.
Cómo se ve sano: el archivo de la etiqueta entra en la cola de impresión, la impresora escupe hojas una por una, y cada hoja recibe una confirmación de impresión. Dónde mirar: el log de cola del servidor de impresión — ¿cada trabajo está "completado" o sentado en "error/cancelado"? Las impresoras Zebra tienen un hábito clásico: se acaba la cinta o el papel de etiquetas, el cabezal se sobrecalienta, y en lugar de avisar a gritos, el trabajo simplemente se atasca en la cola mientras el frontend dice "enviado". El operador no ve papel, asume que el sistema nunca creó la etiqueta, y le da a imprimir de nuevo — y sin un handshake de confirmación de impresión, eso imprime un duplicado.
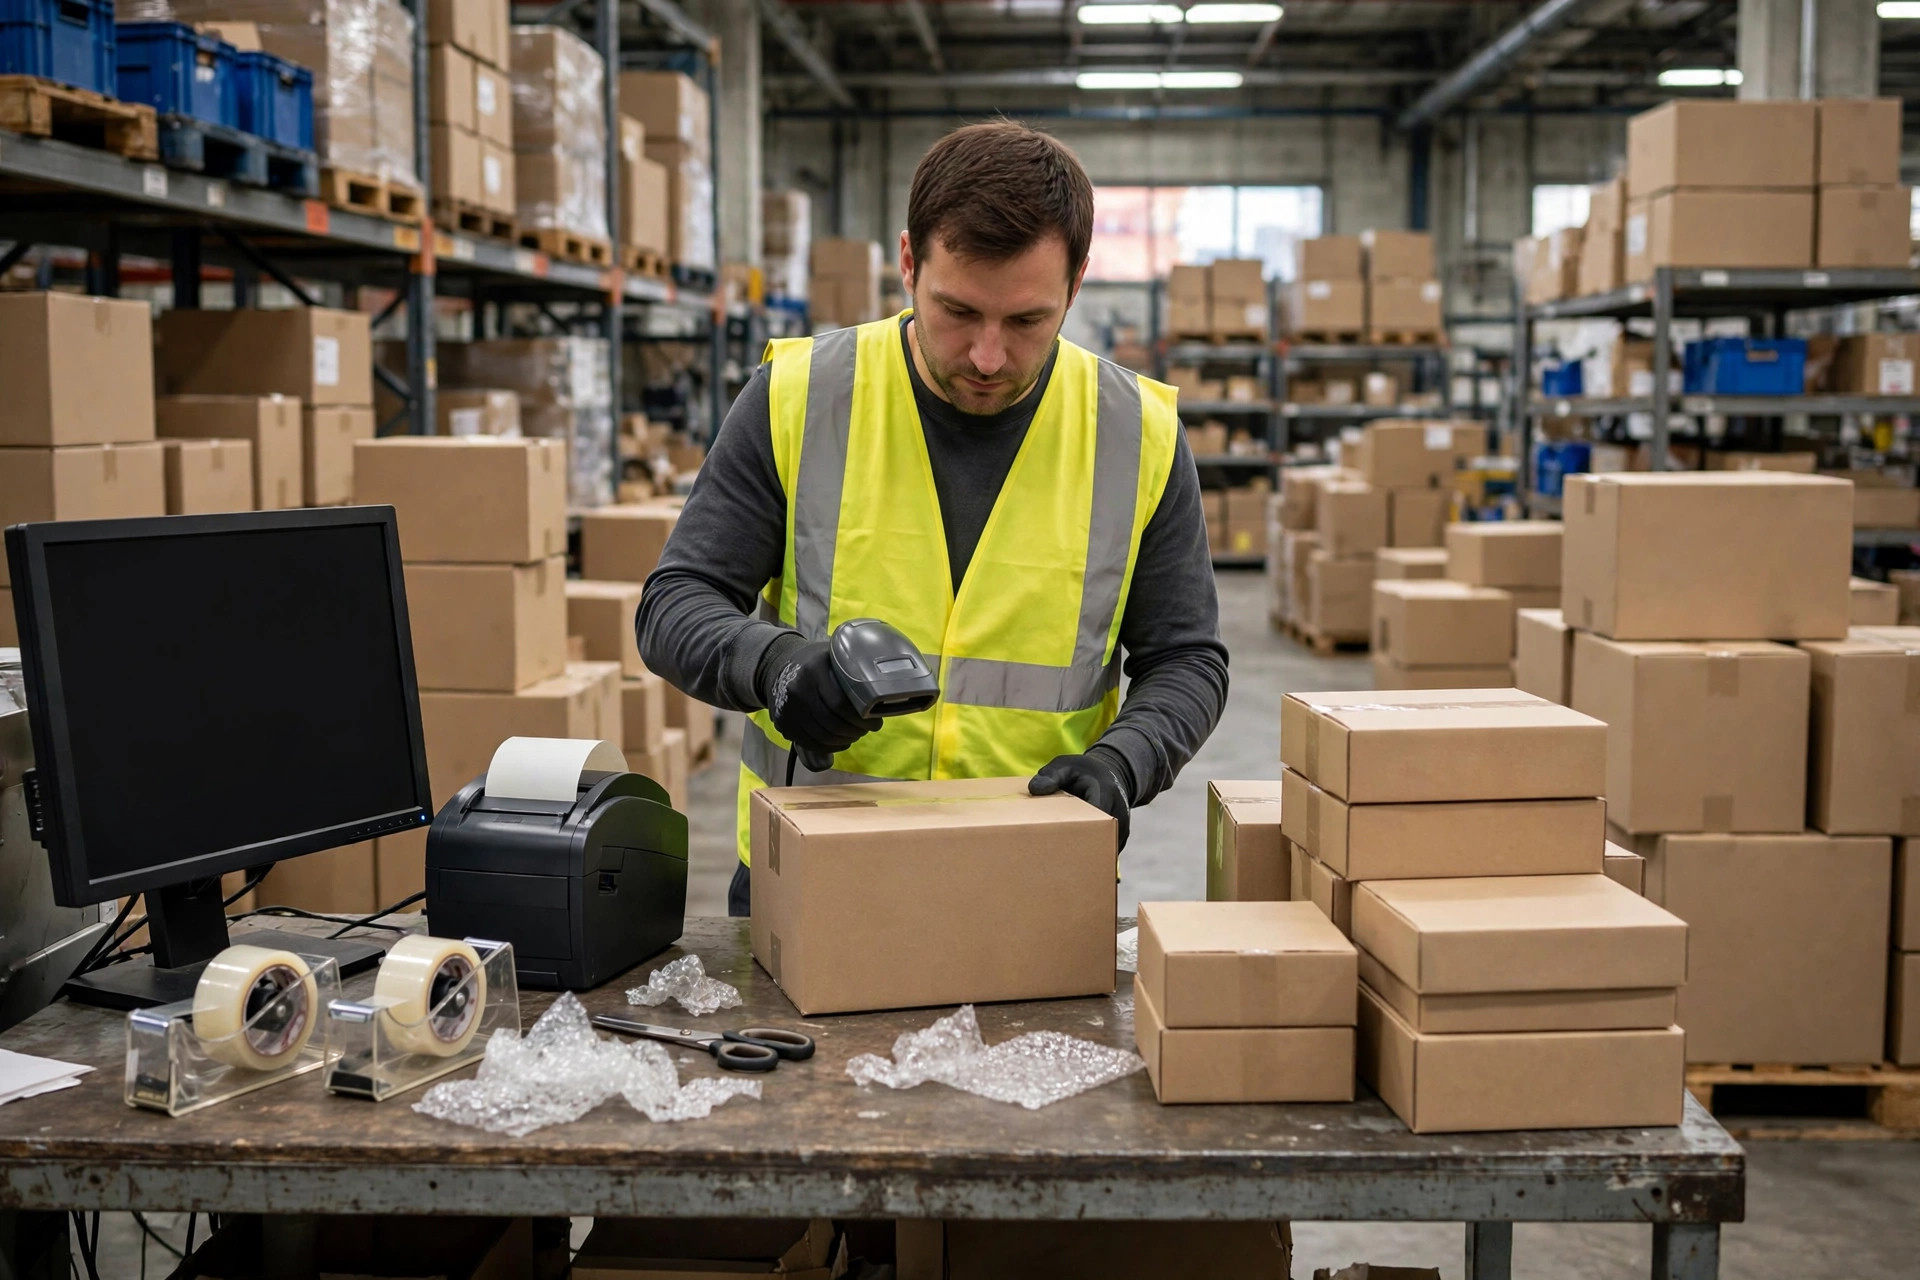
Otro clásico: una impresora de red se cae y reconecta, y todo el atraso de la cola sale de golpe. El operador arranca unas cuantas, las pega, y el resto se mezcla — etiquetas mal pegadas y perdidas por todas partes. Por eso mi lista de prevención insiste en un acuse de confirmación de impresión: la impresora confirma cada hoja, y solo entonces el sistema avanza el estado a "impreso". Una impresión sin acuse es una impresión que nunca existió.
El lado del transportista: límites de velocidad y validación de direcciones, tragados en silencio
Finalmente, el transportista. La conclusión honesta: las causas genuinas del lado del transportista son raras — unas pocas veces al año como mucho. Pero son las más difíciles de investigar, porque el problema no está en tus manos.
Dónde mirar: los registros de llamadas API y códigos de error del portal de desarrolladores del transportista. Enfócate en dos categorías.
Primero, el límite de velocidad. En temporada de promociones y picos, tu QPS supera la cuota de la cuenta y el transportista rechaza la solicitud. Algunos devuelven un 429 limpio; otros — lo diré claro — un transportista importante devuelve 200 en ciertos endpoints cuando está limitado, con un mensaje de error silencioso metido en el cuerpo. Si tu código solo revisa el estado HTTP, cree que la etiqueta se creó. No se creó. Eso es un fallo silencioso; al investigar, lee el cuerpo de la respuesta, no solo el código de estado.
Segundo, fallos de validación de direcciones. Las direcciones de EE. UU. son delicadas — un dígito mal en el apartamento o número de suite, un ZIP+4 que no coincide, y la validación del lado del transportista rechaza el pedido. Eso debería volver como un error de dirección claro, pero algunas integraciones tragan los errores de validación como excepciones genéricas, registrando solo "error al crear la etiqueta". El operador ve el fallo, ingresa el pedido manualmente — con una dirección ligeramente distinta a la del registro del sistema — el paquete se envía, y nada cuadra. Para esta categoría, validar la dirección por adelantado importa diez veces más que depurar después.
No voy a citar tarifas ni números de límites específicos aquí; las políticas de los transportistas cambian rápido, así que guíate por la política publicada más reciente en su sitio oficial.
Concilia a diario: la última red de seguridad, y lo primero que deberías haber construido
Paso seis, y el que más quiero que lances mañana: concilia tu conteo de etiquetas contra la factura del transportista todos los días.
La lógica es simple: el conteo de "etiquetas creadas" de ayer en tu sistema debería igualar el conteo de etiquetas de ayer en la factura del transportista. Donde difieran, la diferencia son tus etiquetas perdidas — sea cual sea el paso de la cadena que se las tragó, los números no mienten.
Cómo hacerlo: escribe un trabajo de conciliación diaria que descargue de noche la factura o reporte de uso del transportista (la mayoría de los portales de transportistas exportan uno) y lo coteje registro por registro contra tus registros de etiquetas por número de seguimiento. La lista de excepciones cae en la bandeja de operaciones y TI cada mañana. La primera ejecución puede asustarte — eso es deuda histórica saliendo a la luz de golpe, lo cual es bueno. Significa que el mecanismo funcionaba desnudo antes.
Recomiendo dos niveles de alerta. Nivel de negocio: alerta si no se crea ninguna etiqueta durante 10 minutos en horario operativo — una estación de empaque no puede pasar 10 minutos sin una sola etiqueta en operación normal, así que un disparo casi seguro significa que la API está caída. Nivel de conciliación: escala a un humano si el conteo diario de excepciones supera 5. Ajusta los umbrales a tu volumen, pero ten umbrales. Monitoreo sin umbrales no es monitoreo.
La lista de prevención: haz estas cinco y las etiquetas perdidas básicamente desaparecen
Depurar cura la enfermedad; prevenir te mantiene sano. Cinco puntos, ordenados por retorno:
| Punto | Qué hacer | Costo |
|---|---|---|
| Política de reintentos por timeout | Reintentar solo en timeout, siempre con clave de idempotencia; máximo 3 reintentos con backoff exponencial | Medio día de desarrollo |
| Unicidad del número de seguimiento | Índice único en la columna de número de seguimiento; las escrituras duplicadas fallan con ruido | Minutos |
| Endurecer la máquina de estados | Sin estados saltados; los pedidos se quedan en "creando" hasta que llega el callback, luego escalar a revisión manual al expirar el callback | 1–2 días |
| Acuses de confirmación de impresión | Las confirmaciones de la impresora dirigen la transición de estado; sin acuse significa "no impreso" | Requiere cooperación del servidor de impresión |
| Trabajo de conciliación diaria | Comparar automático de noche, enviar la lista de excepciones por correo, escalar más allá de 5 excepciones | 1 día |
Además: guarda logs completos de solicitud/respuesta por al menos 90 días. No te quejes del almacenamiento. Cuando una disputa por etiqueta perdida caiga en tu escritorio, esos logs son tu evidencia.
Una pregunta real para dejarte: esta noche, ve a revisar cuántos de tus pedidos llegaron a la API de etiquetas más de una vez en el último mes. Ese número es el límite superior de tu población de etiquetas fantasma. Puede que pierdas el sueño por eso — pero igual es mejor que que te despierte atención al cliente.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.