La conclusión por adelantado: la optimización del slotting es uno de los casos de uso de la IA en un almacén más fáciles de justificar con un ROI duro. Dos condiciones: tus datos no pueden ser basura, y no esperes que el algoritmo tome decisiones por ti. Es un analista incansable, no un jefe.
Los últimos años han traído un desfile de historias de IA en almacenes — inspección por visión, carretillas autónomas, picking por voz. Demos emocionantes, todas. Pero en mi experiencia, el proyecto de IA que realmente hace que los operadores de almacenes pequeños y medianos abran la cartera es mucho menos glamuroso: un algoritmo que te dice dónde debe vivir cada SKU. Las cuentas son simplemente más fáciles de creer. Cada paso que un preparador no camina es dinero.
Qué consume realmente el algoritmo
Permíteme desmitificarlo primero: los algoritmos de slotting no son magia. Un responsable de almacén veterano con diez años de Excel podría construir a mano el 70 u 80 por ciento del resultado. La ventaja de la IA no es ser más lista — es recalcularlo todo cada semana sin aburrirse. Ningún humano tiene la resistencia para eso.
Las entradas son cuatro cosas. Primero, el historial de líneas de pedido: cuántas veces se pidió cada SKU en los últimos meses. Eso es el núcleo de todo. Segundo, la frecuencia de picking por piezas — y nota, son líneas de picking, no unidades enviadas. Un SKU que envía 100 unidades en un pedido cuesta un viaje a la ubicación; un SKU pedido 50 veces al día como pedidos de una sola pieza cuesta 50 viajes. El segundo pertenece cerca del inicio del recorrido de picking. Tercero, la afinidad de SKU: los artículos que se compran juntos con frecuencia deben vivir juntos. El algoritmo lo llama afinidad; los preparadores lo llaman "cómodo". Cuarto, atributos físicos: dimensiones, peso, ubicación del hueco — lo pesado va abajo, lo voluminoso no cabe en huecos pequeños.
Las salidas son refrescantemente prácticas: una recomendación de reubicación ABC (qué SKU pertenecen a la zona dorada de picking), una lista de ajustes de caras de picking frontal y sugerencias de reposición. Nota la palabra "recomendación". La mejor implementación que he visto: cada lunes por la mañana el sistema produce una lista de sugerencias, el responsable de almacén dedica 30 minutos a revisarla y decide qué ejecutar. Esa media hora de juicio humano cubre exactamente lo que le falta al algoritmo — no sabe nada de la promoción de la próxima semana, y no sabe que un proveedor va a cambiar el embalaje de un producto.
Un ejemplo concreto: un centro de distribución de comercio electrónico que vende artículos para el hogar descubrió gracias al algoritmo que las sábanas ajustables y las fundas de almohada aparecían juntas en el 70% de los pedidos. Moverlas a caras de picking adyacentes redujo la distancia recorrida para esos pedidos en casi un tercio. Un humano podría haberlo pensado — pero ningún cerebro puede calcular las combinaciones por pares de 8,000 SKU.
Las cuentas del ROI: las millas no caminadas son dinero
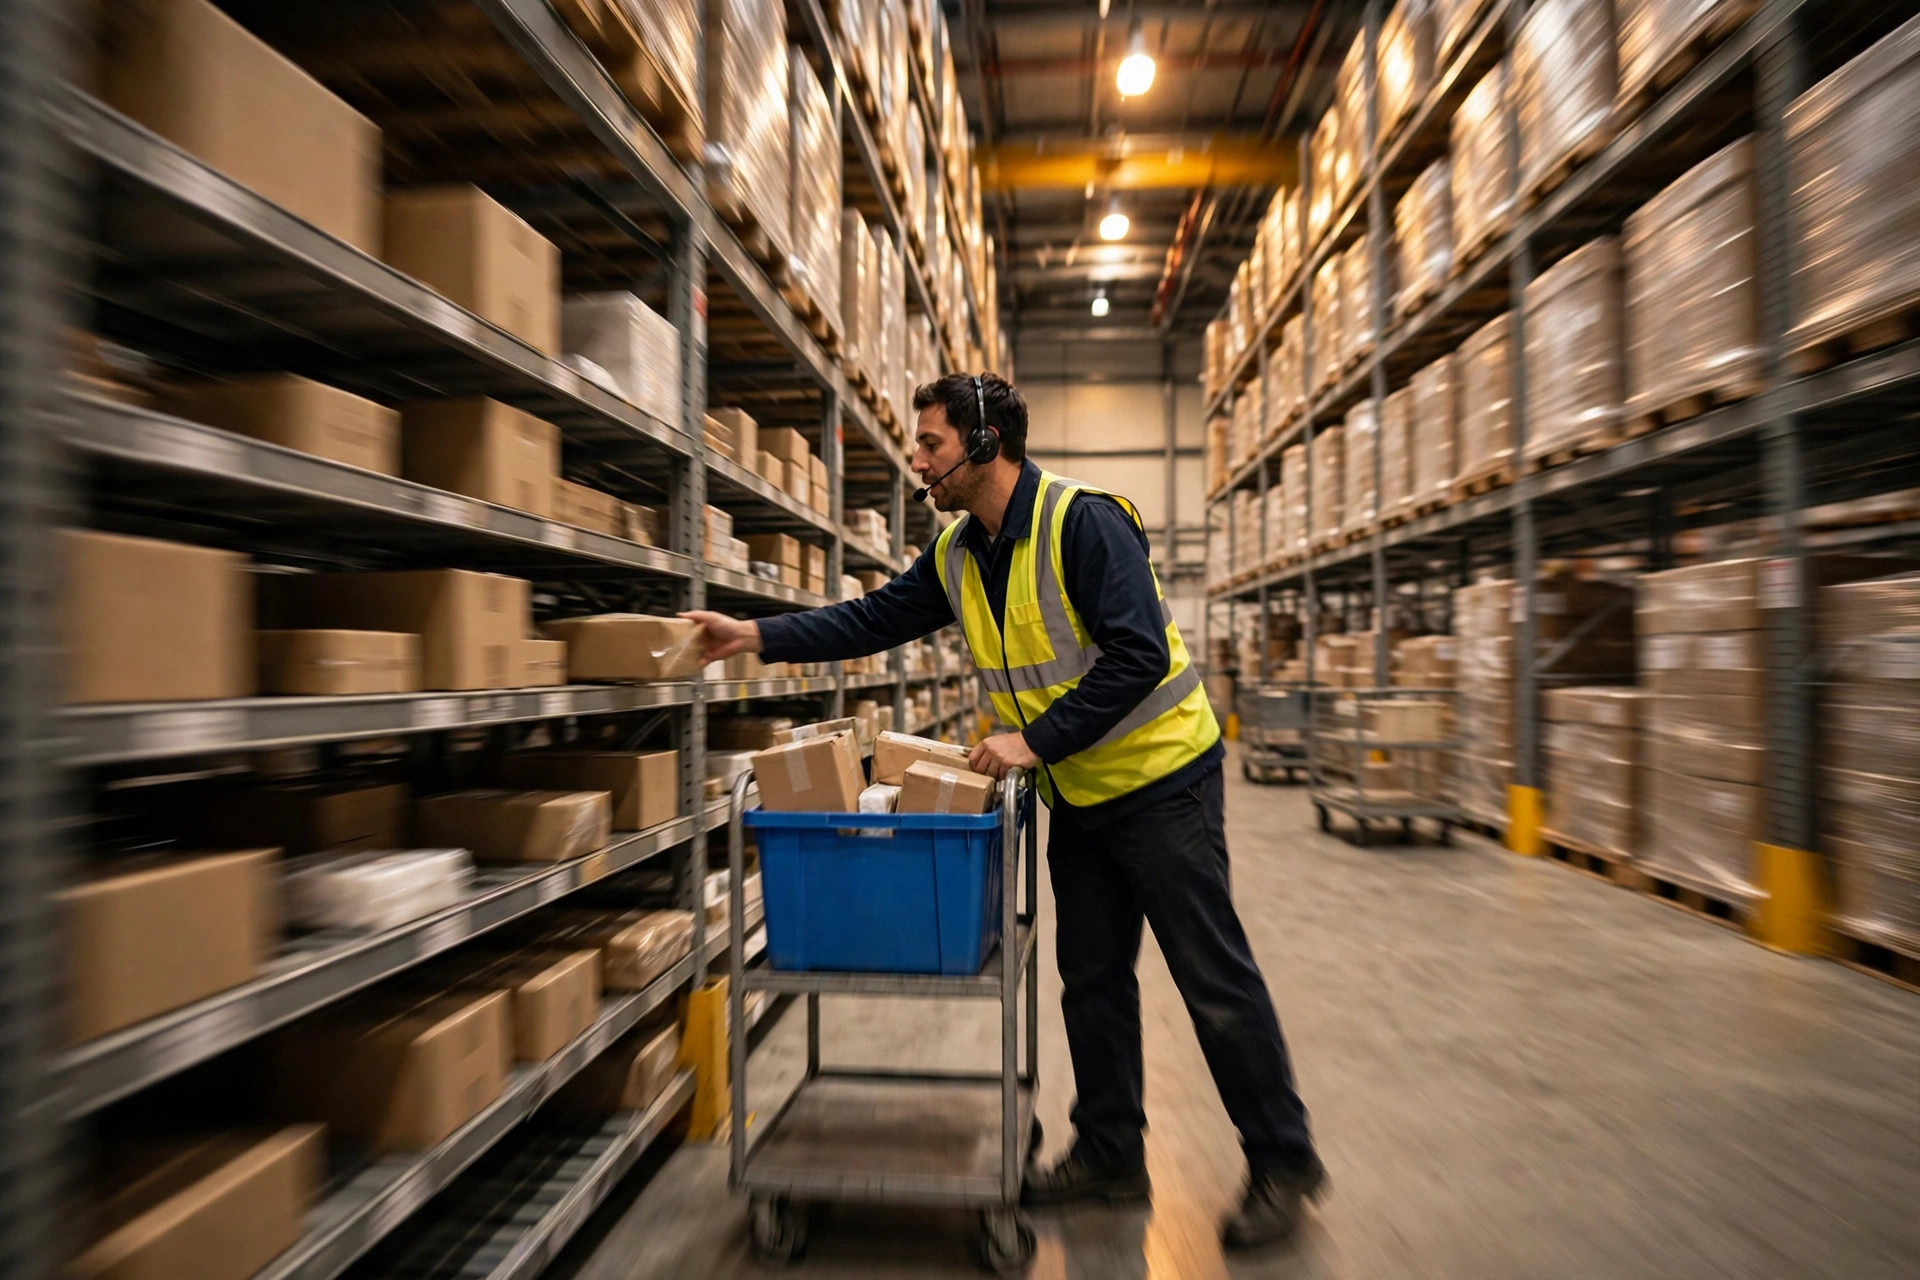
Te doy el marco. El picking es el trabajo manual más caro de un almacén, y los estudios de campo muestran de forma consistente que los preparadores caminan millas por turno, con más de la mitad de su tiempo dedicado a desplazarse en lugar de recoger. La optimización del slotting lleva los productos de alta rotación a la puerta del preparador y empuja los de baja rotación al fondo. Un rango de mejora típico que veo citado es de un 10 a 20 por ciento menos de distancia recorrida. Suena modesto hasta que lo multiplicas por plantilla y salario por hora.
En el lado de los costes, esta capacidad viene como un módulo de slotting dentro de tu WMS o como una suscripción SaaS independiente, con precio según el tamaño de la instalación y el número de SKU — pide el precio actual al proveedor. Mi regla de oro es directa: compara el coste anual del software con las horas de mano de obra ahorradas multiplicadas por tu tarifa salarial. ¿Retorno en menos de un año? Adelante. ¿Más de dos años? Haz una prueba piloto primero.
Para verificar los resultados, hay un método poco glamuroso que funciona: el modo sombra. Todavía no actúes sobre las sugerencias del algoritmo — ejecútalas contra dos semanas de pedidos históricos reales y compara la distancia total recorrida con el "diseño sugerido" frente al "diseño actual". Aún mejor, haz una prueba A/B: dos zonas de picking comparables, una siguiendo el algoritmo, otra haciendo las cosas a la antigua, durante un mes. Compara la productividad del picking y las tasas de error. Los números hablarán más alto que cualquier presentación de ventas.
Aquí un marco de costes: un centro de distribución de comercio electrónico mediano con 40 preparadores. Si la optimización ahorra a cada preparador 20 minutos de caminata al día, multiplica las horas anuales ahorradas por tu tarifa salarial y compáralo con el coste anual del software. La trampa: el tiempo ahorrado debe medirse — usa podómetros o las marcas de tiempo de las tareas del WMS durante el piloto, no estimaciones a ojo.
¿Dónde falla? Tres trampas que he visto de cerca. Primera, datos sucios: códigos de barras mal etiquetados, registros de ubicación incorrectos, devoluciones nunca guardadas. Basura entra, basura sale — consigue una precisión de inventario superior al 95% antes de empezar, o ni lo intentes. Segunda, el arranque en frío de los productos nuevos: un SKU nuevo no tiene historial de pedidos, así que el algoritmo no sabe nada de él. Ubícalo por criterio de categoría, revísalo en un mes. Tercera, la estacionalidad: el hueco del producto estrella de Navidad se convierte en peso muerto en enero. Un algoritmo que promedia todo el año hará sugerencias tontas — las buenas soluciones segmentan por temporada, o al menos te dejan fijar manualmente los SKU estacionales.
No lo despliegues en todo el almacén el primer día
Esta es la parte que más quiero que escuches: empieza por tu zona de picking más dolorosa, no por todo el edificio. Una categoría, un área, cuatro a seis semanas, deja que los datos decidan. Si funciona, amplía. Si no, tus pérdidas están contenidas.
Y un juicio sobre el encaje: los centros de fulfillment B2C y las operaciones 3PL de SKU mixtos con mucho picking por piezas ven las mayores ganancias. ¿Una operación mayorista que mueve palets completos de entrada y salida? Pásala — apenas hay recorrido de picking que optimizar, y el dinero del software probablemente se irá por el desagüe.
Tu primer paso concreto, posible esta noche: exporta 90 días de datos de líneas de pedido y comprueba qué proporción de líneas de picking representa el 20% superior de SKU. ¿Más del 60%? Tus productos de alta rotación probablemente están dispersos por el edificio y tu slotting es un desastre — vale la pena intentarlo. ¿Solo un 30%? Tu velocidad de SKU es plana, el algoritmo no puede ayudarte mucho, y deberías gastar el dinero en otra cosa.
El paso dos es la selección del proveedor, y ahora negocias desde la fuerza: trae tus datos piloto y pide precios basados en resultados o al menos una prueba de tres meses. Los proveedores dispuestos a ligar los honorarios a los resultados suelen tener un algoritmo de verdad; los que solo hablan de licencias a menudo venden una hoja de cálculo disfrazada de IA.
Una última precaución: no ejecutes los movimientos todos a la vez. Reubicar cientos de huecos en una semana deja a los preparadores perdidos durante días, las tasas de error se disparan y tus datos piloto quedan arruinados. Mi regla: mueve un lote de productos de alta rotación por semana, dale al personal tres días para adaptarse. Despacio es fluido, fluido es rápido.
Traducido del inglés. En caso de discrepancia, prevalece la versión en inglés.