有个仓的WCS一天吐出4000多条报警,运维小哥直接把声音关了。
那是2019年,芝加哥南郊一个30万平方英尺的自动化仓,刚上了一套新的分拣线。WCS(仓库控制系统)负责指挥输送线、扫码、合流分流,几百个光电开关、几十台电机、上百个通信节点,每一个状态变化都往中控室推一条报警。光电开关被灰尘糊住误报一条,电机电流抖一下报一条,某个PLC心跳晚了200毫秒也报一条。一天下来4000多条,屏幕根本翻不过来。
报警太多,人就学会了无视。最危险的不是误报,是真报警混在4000条里没人看。那个仓后来有一次分拣机堵包,报警早在15分钟前就推出来了,中控室没人注意到,最后堵了半条线,停了40分钟。那天我正好在现场,运维主管跟我说:"老米,不是我不看,是看了也白看。"
这就是报警淹没。解决它不靠加人,靠分级和收敛。
别分五级,三级就够了
很多WCS厂商默认给报警分四五级:紧急、重要、一般、提示、信息。听起来细,实际没用。值班的人记不住五级的区别,最后全当一个级别处理。
我只用三级:
致命:会停线或涉及安全的。 电机过载跳闸、急停被拍下、安全光栅被遮挡、主PLC通信中断。这类报警必须带声音、弹大屏,15分钟没人确认就自动升级打电话。我定的规矩是:致命报警一天超过3条,说明设备本身有问题,不是报警系统的问题。
举个例子:安全光栅被遮挡必须进致命级。自动化设备的安全联锁是合规红线,光栅失效时设备必须停机,如果这类报警只是"提示"级别,等于把合规风险藏进了日志里。这种报警我要求直接走安全PLC的硬联锁,不经过WCS的软件分级——软件分级是给人看的,安全联锁是给机器执行的,两回事。
影响生产:线没停,但效率掉了。 某个滑槽满了自动改道、扫码率掉到95%以下、某段输送线降速运行。这类报警推到中控大屏和值班手机,不响铃。当班必须在1小时内处理或记录原因。
提示:只记日志,不打扰人。 光电开关单次误触发、通信节点一次重连成功、电机电流短暂波动。这类占总量的九成以上。它们唯一的用处是事后分析,别让它们出现在任何人的屏幕上。
分级标准我只看一个:这条报警如果没人看,会不会在2小时内变成钱的问题。会,就是前两级;不会,就是提示。
那个芝加哥的仓,我们花了两周把4000多条报警按这个标准重分了一遍。结果是:致命级11条,影响生产级87条,剩下3900多条全是提示。运维小哥把声音重新打开了——因为现在响的每一条都值得他站起来。
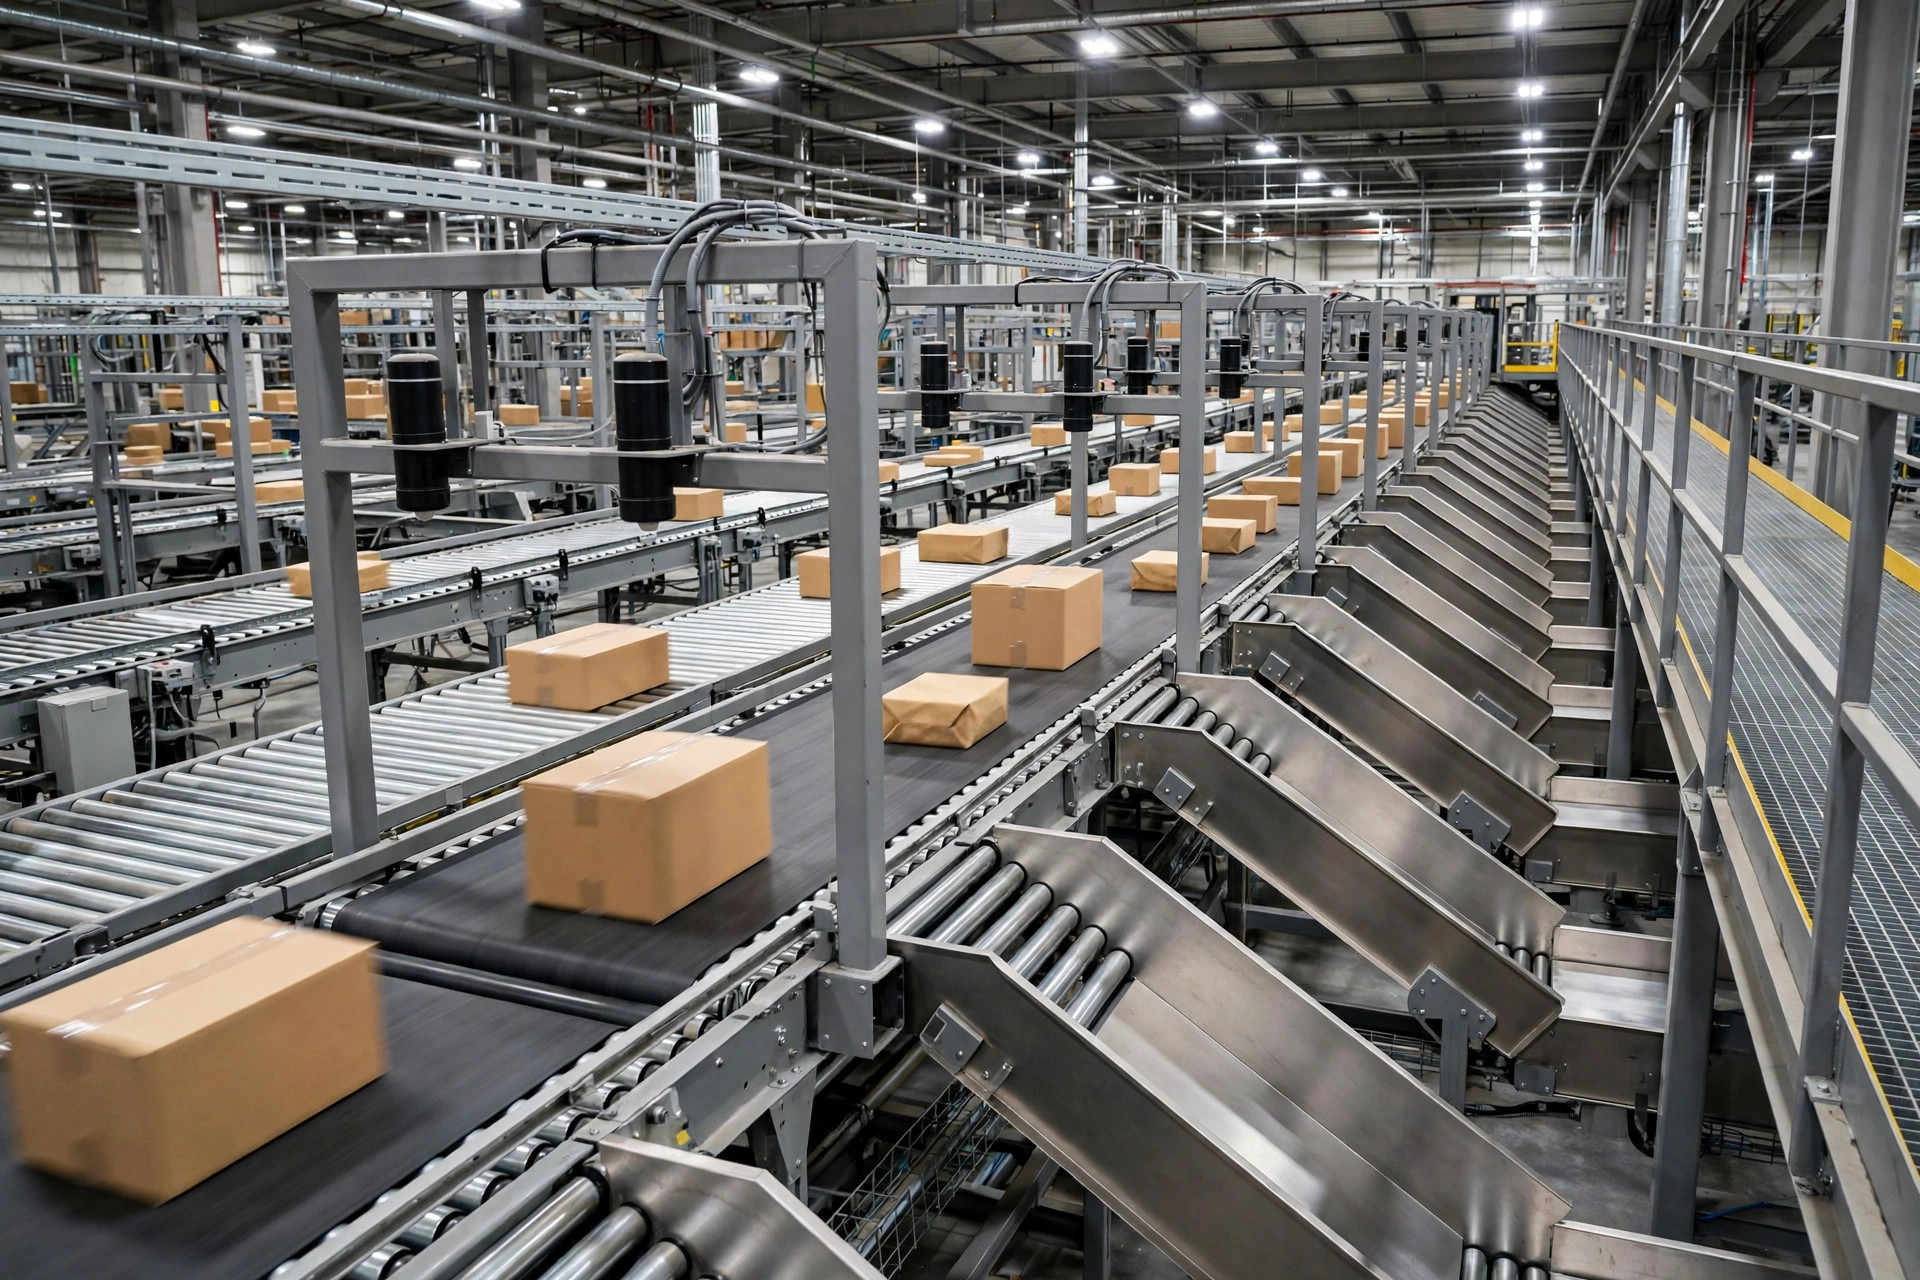
5个报警,其实是1个光电开关歪了
分级解决的是"看不过来",收敛解决的是"修不过来"。
有一次夜班,中控室一小时内冒出200多条报警:A段扫码失败、B段合流超时、C段电机过载、D段通信抖动、E段包裹滞留。值班的两个人分头跑,跑了一晚上,线还是时好时坏。天亮我去看了一眼,发现5种报警全指向同一个区域:3号合流口的一个光电开关被托盘撞歪了3毫米。开关歪了,扫码时序错了,时序错了合流就乱,合流乱了电机就憋,电机憋了通信就抖。一颗螺丝没拧紧,200条报警。
这就是WCS报警最常见的真相:报警是按设备报的,故障是按因果链传的。 一条报警对应一个设备,但一次故障会沿着因果链炸出一串报警。
我的收敛方法很土,但管用:每天下班前,把当天的报警按"设备位置+时间窗口"聚一聚。同一区域10分钟内冒出3种以上不同类型的报警,先别一个一个修,去现场看那个区域,大概率是一个根因。我还让运维建了一张"报警家谱":哪个光电开关歪了会连带出哪几个报警。建了三个月之后,值班的人看到报警组合就能猜到根因,平均定位时间从40分钟压到了10分钟以内。
还有一条铁律:同一个设备24小时内重复报提示级报警超过20次,自动升级为影响生产级。 光电开关偶尔误报是灰尘,天天误报就是松了或者要换了。别让"提示"变成"慢性病"。
建家谱还有个副产品:备件计划。哪个光电开关反复上榜,仓库就多备两个;哪台电机的过载报警从提示级往上爬,就提前安排维保窗口。报警数据用好了,备件库存能压下来不少。那个芝加哥的仓,一年后备件费用降了将近两成——这个数字是运维主管年底跟我聊时说的,我没去财务核过,就当个参考。
报警分级之后,MTTR才有意义
MTTR(平均修复时间)是很多仓的KPI,但报警没分级之前,这个数字是假的。4000条报警里混着3900条提示,MTTR算出来很漂亮——因为提示级"修复"得很快(看一眼就关了)。真出事的时候,MTTR一点参考价值没有。
分级之后,MTTR要分开算:致命级单独算,影响生产级单独算,提示级不算。那家芝加哥的仓,分级前全口径MTTR是22分钟,看着不错;分级后才发现,致命级报警的真实MTTR是55分钟——因为之前大家根本没在第一时间看到它们。分级三个月后,致命级MTTR压到了15分钟以内。不是人变勤快了,是报警终于推到了对的人面前。
报警和MTTR的联动,我只做三件事:致命报警自动建维修工单并计时;影响生产报警超时未处理自动升级;每周一把三级报警的数量和MTTR摆在一起看,数量涨了但MTTR没涨,说明分级阈值可能松了。
报警会自己长回来,记得定期除草
分级不是一劳永逸的。设备会老化,产线会改造,WCS升级会带来新的报警点。那个芝加哥的仓,分级半年后,报警总量又从每天100多条爬回了800多条——不是分级失效,是新上了一条合流线,厂商工程师把默认报警全打开了,没人去关。
我现在的做法是每季度做一次报警审计:导出90天数据,看有没有新的报警源挤进Top 20,看致命级的数量有没有悄悄变多。审计不超过半天,但能防止系统慢慢回到淹没状态。
还有一个坑:WCS厂商的远程运维。很多厂商的维保合同里含远程监控,他们的工程师为了"不错过任何问题",会定期把你关掉的提示级报警重新打开。下次厂商远程连进来做完维护,花10分钟核对一下报警配置,把被打开的再关回去。这事我吃过两次亏,第三次学乖了。
起手清单:第一周就干这五件事
如果你仓的WCS也在报警淹没里,别搞大项目,先干这五件:
- 导出最近7天的全部报警,按数量排序。 前20个报警源通常占总量的八成,先处理它们,见效最快。
- 把"提示级只进日志"先落地。 这是投入产出比最高的一刀,一天就能把屏幕清干净。注意:关的是推送,不是记录,日志必须全留着。
- 给致命级配上真正的升级路径。 声音+大屏+15分钟无人确认自动打电话。没有升级路径的分级等于没分。
- 建报警家谱。 从最常见的5个报警组合开始写,一个月内扩到20个。这是运维团队最值钱的知识资产。
- 每周复盘一次Top 10报警源。 同一个光电开关连续两周上榜,就不是"误报",是该换了。报警复盘会只开15分钟,只看Top 10,只定动作。
最后说一句判断:WCS报警淹没从来不是技术问题,是管理问题。4000条报警里,3900条是系统在自言自语,100条是真话。你要做的不是让系统少说话,是让真话能被听见。