结论先说:上架策略的核心不是把货塞进空库位,而是给三个月后的拣选排队。新货今天放在哪里,三个月后拣选员每天就要多走多少路、弯多少次腰,基本已经定了。放对了,拣选自然快;放货图省事,拣选再怎么优化流程也补不回来。
我做 WMS 上线这些年,见过太多仓库把放货当成收货后的收尾动作:叉车司机凭感觉找个空位一放,系统里库位是对的,货也确实在库里,账面上一切正常。三个月后问题才冒出来:爆款 SKU 散在七八条巷道里,一张订单要跑半个仓库;重货放在高层,拣选员每天爬上爬下;慢动销的货占着离打包台最近的黄金位置,快动销的货反而在最远的角落。这不是拣选员不努力,是放货那天就把路走错了。
上架之前,先算流速:快动销的货才配住好位置
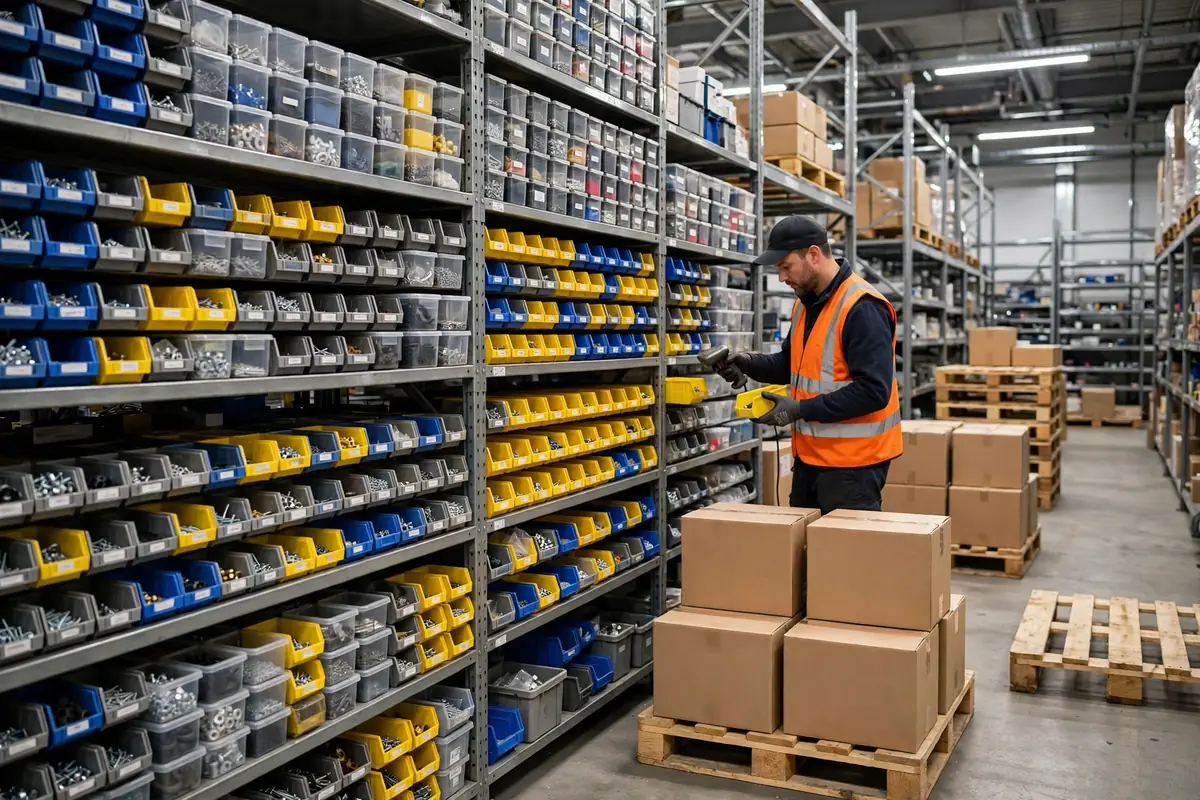
排位的第一步不是看哪里有空位,而是看这个 SKU 有多能跑。行业里常用的做法是按拣选行数把 SKU 分成快、中、慢三档:大约两成的 SKU 贡献了八成左右的拣选量,这个比例在很多仓库的实测里反复出现。快动销的 SKU 数量不多,拣选次数却占大头,把它们放在离打包台最近、腰到肩膀高度的区域,回报最大。
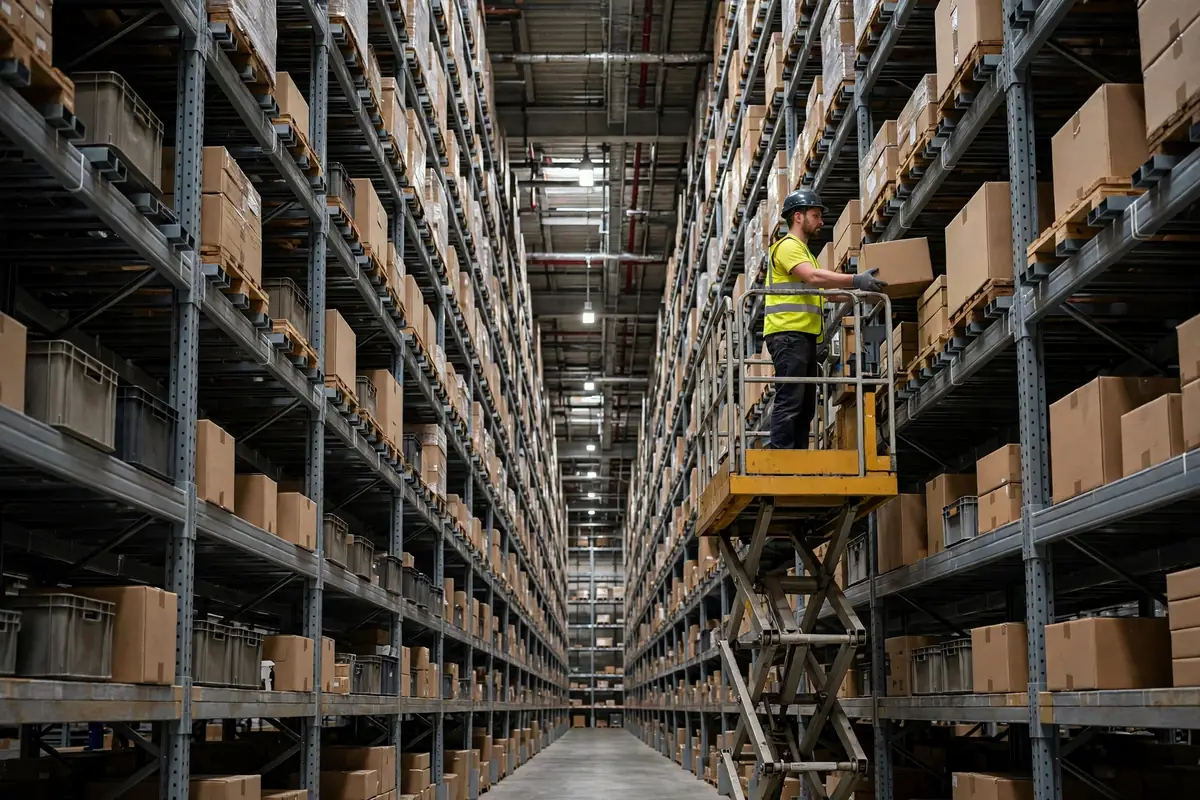
黄金高度带大约在离地 60~160 厘米之间,也就是膝盖到眼睛的范围。这个高度带的拣选动作最省力,行业资料里给出的参考是:这个高度取一件货大约 3~5 秒,地面层或者 180 厘米以上的高处取一件要 8~15 秒,因为多了下蹲、伸手甚至登梯的动作。数字看着小,乘以每天几千个拣选行,差距就吓人了。
下面这张表是我给客户做上架规则时最常用的版本,拿去就能用:
| SKU 类型 | 存放位置 | 高度 | 备注 | | 快动销、小件 | 离打包台最近的巷道,流利架或拣选面 | 60~160 厘米 | 优先保证补货不断档 | | 快动销、重件 | 同样靠近打包台,但放在腰部高度或地面层 | 40~80 厘米 | 重货不许上高层,安全优先 | | 中动销 | 次近巷道,常规货架中层 | 60~160 厘米 | 按周复核流速变化 | | 慢动销、轻件 | 远端巷道或高层货架 | 160 厘米以上 | 省出黄金位置给快动销 | | 慢动销、重件 | 远端地面层或低层 | 地面到 80 厘米 | 别为了省空间把重货吊高 |
这里有个反常识的判断:库位利用率越高不一定越好。一个仓库如果每个库位都塞得满满当当,看起来空间利用率漂亮,实际上拣选员要花大量时间在巷道里绕路、等叉车让道。留出 10%~15% 的弹性空位,让快动销 SKU 有地方就近补货、让巷道保持通畅,整体拣选速度反而更快。空间利用率是财务指标,拣选速度是运营指标,两个指标打架的时候,听运营的。
上架分步做法:收货那一刻就定好库位
上架规则不能只写在文档里,必须变成 WMS 里收货时就能执行的动作。我在项目里落地的流程分五步,每一步都有明确的负责人和检查点。
第一步,收货前先拿到 SKU 的流速档位。WMS 里每个 SKU 都要有流速标签:快、中、慢。新品没有历史数据,先按同类产品的流速暂定一个档位,写上“新品暂定”标记,30 天后用真实拣选数据复核一次。没有标签的 SKU,系统不许放行放货任务。
第二步,系统按规则推荐库位,不是人凭感觉选。推荐逻辑按顺序判断:先看流速档位定区域,再看体积重量定高度,再看同订单搭配关系定邻居。经常一起出库的两个 SKU,放在相邻巷道能省下不少折返路。这个坑我见过三次:两个搭配销售的 SKU 一个在东头一个在西头,拣选员每天多跑几公里,客户还以为是人手不够。
第三步,执行放货时扫码确认库位。叉车司机到了推荐库位,先扫库位码再放货,系统校验 SKU 和库位是否匹配,不匹配就报警。这一道校验看着多余,实际上拦住了大量“放错位置但账面正确”的隐患。放错位置的货,系统里显示有库存,拣选员到了库位却找不到,盘点时才发现,损失的时间比扫码多得多。
第四步,放货完成后做抽查。每天随机抽 10 个放货任务,核对实物、库位、系统记录三者是否一致。抽查不是为了抓人,是为了早发现规则漏洞:如果某个区域反复放错,说明规则本身有问题,可能是库位标识不清,也可能是推荐逻辑和现场动线冲突。
第五步,每季度做一次重新排位。SKU 的流速会变,季节品、促销品、新品都会打乱原来的分级。行业里常见的复核节奏是每季度一次,SKU 结构变化超过两成时提前做一次。重新排位不用全仓大动,先动差距最大的那批 SKU:当前库位离目标区域最远、拣选量又高的,先搬。
讲一个项目故事。假设算例:2024 年 3 月,广东一家做家居用品的 3PL 仓库,面积约 8000 平方米,SKU 约 6000 个。上线前他们的爆款 SKU 散在 9 条巷道里,一张 5 行的订单平均要跑 4 条巷道。我们按上面的方法重新排位:把拣选量前两成的 SKU 集中到离打包台最近的两条巷道、黄金高度带,慢动销的挪到远端高层。假设算例测算:单张订单的平均行走距离从约 320 米降到约 190 米,拣选员每天少走约 4 公里。这个数字是按该仓当时的订单结构做的假设算例,不是实测承诺,但方向是对的:省下来的路,都变成了每天多处理几十张订单的能力。
还有一个反面例子。假设算例:2025 年 6 月,华东一家电商仓为了赶大促,把新到的一批爆款直接放在了离收货口最近的空位上,图的是放货快。结果那批货离打包台最远,大促三天拣选员每天多走约 2 公里,订单积压到半夜。大促结束后再搬回去,又花了一个周末的人力。上架时省下的 10 分钟,拣选时用三天还,还搭上一个周末。这个坑我见过三次,每次的理由都一样:先放下再说。
常见翻车点:上线前夜检查清单
收尾列一张检查清单,上线前夜逐项打勾,没打勾的不许上线。
一是流速数据用的时间窗口太短。只看最近一个月的拣选数据,会把季节性高峰当成常态,或者把淡季的慢动销误判成死货。建议至少用 3 个月的数据,有季节性的品类用 6~12 个月,分季节看。
二是只看拣选次数,不看体积和重量。一个小件高频 SKU 和一个大件高频 SKU,库位需求完全不同。大件快动销要的是地面附近的大库位,不是黄金高度带的小格口。规则里必须同时有流速、体积、重量三个维度。
三是新品没有默认档位。新品一到,系统没有流速标签,操作员只能随手放。三个月后新品成了爆款,却住在最远的角落。给每个新品一个暂定档位和 30 天复核闹钟,是成本最低的补救。
四是重新排位只搬货不改规则。搬完一次,三个月后流速又变了,货又散了。重新排位必须和规则复核绑在一起:搬货的同时,检查推荐逻辑、流速标签、库位标识有没有过时。
五是把放货当成收货员一个人的事。上架规则需要运营、系统、现场三方一起定:运营给流速标准,系统给推荐逻辑,现场反馈动线是否合理。任何一方缺席,规则落地三个月内一定走样。
放货这件事没有捷径:收货那一刻多花 30 秒按规则放好,拣选时每天能省下几小时。先把流速算清楚,再把规则写进系统,坚持每季度复核一次。做到了这三点,三个月后的拣选速度不会让你失望。
作者:林晓|WMS 实施顾问,做过 30+ 上线项目