仓库 AI 边缘计算 vs 云端,这个选择题最近三年几乎出现在每一次仓库智能化立项会上。一边是把算力搬到仓库现场的边缘计算,一边是把推理交给云端。两边都有人讲得头头是道,也都有人踩过坑。问题不在于谁更先进,而在于仓库 AI 推理这个具体任务,对延迟、成本和断网容忍度到底是什么要求。把这三个要求拆开算,答案往往和第一印象不一样。
现象:同一个仓库,两种部署跑出了两种结果
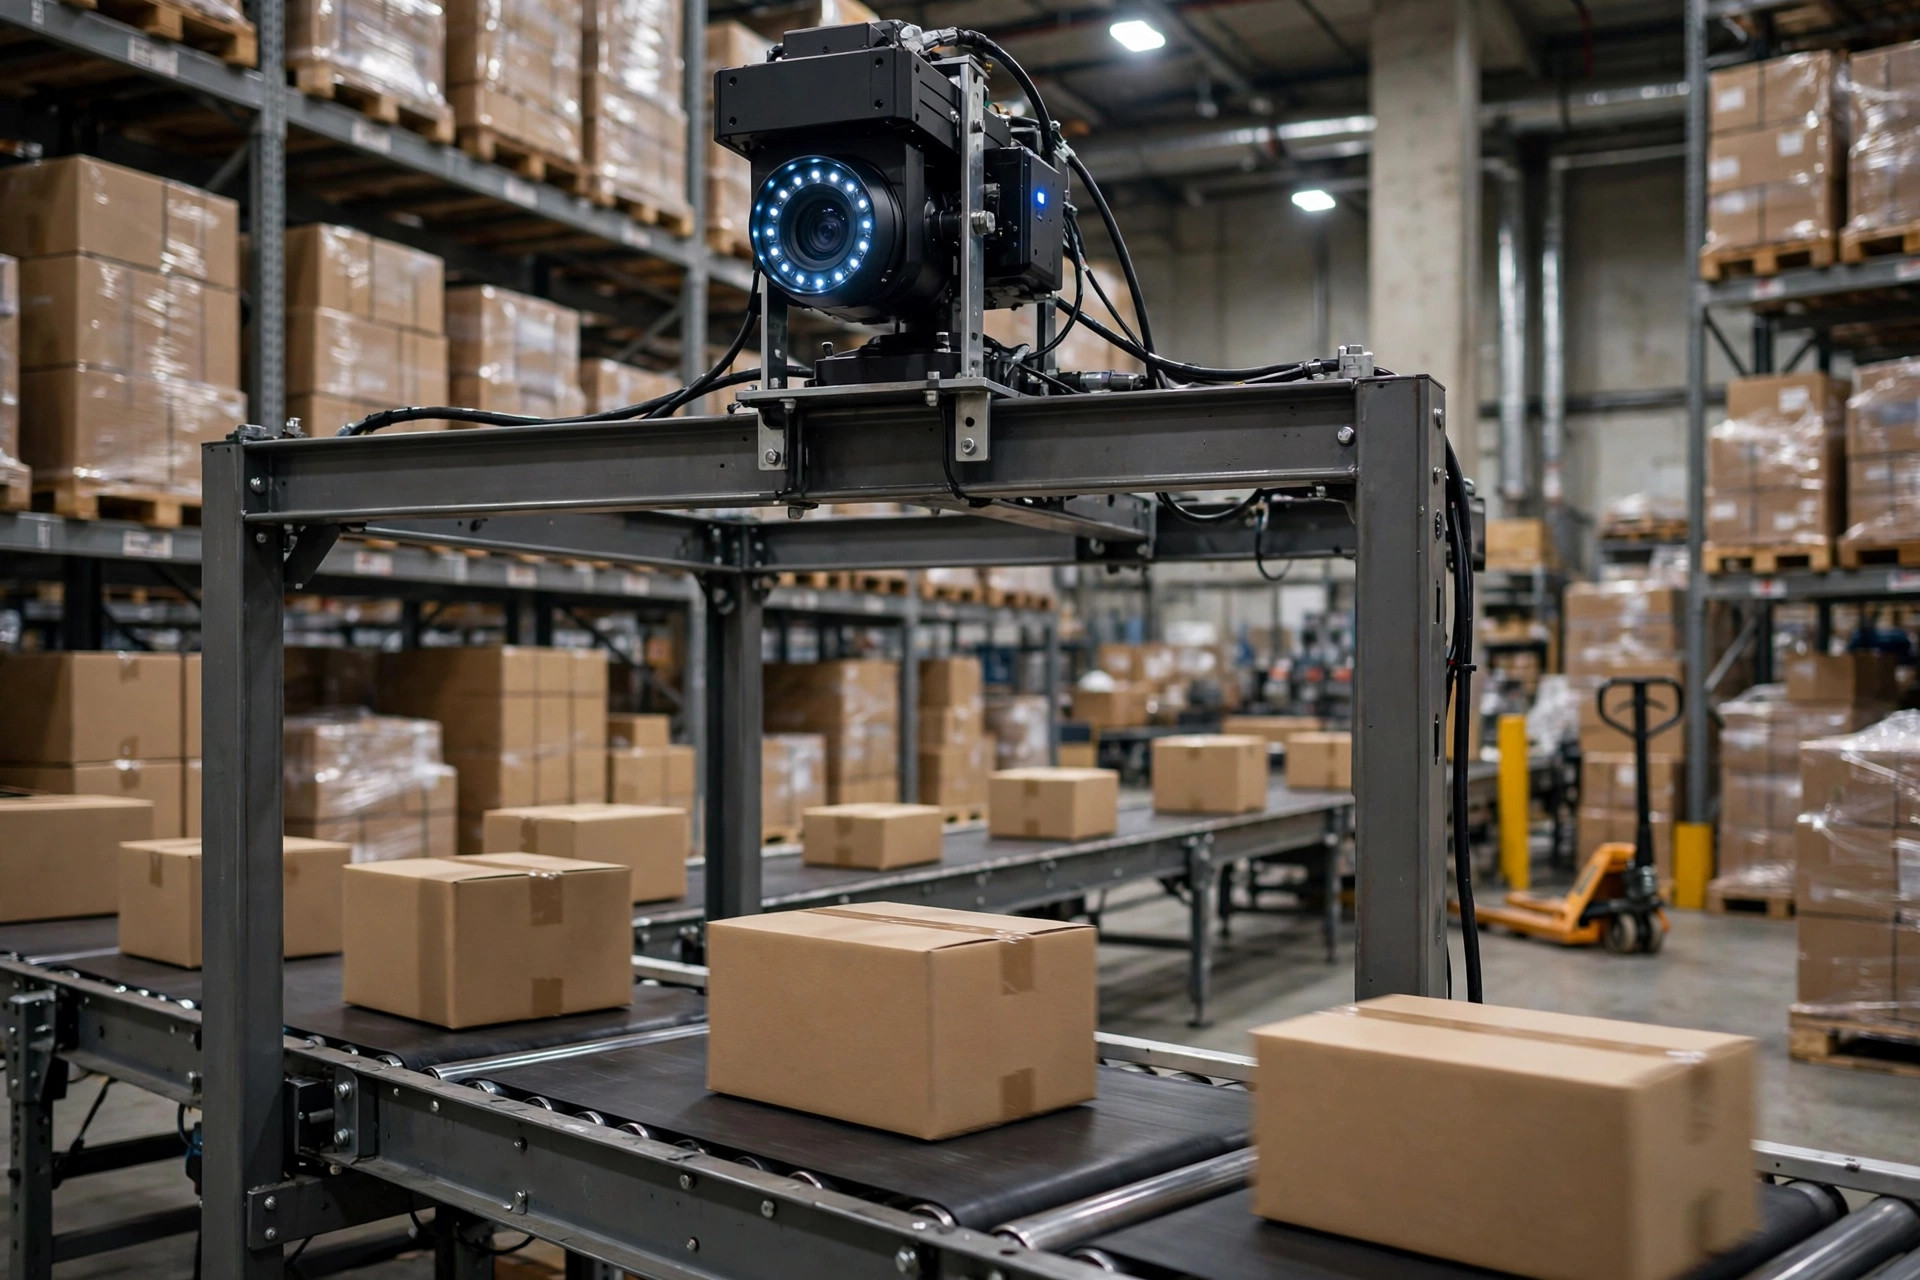
先看一个真实场景。2024 年,华东一家做 3C 产品代发的 3PL 仓库上了视觉检测,用摄像头拍包裹面单,AI 识别面单信息并比对系统订单,错单直接拦截。这套系统一开始跑在云端:摄像头拍完照,图片传到云端推理,结果再传回来。白天单量平稳时一切正常,到了晚上大促,单量翻了几倍,问题集中爆发——面单识别结果回来的时间从不到一秒拉长到几秒,输送线上的包裹等不及结果,只能先放行,拦截率明显下滑。更糟的是有一次园区宽带抖动了十几分钟,整条检测线形同虚设,只能靠人工抽查顶着。
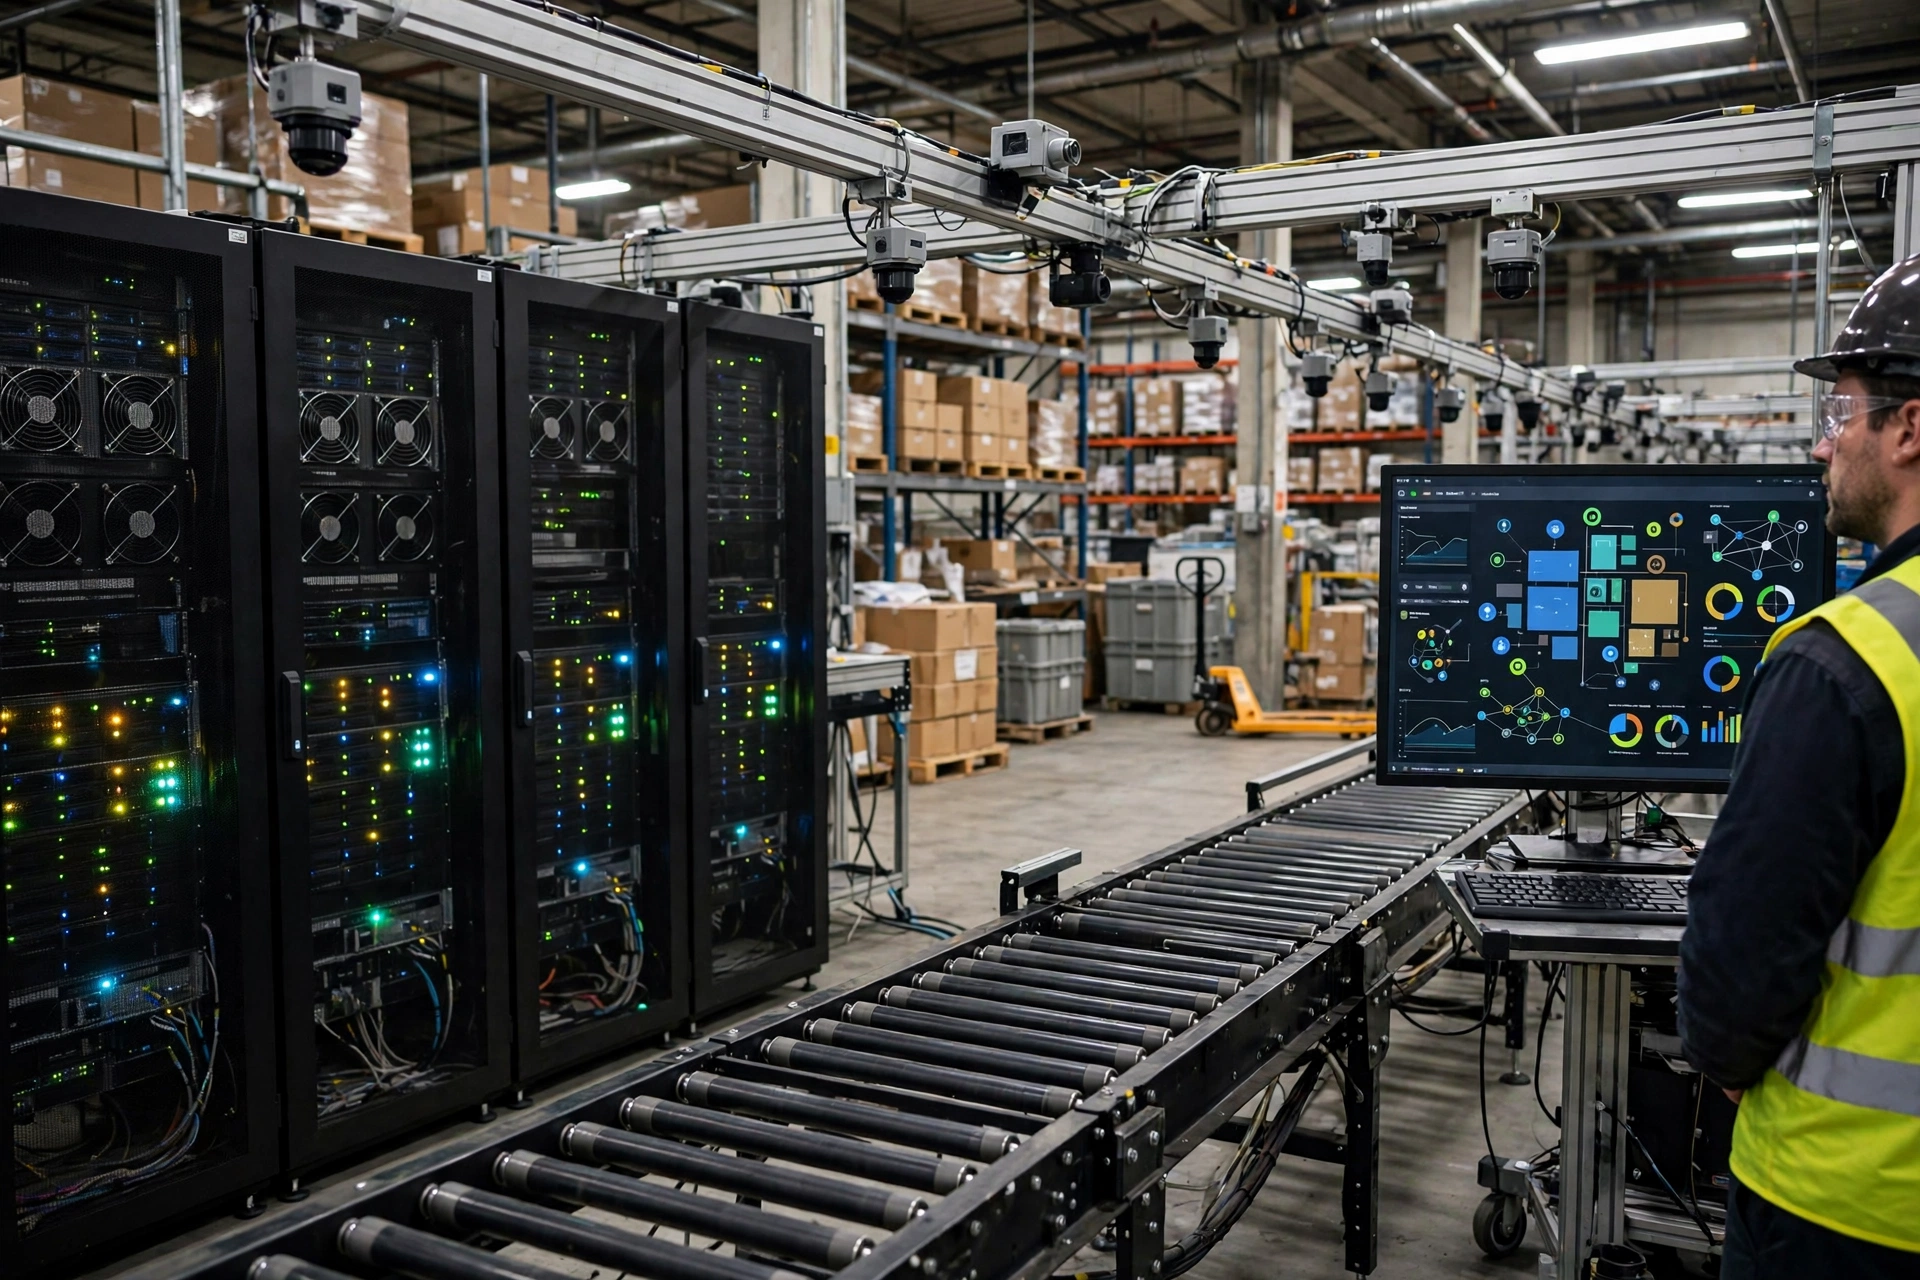
同一家仓后来把视觉检测的推理下沉到现场的边缘服务器上,摄像头拍完直接在本地算,识别结果就地返回,云端只负责模型更新和数据汇总。改造后检测环节的响应时间回到毫秒量级,断网也不影响检测本身。这个案例说明一个基本事实:仓库 AI 推理放边缘还是放云端,首先取决于任务对延迟的容忍度。视觉检测、分拣复核、异常报警这类环节,推理慢半拍就等于没做,天然适合边缘;而需求预测、补货策略、月度经营分析这类任务,晚几分钟出结果毫无影响,放云端反而更划算。
第二个场景来自一家做服装仓配的企业。他们在 2023 年上了基于云端大模型的客服问答和订单异常分析,效果不错,第二年又想把拣选路径优化也搬上云。问题出在数据量上:拣选优化需要实时读取库位、库存和订单三类数据,数据量不大,但调用频繁,云端按调用次数计费后,每月账单里推理调用费这一项悄悄超过了当初的预算。复盘时才发现,调用频次高的任务放在云端,账单的增长曲线比一次性买硬件陡得多。这不是云端不好,而是计费方式和任务特征没对上。
边缘计算 vs 云端:三笔账要分开算
把延迟、成本、断网容灾三笔账分开算,对比才有意义。
| 维度 | 边缘计算 | 云端推理 |
|---|---|---|
| 推理延迟 | 本地计算,通常在毫秒量级,几乎不受网络影响 | 依赖网络往返,平稳时几百毫秒,拥堵时可能到秒级 |
| 断网影响 | 断网后本地推理照常运行,只丢模型更新和汇总 | 断网即停摆,依赖网络的环节全部中断 |
| 前期投入 | 需采购边缘服务器和加速卡,一次性投入较高 | 几乎零硬件投入,按量付费起步门槛低 |
| 长期成本 | 固定成本为主,用量越大摊薄越明显 | 随调用量线性增长,高频调用下总账可能反超 |
| 维护难度 | 需现场有人懂硬件,模型升级要逐点下发 | 厂商统一运维,模型升级一次推送全量生效 |
| 扩展弹性 | 扩容要加机器,周期以周计 | 扩容按需拉取,周期以分钟计 |
成本这笔账最容易算错。很多人只比较"买一台边缘服务器多少钱"和"云端一个月多少钱",这是拿一次性投入比月度账单,口径就不对。正确的做法是按三年的总拥有成本算:边缘方案是硬件采购加电费加现场维护人力,云端方案是调用费加数据传输费加可能的专线费。以一个中等规模仓库为例,如果视觉检测每天要跑几十万次推理,三年下来云端调用费累计起来很可能超过边缘硬件的一次性投入;反过来,如果每天只跑几千次,边缘硬件的利用率上不去,云端按量付费反而便宜。分界线不在技术,在调用量。
断网这笔账则经常被低估。仓库的网络环境和办公室不一样,园区宽带、内部无线、运营商线路,任何一环出问题都会影响云端推理。关键问题是:断网时哪些环节必须继续跑?分拣复核、面单检测、出库拦截这类环节停十分钟,错误包裹可能已经发出去了,事后追回的成本远高于事前防范。这类环节放在边缘,相当于给关键链路买了一份保险。而报表、预测、分析类任务断网几小时也没什么实质损失,完全可以留在云端。
这里有一个反常识的判断:边缘计算的最大价值往往不是"更快",而是"更稳"。很多人以为上边缘是为了省那几百毫秒,其实对多数仓库场景来说,几百毫秒的延迟差异用户根本感知不到;真正让仓库半夜被叫醒的,是网络抖动导致整条 AI 链路停摆。边缘的价值首先体现在断网不断工,其次才是延迟。反过来,云端的最大价值也不是"更便宜",而是"更省心"——模型迭代、算力弹性、运维外包,这些隐性成本在账面上看不见,却在三年里一点点吃掉预算。
场景分流:哪些放边缘,哪些放云端
综合延迟、成本和断网三笔账,仓库 AI 边缘计算 vs 云端这道题,落到具体场景上就有了清晰的分流框架:
- 放边缘:视觉检测、面单识别、分拣复核、异常报警、设备状态监测。这类任务的共同点是高频、实时、断网不能停。
- 放云端:需求预测、补货策略、库存健康度分析、月度经营报表。这类任务低频、可以等、数据量大、模型更新快。
- 混合部署:拣选路径优化、波次规划、人员排班。这类任务可以白天在边缘跑轻量版本保证实时性,夜间在云端跑重算版本做全局优化,两边各取所长。
混合部署听起来美好,但要警惕一个坑:两套模型版本不一致。边缘跑的是三个月前下发的轻量模型,云端跑的是上周更新的大模型,同一个任务两边给出的结论可能打架。解决办法是建立统一的模型版本管理,边缘模型的更新节奏和云端保持同步,并且明确规定冲突时以哪一边为准。这个管理成本必须在立项时就计入,否则混合部署省下的钱,会在后期的扯皮里加倍还回去。
还有一个容易被忽略的维度:维护能力。边缘服务器放在仓库现场,灰尘、温度、电压波动都是真实存在的问题,硬件故障需要有人到场处理。如果仓库本身没有懂硬件的人,边缘方案的隐性维护成本会很高。相反,云端方案把运维外包给了厂商,仓库只需要管好网络和账号。对中小仓库来说,这一点往往比技术指标更能决定成败。
写在最后:先问任务,再选位置
仓库 AI 推理放仓库 AI 边缘计算 vs 云端,没有标准答案,只有一条判断链:先看任务对延迟和断网的容忍度,再看调用量决定的成本曲线,最后看自己有没有维护边缘硬件的能力。三条都想清楚了,部署位置自然就定了。
值得注意的趋势是,边缘硬件的成本在下降,云端大模型的推理成本也在下降,两边的分界线每年都在移动。今天适合放云端的任务,明年可能适合放边缘;今天必须放边缘的任务,明年云端专线加本地缓存也许就能兜住。所以这个选择不是一锤子买卖,而是每年复盘一次的动态决策。仓库管理者真正需要建立的,不是一次选对的能力,而是每年重新算一遍三笔账的习惯。具体数字以各厂商官网最新政策为准,立项前务必按自家调用量重新测算。
作者:陈博士|供应链行业研究员