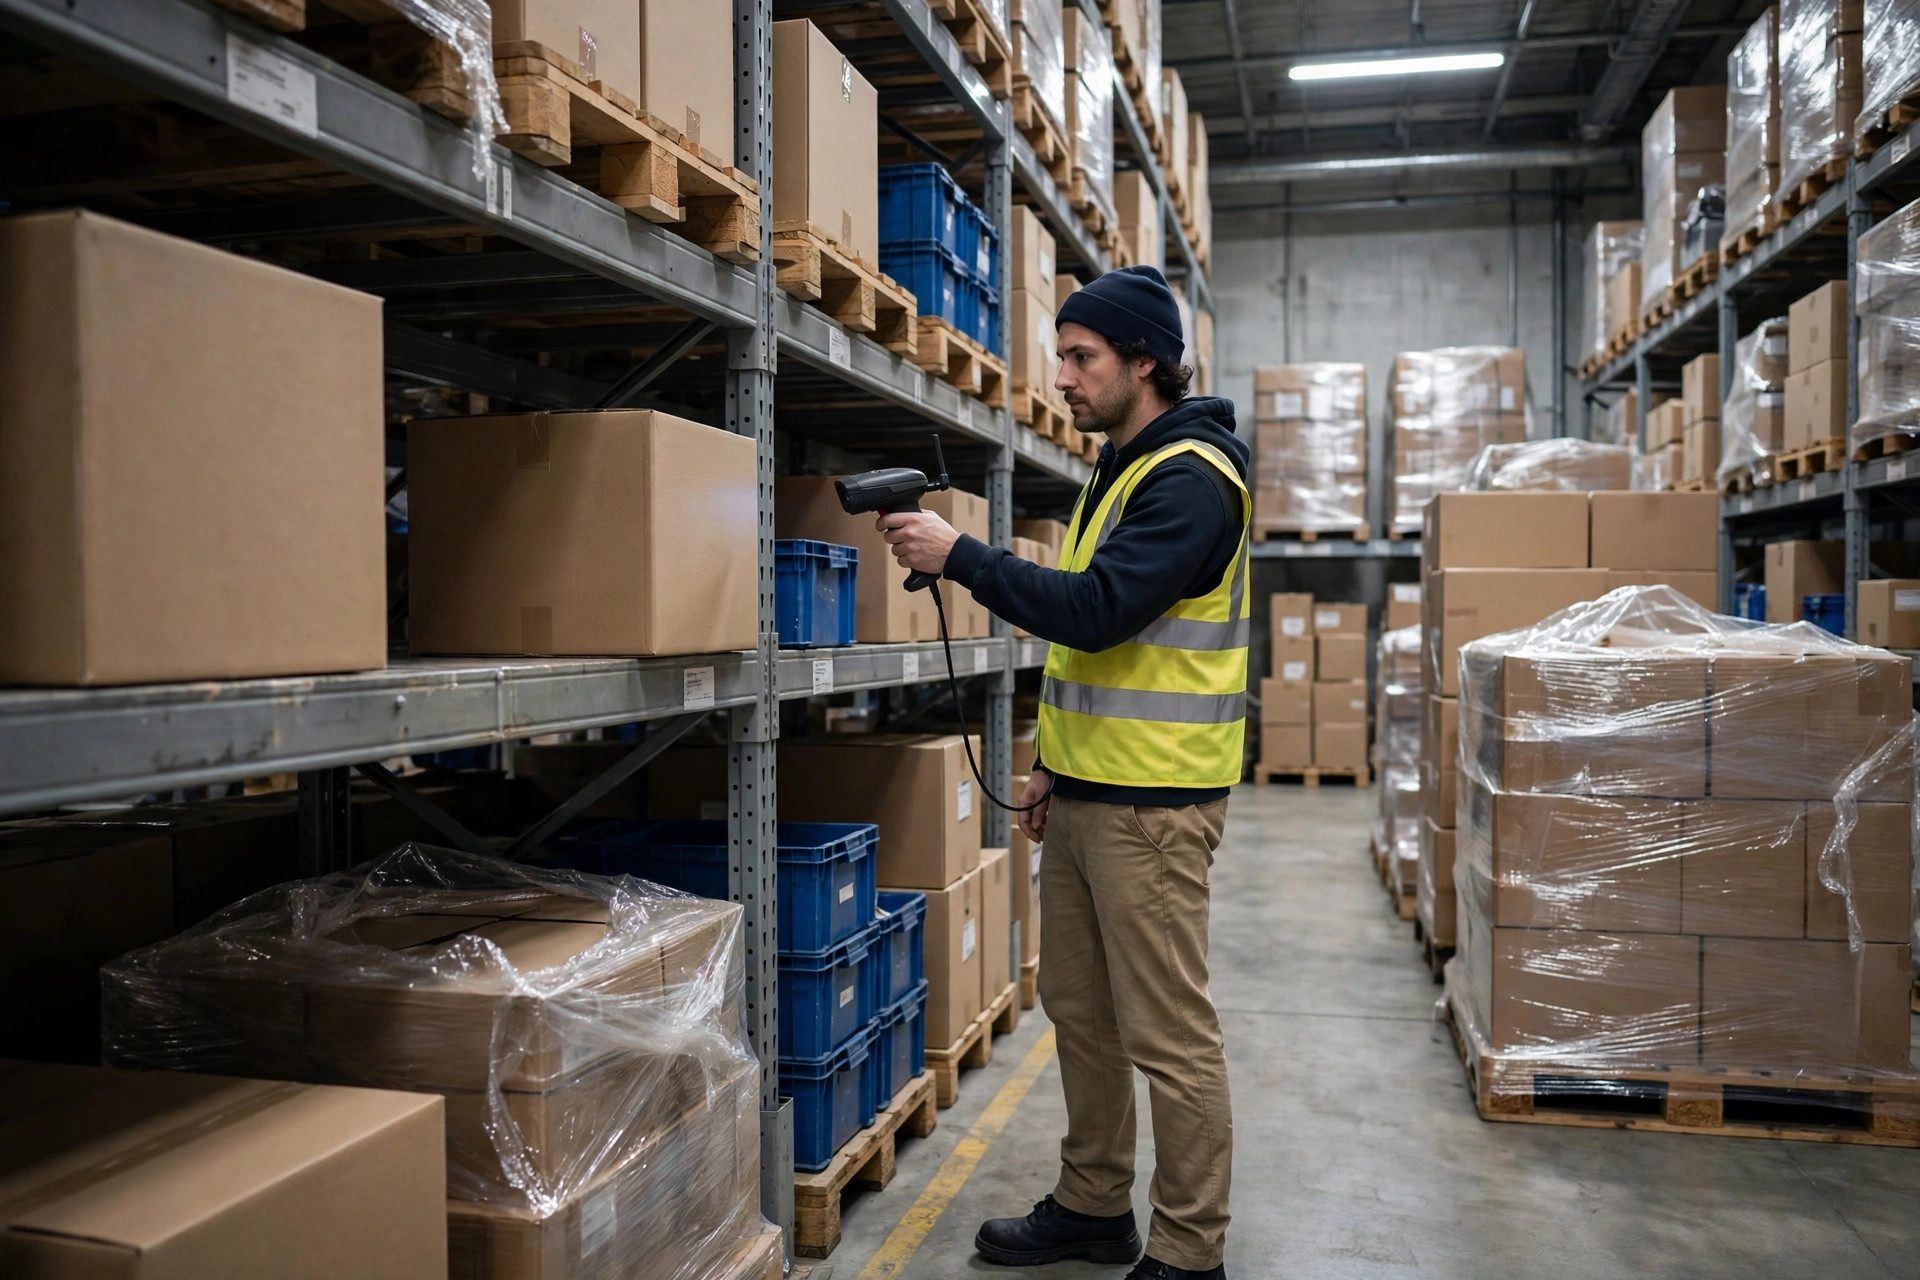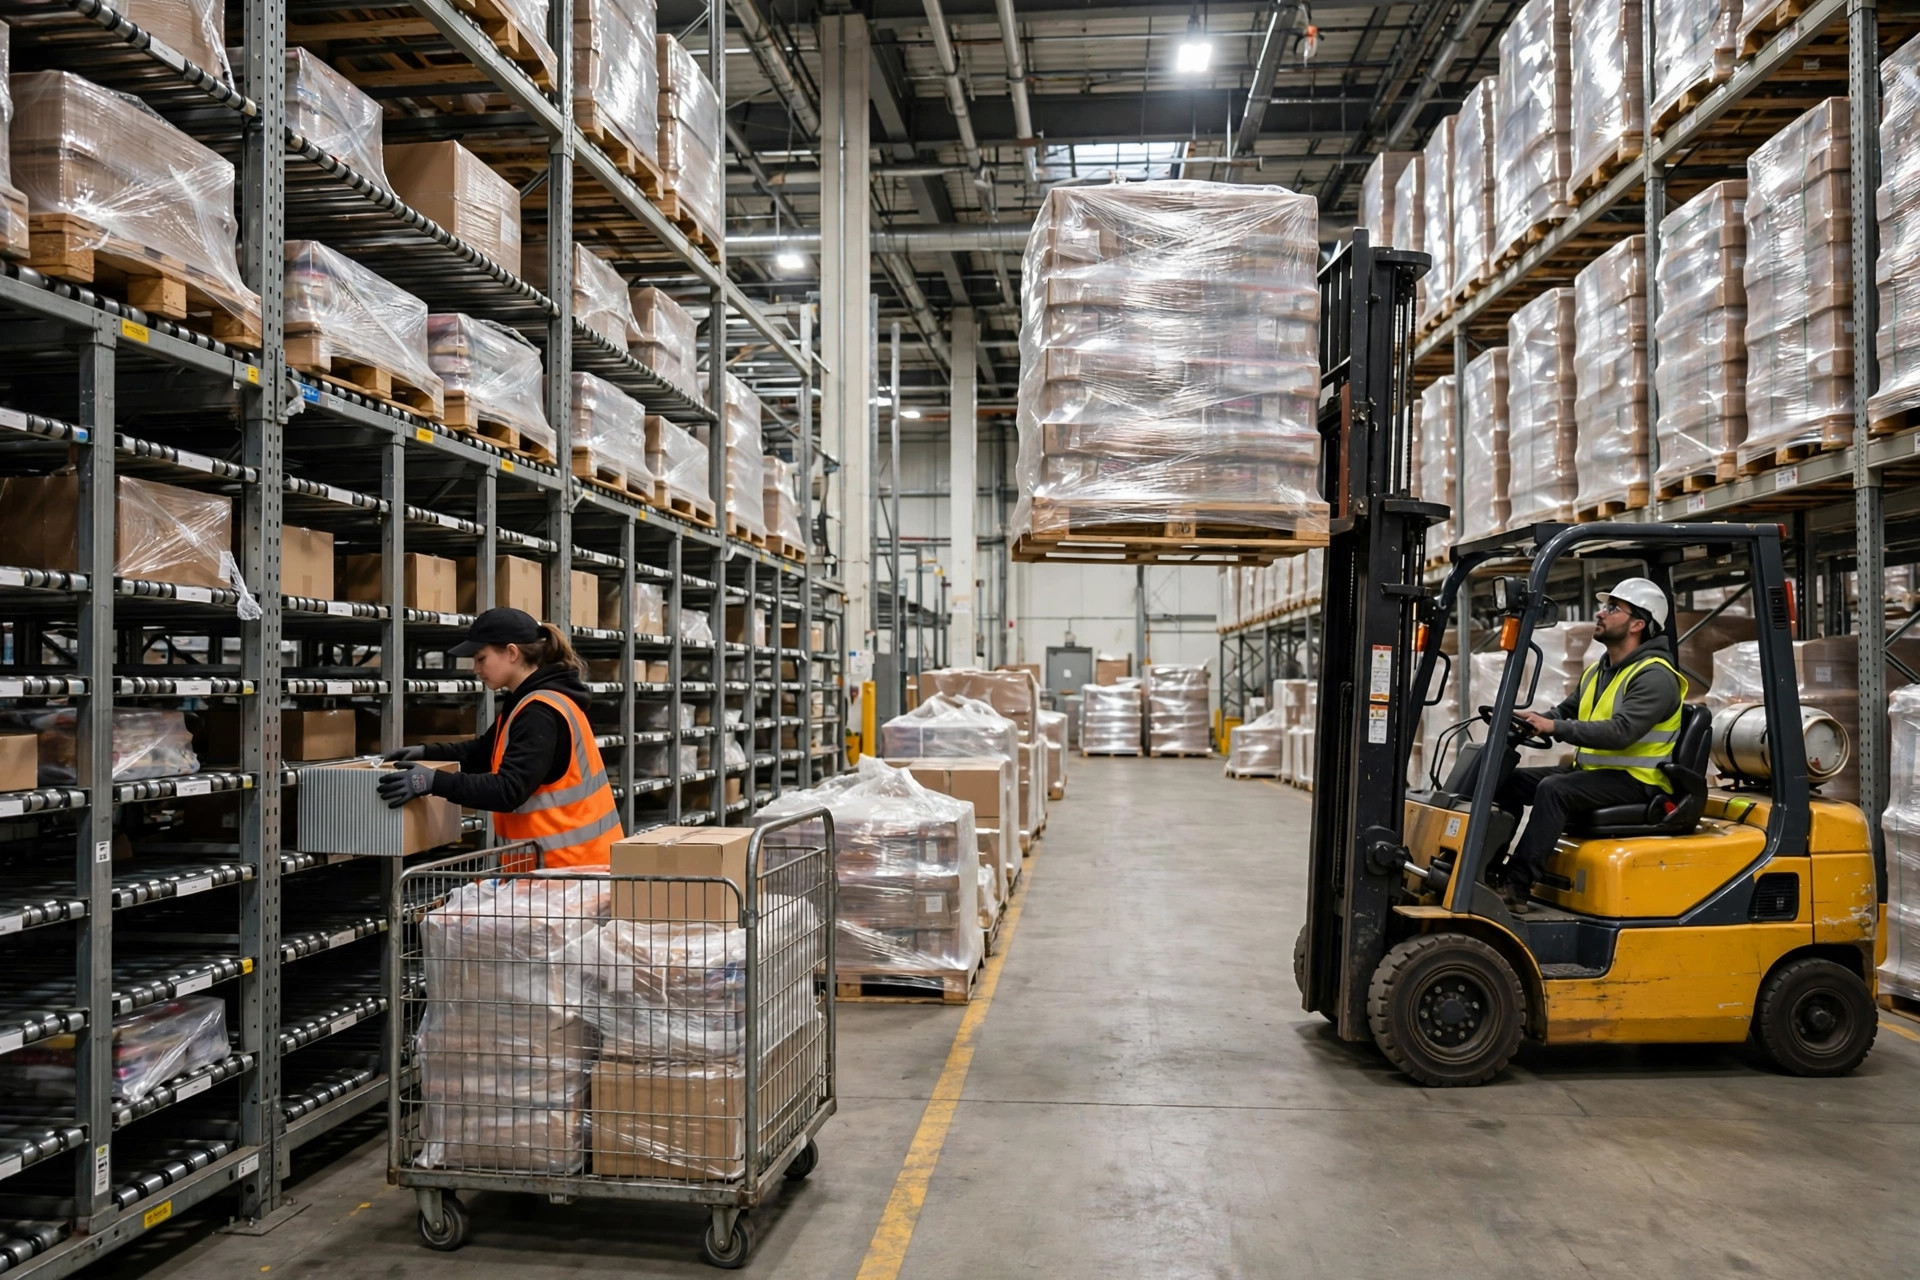
先说结论:三级拣选的订单分流,一句话就能讲完——订单行按"整托 / 整箱 / 拆零"三种拣选单位,拆成三类任务分别下发到三个拣选区。规则不写在纸上,写在 WMS 的 release 逻辑里:每个 SKU 有且只有一个主拣选位,订单行一生成,系统立刻知道这行货从哪个区出。分流做对了,拣选员不串区;做错了,旺季就是一场灾难。
订单不分流,拆零区第一个死
2023 年底,广东一家做小家电出口的 3PL 仓,SKU 八千多,旺季日均 6000 单。客户老板坚持"所有拣选位放一起,拣选员推车顺路一次捡完",上线前我拦了三次没拦住。开仓第一个月,拆零位被整箱订单淹没:一个拆零拣选员每天要开箱 200 多次,实测开一次箱平均多花 25 秒(该项目实测值,仅供参考),200 次就是 83 分钟,人均 UPH 直接掉 30%(项目实测对比值)。
救回来的办法就是分流。花两周重做拣选位布局:整托订单从托盘位直出,整箱单进整箱拣选区,拆零区只留真正的拆零行。改完第一个完整周,拆零区 UPH 回到基线,复核差错率降了一半。这个坑我见过三次,三个仓同一个剧本:都是"图省事不分流",都是旺季第一个月爆。
2024 年 5 月,苏州一家母婴电商仓(日均 4000 单,SKU 3000),上线时就做了三级分流。分流区和老区(未分流)同期实测对比如下(项目实测值,仅供参考):
| 指标 | 未分流老区 | 三级分流区 | | 拆零区人均 UPH | 85 行/小时 | 132 行/小时 | | 拣选员日均行走 | 9.2 公里 | 6.1 公里 | | 整箱订单平均拣选耗时 | 4.5 分钟/单 | 1.8 分钟/单 |
数字摆在这,老板们一般就不再争论"要不要分"了。
三级拣选的订单分流,先定这张决策表
分流规则的第一步不是配系统,是看数据。把过去三个月(至少覆盖一个波峰)的订单行导出来,按单行数量折成托 / 箱 / 件,画一张分布。阈值没有标准答案,但分流逻辑是固定的:
- 单行数量 ≥ 1 整托 → 进整托区,叉车整托直取,托盘位即拣选位;
- X 箱 ≤ 单行数量 < 1 整托 → 进整箱区,整箱拣选不开箱(X 一般取 4~6 箱,示例值,按你们的开箱成本自己测);
- 单行数量 < X 箱 → 进拆零区。
第二步是把 ABC 分析和拣选单位交叉看。A 类 SKU 里,整托和整箱订单占比通常超过 70%(示例项目统计值),这类 SKU 的拆零拣选位基本是摆设;C 类 SKU 九成以上是拆零行,硬给它们配整箱位等于浪费货架。三级分流规则决策表长这样:
| SKU 类型 × 订单特征 | 分流去向 | | A 类,整托单占比高 | 整托区为主,整箱区为辅,不设拆零位 | | B 类,整箱单为主 | 整箱区为主,拆零位只做尾数 | | C 类,长尾拆零 | 拆零区,整箱整托位一律不给 | | 新品 / 促销 SKU | 先进拆零区,跑满一个月数据再定级 |
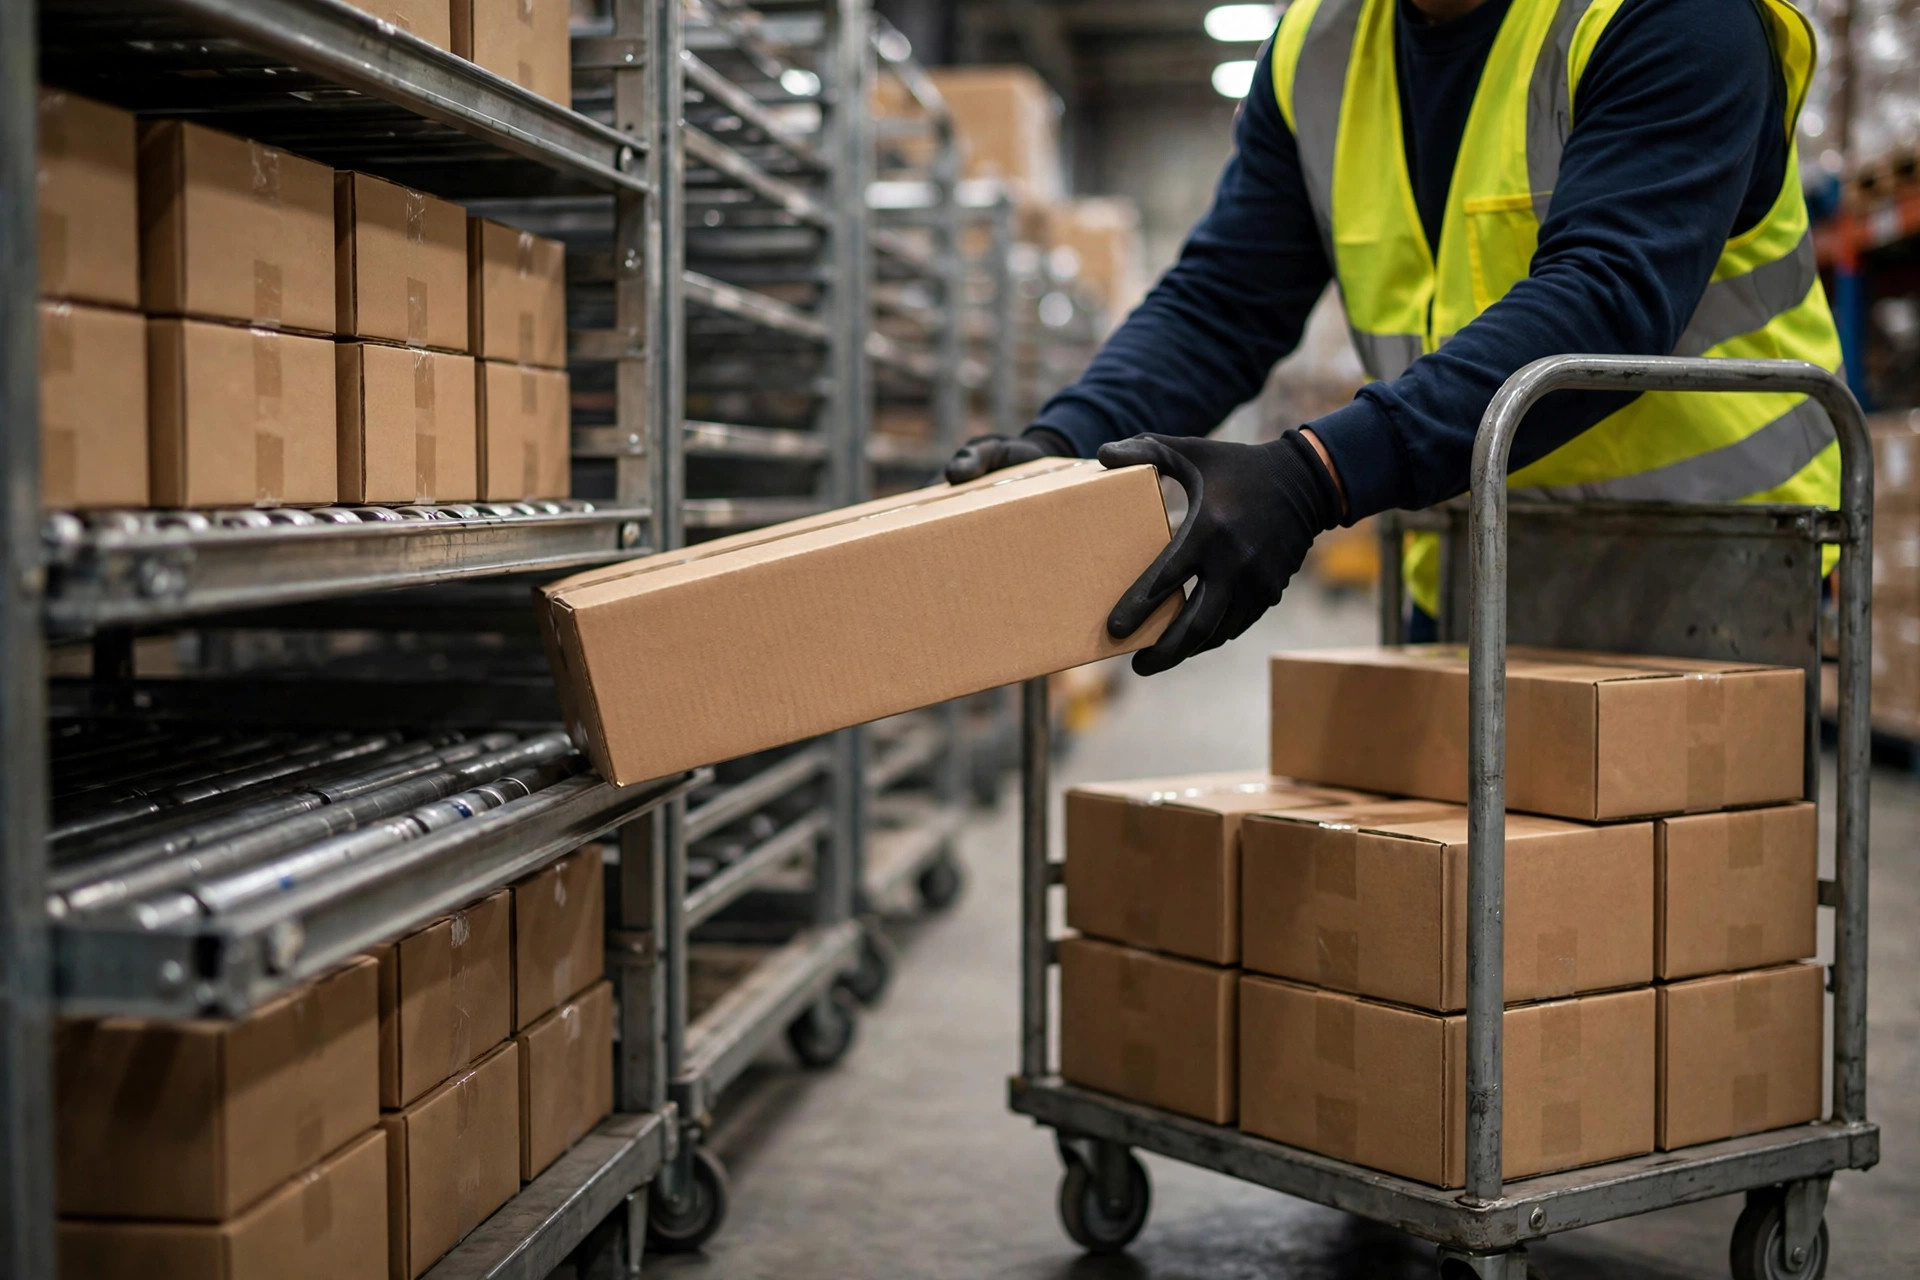
注意最后一行:新品和促销品不许直接进整托 / 整箱层。我见过太多仓把大促 SKU 一股脑塞进整箱区,大促一结束整箱区空一半,补货员天天在里面挪空箱。
四步把分流规则配进 WMS
步骤 1:item master 加三个字段——主拣选层级(P / C / E)、整箱分流阈值(case_break_threshold,按 SKU 可单独设)、降级开关(allow_downgrade,缺货时允不允许自动降一级)。
步骤 2:release 逻辑按"单位"拆行。同一订单行如果跨单位(比如订了 1 托零 3 箱),WMS 必须能把一行拆成"1 托走整托区 + 3 箱走整箱区"两条任务行。拆不了行的 WMS,别谈三级分流——这是选型时就要问死的问题。
步骤 3:每个 SKU 只许一个主拣选位。整箱区的拣选位和拆零区的拣选位是两个物理位,但系统里主拣选位只能挂一个,另一个挂"溢出位",主位缺货才走溢出。两个都挂"主",release 就不知道听谁的。
步骤 4:补货规则和分流规则一起配。拆零区按"半日用量 + 安全量"做前置补货,整箱区按整托位做整托补货。分流不配补货,等于只修了一半——三级分流真正的收益不是拣得快,是把"拣选"和"补货"解耦,拆零区断流才是旺季真正的杀手。
上线前夜 checklist,直接抄走:
- 抽 100 个 SKU,逐个核对主拣选位和物理位一致;
- 拿 50 张历史订单跑 release,分流结果和人工判断逐单比对,一致率低于 95% 不许上线;
- 拆零区每个拣选位备足次日上午的量;
- 降级逻辑实测一遍:整托位没货,订单能不能自动降到整箱区;
- 把分流规则表打印贴墙上——系统挂了,人工也能照表执行。
这个坑我见过三次:三级拣选最常见的三个翻车点
翻车点一:一个 SKU 两个主拣选位。客户图方便,同一 SKU 在整箱区和拆零区各建了一个"主"拣选位,release 逻辑写死二选一,结果一半订单永远没人拣,堆在异常池里发霉。记住:主拣选位有且只有一个。
翻车点二:补货没跟上分流。拆零区只备了半天量,旺季下午两点断流,全仓拣选员站着等补货叉车。分流配了、补货没配,等于白干。
翻车点三:大促之后规则没复核。订单结构变了(整箱单从 20% 涨到 45%,示例项目值),分流阈值还是老的,整箱区爆仓、拆零区闲得发慌。我的规矩:大促后第一周必须重跑订单结构分析,阈值按季度复核一次。
最后说一个反常识的判断:很多人觉得 SKU 越少越该进拆零,错。真正该进拆零的是"订单行数多、单行量小"的 SKU;三级里最尴尬的是整箱层——订单结构一波动,它要么被淹没要么空转。所以我的建议是:整托和拆零是必选项,整箱层是可选项,日均整箱单少于 300 行(示例阈值)的仓,整箱层直接砍掉,复杂度立减一半。
今晚就能动手的事:把过去三个月订单行导出来,按整托 / 整箱 / 拆零三类画个分布。如果某一类占比不到 10%,那一级大概率是摆设,砍掉它。分流规则不怕简单,怕的是假装精细。
作者:林晓|WMS实施顾问,做过30+上线项目