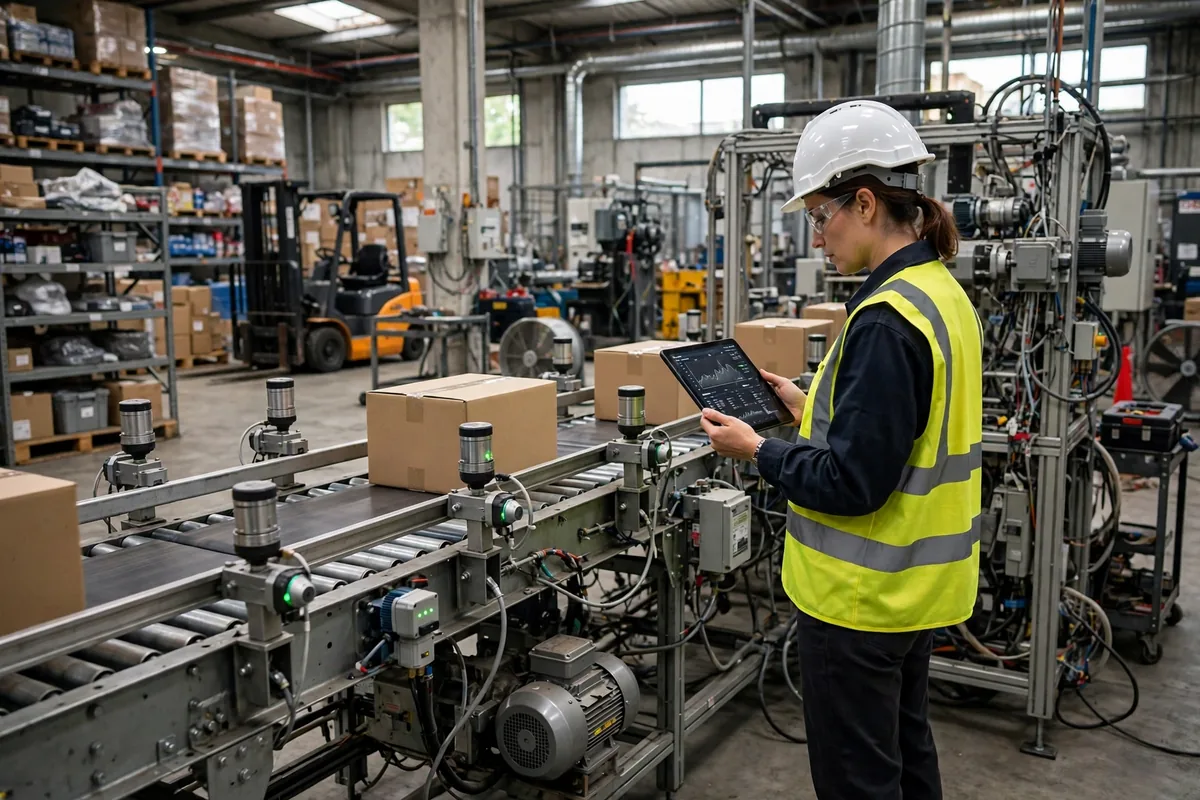
AI 预测性维护在仓库设备上的讨论,近两年明显从“能不能做”转向了“值不值得做”,而这个转向本身就值得先看清:很多仓库不是缺传感器,也不是缺算法,缺的是对报警的信任。2024年9月,华东一家电商仓的设备主管向我描述过这样一个场面,输送线电机上装了振动传感器,系统三个月报了上百次预警,维修班一开始每次都去查,后来查十次有九次没事,索性不再理会,直到一台分拣机驱动轴承抱死,整条线停了大半天。这个案例的教训不在算法,而在信任的损耗速度远快于模型的进步速度,报警一旦失去可信度,系统就等于不存在。
AI 预测性维护先看现象:报警多了,人反而不信了
根据公开的行业现场记录,一些只靠传感器建模的项目在最初一个季度里误报率可达三到四成,维修团队在半年内就对报警失去响应,这类数字提醒我们,预测性维护的第一个瓶颈往往不是预测精度,而是组织层面的接受度。AI 预测性维护的常见宣传只讲检出率,很少讲误报成本:一次误报是一次无效停机检查、一次备件误领、一次对系统的不信任积累,多次误报叠加之后,真正有价值的报警也会被当成噪音略过。2025年2月,华北一家第三方物流仓也出现过类似情形,立库堆垛机电机温度传感器频繁越限,系统连报两周,现场查下来多是环境温度波动与负载变化所致,维修班把报警阈值调高之后才安静下来,可调高阈值的那一周,恰好漏掉了一台电机轴承温度缓慢爬升的早期信号。
这个现象背后的逻辑链条是完整的:传感器只记录物理量,物理量的波动既可能来自设备劣化,也可能来自工况变化,而模型如果分不清这两类波动,就会把工况变化当成故障前兆;维修人员分不清模型为什么报警,就会把模型当成不可靠的黑箱;黑箱一旦多次出错,就会被绕过。由此可见,预测性维护落地的第一步不是追求更高的检出率,而是在误报与漏报之间找到一个组织能够长期接受的平衡点,并把每一次报警的处置结果回填给模型,让模型在真实反馈中慢慢变准。
AI 预测性维护的数据账:振动、温度与电流各自能说什么
振动、温度与电流是仓库设备上最常用的三路信号,它们的价值并不相同,适用的设备也不相同。振动信号最灵敏,轴承磨损、不平衡与不对中都会在振动频谱上留下特征,而且往往比人耳能听到的异响早数周出现,适合旋转设备与高速输送部件;温度信号最直观,轴承缺油、电机过载与散热不良都会先表现为温升,适合电机、减速机与电气柜,但温度变化滞后,单独使用容易错过早期信号;电流信号最省事,电机电流特征分析不需要在设备上加装传感器,通过电流波形的异常就能发现电机负载与转子方面的问题,适合已经布好电表、又不便停机加装传感器的老旧设备。
| 信号 | 擅长发现的问题 | 主要局限 | 适用对象 | | 振动 | 轴承磨损、不平衡、不对中 | 对安装位置与工况敏感,易受干扰 | 分拣机、输送机、堆垛机旋转部件 | | 温度 | 过载、缺油、散热不良 | 变化滞后,早期信号弱 | 电机、减速机、电气柜 | | 电流 | 负载异常、转子问题 | 特征提取门槛高,需结合工况 | 不便停机加装传感器的老旧电机 |
根据美国能源部相关指南的公开基准整理,预测性维护与单纯定期保养相比,总拥有成本可节约约百分之八到百分之十二,与事后维修相比可节约约百分之三十到百分之四十,两组数字的差距本身就说明了一个关键问题:预测性维护的收益高低,取决于原来用的是哪种保养方式,定期保养已经做得很好的仓库,改用预测性维护的边际收益本来就有限。德勤的相关估算也给出过类似的区间,运维成本下降约百分之五到百分之十,设备可用时间提升约百分之十到百分之二十,这些数字应当被理解为成熟项目的区间上限,而不是每个仓库一上线就能拿到的平均值。
算账用假设算例说话:一座中型仓库有200台关键旋转设备,假设算例按每台每年定期保养成本约2000元、非计划停机每小时损失约2万元估算,若预测性维护把非计划停机从每年10次降到6次,假设算例的收益就是每年约8万元的停机损失减少,再扣掉传感器、平台与人力投入,假设算例的净收益仍需按实际投入逐项核对,具体以实测数据为准。反常识的判断正在于此:设备越多、停机越贵,预测性维护越划算;设备不多、停机损失不大,定期保养加人工巡检可能更便宜,硬上AI反而是成本更高的选择。
AI 预测性维护的取舍:误报与漏报之间没有免费选项
误报与漏报是一对无法同时压到零的指标,阈值调得松,漏报少了,误报就多;阈值调得紧,误报少了,漏报就多。根据公开研究中的一个常被引用的结论,误报率达到约百分之十,就可能把预测性维护的预期经济收益全部抵消,这个数字是否适用于每一座仓库可以讨论,但它指出的方向是确定的:误报不是小毛病,而是直接吃掉收益的成本项。取舍的标准应当由故障后果决定:堆垛机、冷库压缩机这类一旦停机就影响全仓出货的设备,宁可多报几次,也不能漏掉一次;普通输送段、备用设备这类停机影响有限的设备,则可以把阈值放宽,先保住报警的可信度。
2024年6月,华南一家冷链仓的制冷压缩机项目提供了一个值得参考的做法:振动与温度双信号同时越限才触发高级别报警,单一信号越限只记为观察项,三个月里高级别报警共7次,其中5次查出真实隐患,2次为空报,维修班对系统的信任反而上升了。这个做法的实质,是用信号组合代替单一阈值,用分级处置代替非报即停,把误报的代价从一次无效停机降为一次例行观察。长句的逻辑到这里可以收束为一句判断:预测性维护的成熟度,不在于模型能报出多少故障,而在于组织能否承受它的误报,并把每一次误报变成下一次更准的输入。
AI 预测性维护的落地前提:从定期保养走向按需保养
从定期保养走向按需保养,真正的门槛不在算法,而在数据链路与维修流程是否已经准备好。根据公开的现场经验,有效的预测项目通常需要12到18个月的基线数据积累,算法才能达到可靠的准确度,这个时间成本在立项时就应当写进计划,而不是等到上线三个月没有效果时才发现。数据方面,振动、温度与电流是否连续采样、维修记录是否已经数字化、故障标签是否由维修结果回填而非凭印象填写,这三项有一项缺失,模型学到的就是带噪音的历史。流程方面,报警之后谁去确认、多长时间内必须反馈、确认结果如何写回系统、备件与停机窗口如何协调,这些环节没有事先定好,报警就只会停留在屏幕上。
落地顺序因此应当是分阶段的:先把数据链路与维修记录数字化做扎实,再在高故障后果的少数关键设备上试点,用分级报警与人工复核积累标签,等到误报率与处置闭环都稳定下来,再把范围扩大到全仓设备。这个顺序看起来慢,却是目前公开案例中成功率较高的路径。反过来看,跳过数据准备直接采购平台、跳过试点直接全仓铺开、跳过人工复核直接让模型派单的项目,往往在半年内就陷入报警疲劳,投入不少,信任先垮了。
趋势判断到这里仍需保持克制:AI 预测性维护在仓库设备上的应用会继续扩大,但扩大的方式更可能是先在高价值、高停机损失的设备上站稳,再向一般设备缓慢渗透,而不是一次性的全仓替代。未来两到三年,真正决定各家仓库差距的,可能不是谁先买了模型,而是谁先把数据质量、标签回填与报警处置闭环做扎实了。那个问题留给每一座仓库自己回答:当系统下一次报警时,你的维修班是会立刻去查,还是会先看一眼就划掉?
作者:陈博士|供应链行业研究员