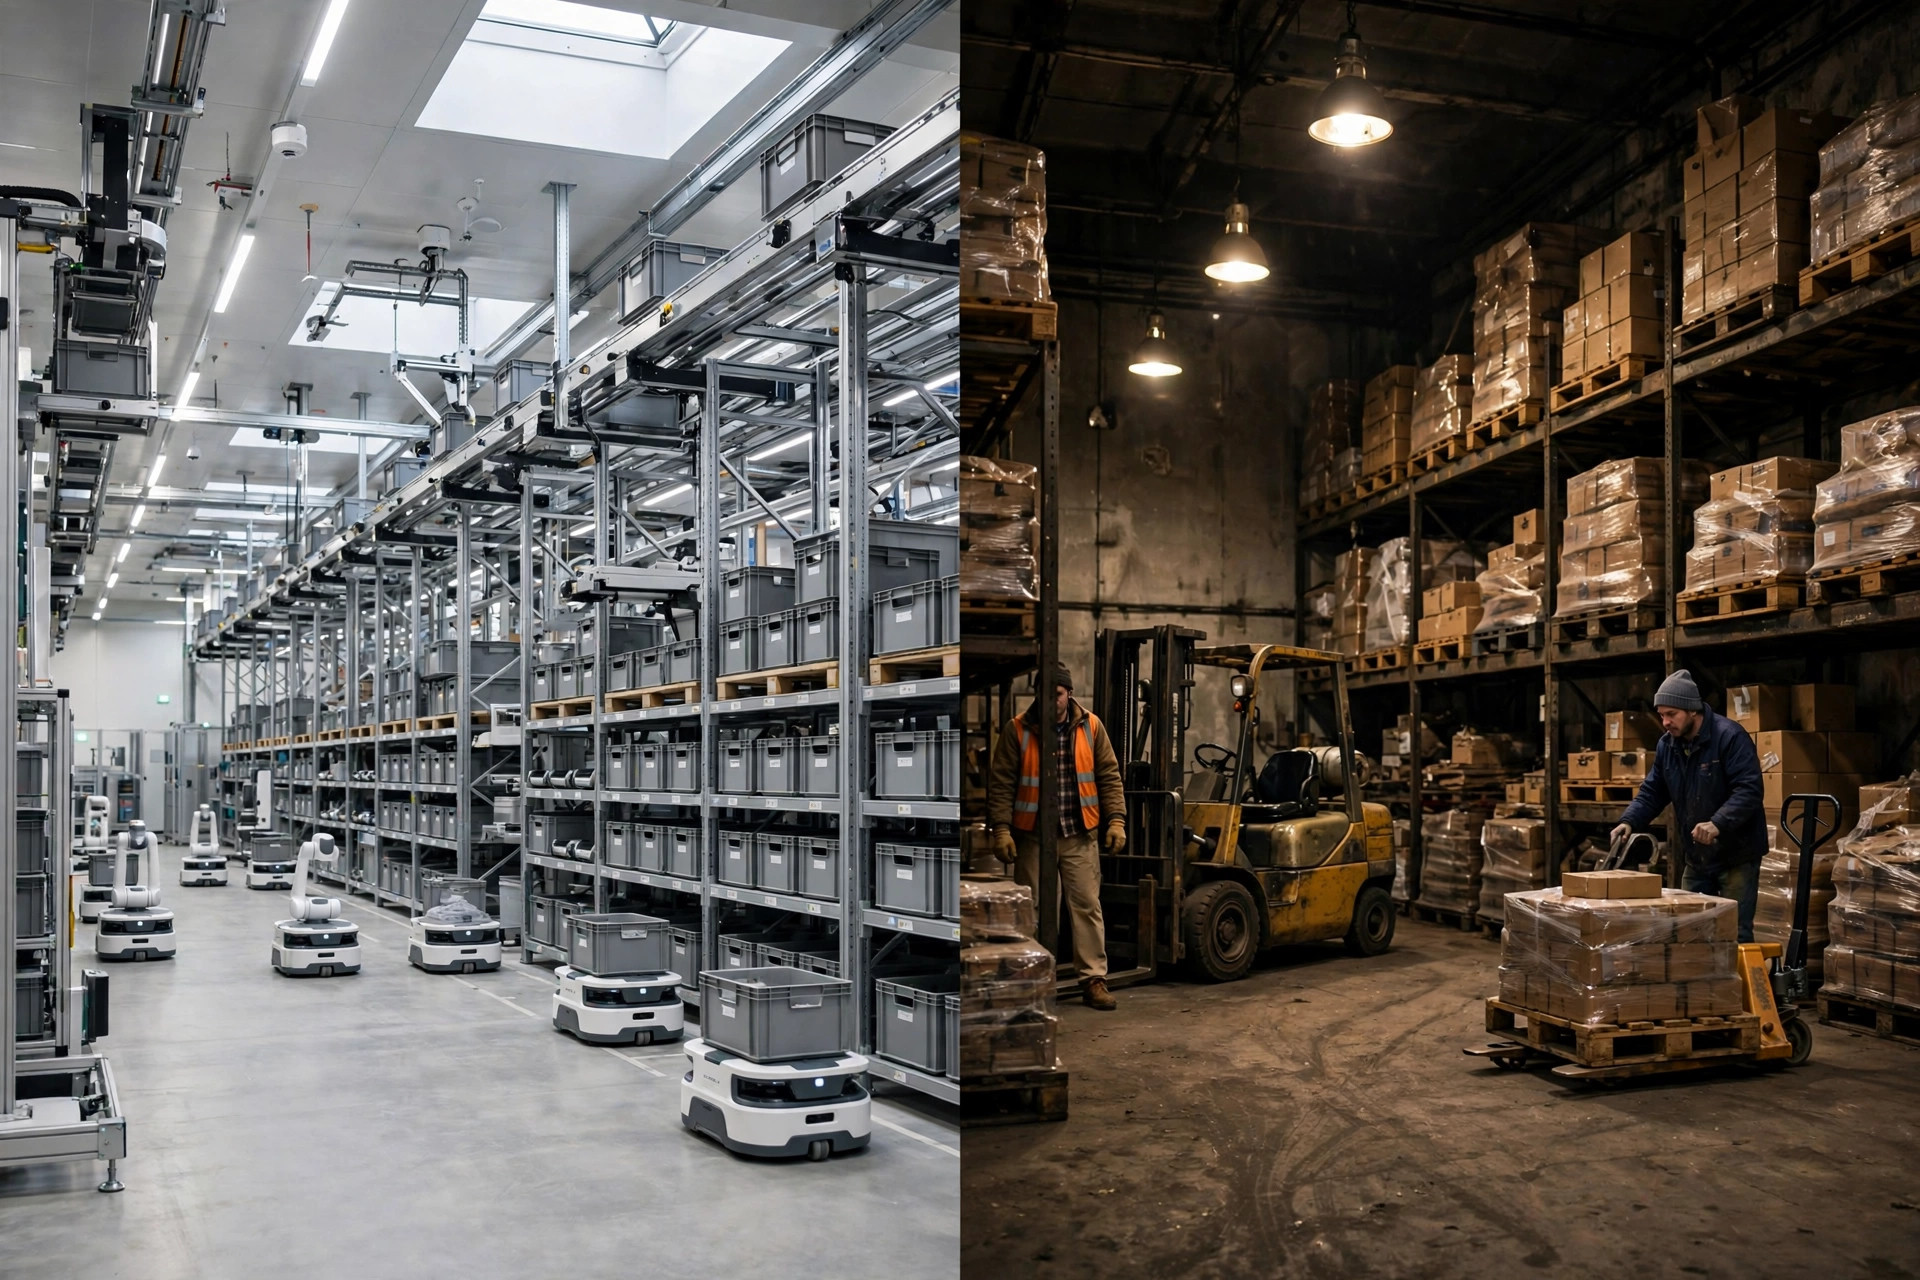
过去两年,我访谈过二十多家启动过 AI 试点的仓储与零售企业,注意到一个高度一致的选择模式:试点几乎无一例外地落在了公司条件最好的那个仓里——网络最稳定、SKU 主数据最完整、流程最标准、员工配合度最高、管理层最支持的旗舰仓。这个选择看起来完全符合常识:试点当然要放在最容易成功的地方,先把概念验证跑通,再谈复制推广。但耐人寻味的是,当这些企业在六到十二个月之后把方案推向第二个、第三个仓时,另一个同样高度一致的现象出现了:试点期的漂亮数字大幅缩水,有的项目甚至在推广阶段直接停掉。试点"成功"了,推广却失败了——这个悖论,值得认真拆解。
数字:试点和规模化之间隔着一道坎
根据麻省理工学院 NANDA 项目 2025 年 8 月发布的《生成式 AI 鸿沟:2025 年企业 AI 现状》报告,约 95% 的企业生成式 AI 试点没有产生可在损益表上衡量的回报,只有约 5% 的组织真正捕获了规模化的价值。这里需要说明口径:这个 95% 是以全部受访企业为分母计算的;如果只看真正跑过试点的企业,大约四分之一最终进入了规模化阶段。无论按哪种口径,结论都是一致的——从试点到规模化,存在一道大多数企业没能跨过的坎。而我的观察是,这道坎的第一个台阶,往往在试点选址决定的那一刻就已经埋下了:选址本身就是一种抽样,而用最好的仓做试点,本质上是一次有偏抽样。
为什么最好的仓,恰恰是最差的试点样本
这个悖论背后有三重机制。
第一,禀赋混淆。旗舰仓的先天条件——干净的数据、标准的流程、稳定的网络、配合的团队——本身就能让任何方案"看起来"更有效。统计学上这叫选择偏差:你以为自己在测量 AI 的效果,实际上测量的是"好仓 + AI"的联合效果,却把全部功劳记在了 AI 名下。试点 ROI 里,有相当一部分是仓的禀赋在买单,而不是算法在买单。
第二,资源倾斜。试点期是一个被特殊照顾的时期:厂商派驻工程师驻场、总部派项目经理跟进、仓里最得力的员工被抽调配合测试。这些隐性投入不会出现在试点成本的分母里,但它们真实存在,并且真实地推高了试点效果。推广阶段资源撤走,效果自然回落——这不是 AI 失灵,而是试点期的"温室条件"消失了。
第三,叙事上的幸存者偏差。跑出漂亮数字的试点会被写成案例反复讲述,效果平平的试点则悄悄结项、不再提起。行业里流传的"试点 ROI",是一个经过筛选的样本,它系统性地高估了真实水平,也进一步强化了"选最好的仓做试点"这个看似正确的直觉。
先看第一个案例。2024 年下半年,苏州一家 3PL 的旗舰仓上线了 AI 视觉复核试点。三个月下来,复核准确率从 99.2% 提升到 99.6%,差错拦截量接近翻倍,项目组据此测算年化可节约复核人力成本约 40 万元,试点被评为"超预期成功"。2025 年初,方案推广到无锡、合肥两个区域仓——同样的设备、同样的算法版本,准确率提升不到 0.1 个百分点,基本可以忽略不计。复盘时才发现关键差异:旗舰仓的复核台是 2023 年刚改造过的,灯光明暗均匀、托盘和周转箱全部标准化;而区域仓灯光老旧、纸箱规格杂乱。视觉模型在试点仓里"学会"的,恰恰是标准化环境下的图像特征。换句话说,这次试点测的不是算法的泛化能力,而是试点环境的友好程度。
第二个案例来自 2025 年第一季度,美国一家零售连锁在达拉斯的旗舰配送中心启动需求预测 AI 试点,覆盖周边约 120 家门店。该仓 SKU 主数据完整率 98%,促销记录齐全。六个月后,预测误差(MAPE,平均绝对百分比误差)下降了约 4 个百分点,缺货率下降 1.2 个百分点,试点结论是"成功,建议推广"。随后复制到中西部两个配送中心,SKU 主数据完整率只有八成出头,促销数据大量缺失,模型效果只剩试点期的三成左右。项目组后来换了一个"中等生"仓重做试点:数据有缺口、流程有例外、人员配合度一般。这次试点的数字不如第一次好看,但基于这次试点制定的数据治理清单和推广手册,在后续四个仓全部一次落地成功。项目负责人的总结很直白:第一次试点证明的是"AI 在理想条件下能行",第二次试点证明的是"AI 在我们的真实条件下能行"——管理层真正需要的,是后者。
这里有一个反常识的判断:试点 ROI 跑赢预期的项目,恰恰最值得警惕——因为它很可能不是 AI 太强,而是试点仓的条件太好。一个在"中等偏下"的仓里跑出来的、数字难看 20%~30% 的试点,测的是方案的下限;而在旗舰仓里跑出来的漂亮数字,测的只是上限。管理层真正要的从来不是"试点成功",而是"推广成功",而这两个目标对应的选址逻辑,恰好是相反的:前者求稳,后者求真。
试点选仓的三条线
| 选仓类型 | 典型特征 | 试点策略 |
|---|---|---|
| 旗舰仓(条件最好) | 数据干净、流程标准、资源倾斜 | 只做技术可行性验证,不做 ROI 承诺;结论标注为"上限参考" |
| 中等代表仓(推荐) | 规模、SKU 结构、人员水平接近公司平均 | ROI 测算的主战场;结论可直接支撑推广决策 |
| 问题典型仓 | 有代表性的真实痛点,如复核差错率高、缺货率高 | 验证方案能否解决真问题;因果归因最清晰 |
| 避开:新建仓、搬迁仓、大促承压仓 | 基线不稳、变量太多 | 不适合做试点,数据无法归因 |
还有一个值得补上的要素:对照组。有条件的话,设一个"影子对照"——同区域另一个条件相近的仓,同期不上 AI,只记录基线数据;或者同一仓内按品类、按时段做对照。没有对照组的试点 ROI,严格来说是一个无法证伪的数字,它的说服力只存在于汇报的 PPT 里。
一个正在发生的转变
随着企业 AI 投入从"试验期"进入"规模化期",试点方法论正在发生变化。早期的逻辑是"先让它跑起来",选址求稳、求快;现在的逻辑是"先让它经得起复制",选址求真、求代表性。我的判断是,到 2027 年前后,"试点选址代表性评估"会成为大企业 AI 治理流程中的标准环节——不是因为大家突然变得严谨了,而是因为交过学费的企业已经足够多了。谁先把选址这门课补上,谁在推广阶段的试错成本就越低。
最后,留一个问题。如果一套 AI 方案只能在条件最好的仓里跑出漂亮数字,换到普通仓就失灵,我们到底该问"AI 行不行",还是该问"我们的仓,配不配得上这套 AI"?更进一步:当试点选址本身就能在很大程度上决定试点成败时,过去两年行业里流传的那些"AI 成功案例",有多少测的是技术,又有多少测的只是选址的眼光?这个问题没有标准答案,但每个准备启动试点的企业,都值得在签字之前,先把它问自己一遍。
作者:陈博士|供应链行业研究员