仓库里的视觉 AI 项目,有一个公开的秘密:预算超支的时候,钱很少花在模型上。
超支很少发生在模型上
2023 年,美国中西部一家区域性 3PL 上了一套包裹破损视觉检测系统。立项时预算的大头是这么分的:算法团队、GPU 算力、现场部署——典型的"模型思维"。项目跑到第六个月,预算超了四成,复盘发现超支部分里超过一半,花在了一个当初只占一行预算的条目上:数据标注。
无独有偶。同一年,华东一家电商大仓做 SKU 自动识别,目标是替代人工核对环节。算法 demo 两周就跑通,准确率在测试集上很好看;一上真实产线就垮——夜班灯光一变、纸箱一堆叠,识别率直线下降。团队回头补拍、补标了三个月的数据,项目周期直接翻倍。
根据多家咨询机构近年对企业 AI 落地项目的调查(如 Gartner、麦肯锡的相关报告),数据准备与标注环节通常占到项目总投入的四到六成,是单个占比最高的成本项。这个数字值得琢磨:大家谈 AI 落地都在谈模型、谈算力,钱却花在了最"不性感"的环节。模型是 1%,数据是 99%——这句话在仓库场景里,比在其他任何场景都更接近字面意思。
先给方法论,再给量级:到底要拍多少张
"拍多少张照片才够"没有标准答案,因为答案取决于四个变量:类别数、类间相似度、场景变化幅度、目标精度。任何不谈这四个变量就直接给数字的回答,都可以忽略。
给一个量级测算,假设条件如下:
| 假设项 | 取值(假设) |
|---|---|
| 活跃 SKU 数 | 10,000 |
| 每 SKU 有效样本 | 200~500 张 |
| 总样本量 | 200 万~500 万张 |
| 单张标注成本 | 以服务商实际报价为准(量级:美分到几毛钱人民币/张,视标注复杂度) |
| 质检返工率 | 15%~30%(量级假设) |
算下来,标注环节的投入是"百万元人民币量级"(具体以实际报价和返工率为准)。注意这个表里最扎眼的一行不是总量,而是返工率:标注不是一次性支出,质量管控和返工才是无底洞。拍照片本身只占小头——贵的是"标得对",以及"标错了重来"。
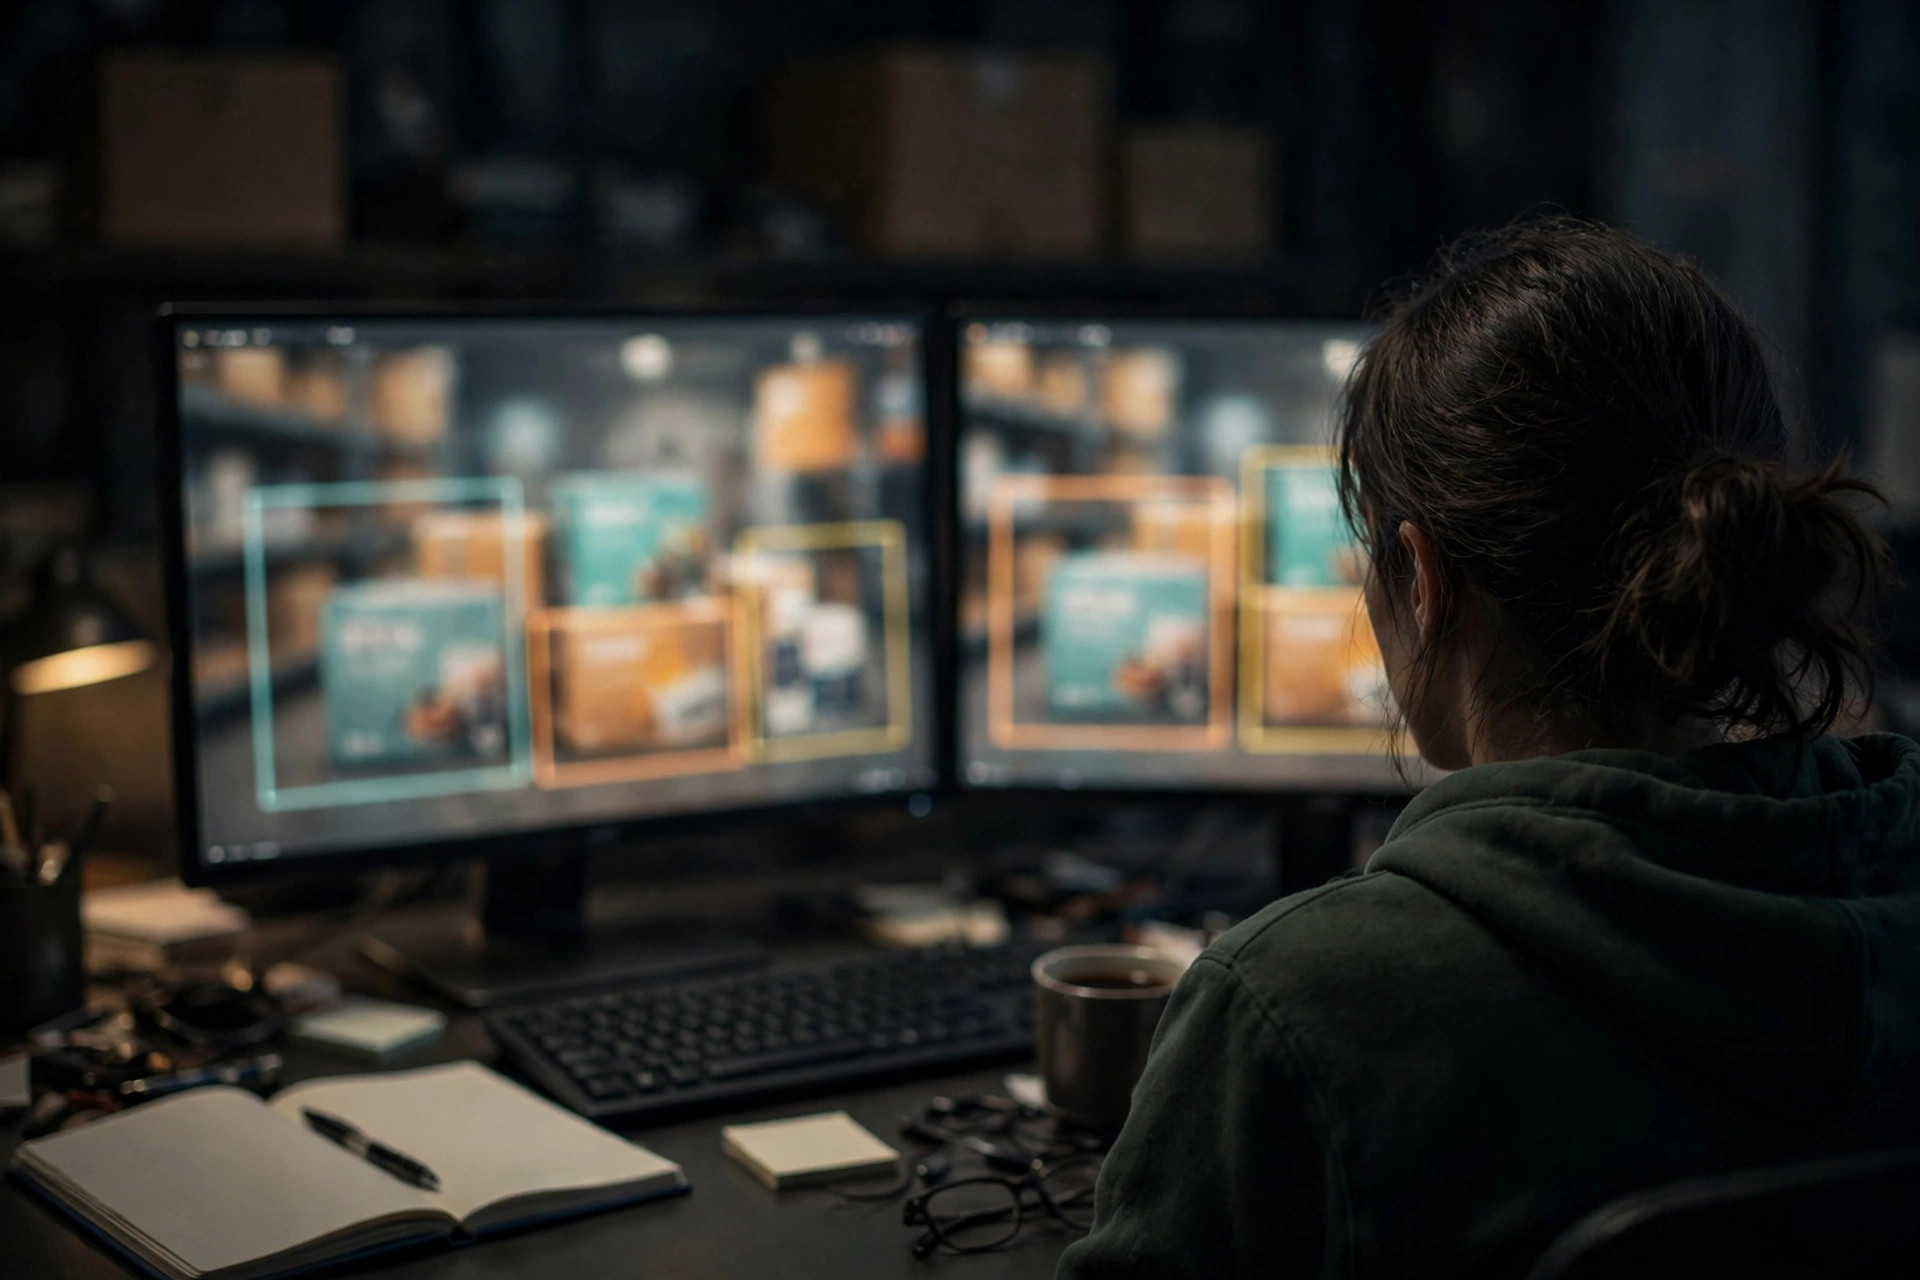
还有一个常被忽略的维度:标注产能的组织成本。多家市场调研机构的测算口径显示,数据标注服务市场在 2020 年代初保持着每年 20% 以上的增速(具体口径以各机构报告为准)——这意味着标注这件事正在从"项目杂活"变成一个独立产业。对仓库甲方来说,这既是好消息(供给在变多、单价长期看跌),也是坏消息:产业化带来的是标准化报价,而不是对你家仓库业务的理解。标注员分不清"封箱胶带开裂"和"纸箱破损",标出来的数据噪声,最后都由你的模型准确率买单。所以外包标注从来不是"交出去就完事",甲方必须配一个懂业务的人做规则制定和抽检——这部分人力成本,立项时几乎从不计入预算,复盘时却总在超支清单里。
仓库场景的标注为什么格外贵
归因有四层,一层比一层难绕开。
第一,SKU 种类多且换代快。一个中等电商仓的活跃 SKU 轻松过万,季节性商品三个月一换——模型还没训完,数据已经过期。这是仓库场景独有的"数据折旧",其他行业很少遇到这个速度。
第二,光照变化大。白班有天窗自然光,夜班是顶灯,同一个纸箱在两种光下是两种数据。自动驾驶好歹有标准化的路,仓库的光环境每个仓都不一样,数据很难跨仓复用。
第三,遮挡与堆叠。货架上的商品一半被挡住、传送带上的包裹叠在一起——标注规则必须定义"露多少算一个",规则一变,之前标的全要返工。规则漂移是标注项目里最隐蔽的成本:不是标错了,是标准变了。
第四,长尾异常样本极难凑。破损、漏液、标签褶皱——这些恰恰是视觉 AI 最有价值的场景,但一个仓一年也碰不到几十例。为了凑 500 张破损样本,有团队专门让人"制造"破损去拍照,成本可想而知。
反常识的判断在这里:照片不是越多越好。样本量过了某个拐点,边际收益急剧递减;决定项目成败的不是中间 95% 的常规样本,而是最难的 5% 长尾样本和标注的一致性。很多团队把 80% 的标注预算花在了本来就好识别的品类上——钱花在了最不需要的地方。
两条降本路线:合成数据与预训练模型
趋势判断要分两条线看,依据和时间线都摆出来。
第一条线是合成数据。用 3D 渲染批量生成训练图像,破损、遮挡、极端光照要多少有多少。2021 年之后,随着渲染引擎和生成模型成熟,合成数据的成本降了一个量级。但 sim2real 的鸿沟还在:合成数据训出的模型,第一次见真实仓库时通常要打折扣。目前的格局是"合成数据做长尾补充、真实数据做主体",而不是替代。指望纯合成数据一步到位,目前还不现实。
第二条线是预训练视觉模型。2023 年之后,视觉基础模型的 few-shot 能力起来了:过去需要几千张标注才能收敛的品类,现在几十到上百张就能达到可用精度。这意味着定制标注的需求结构在变化——从"海量通用标注"转向"少量高质量难例标注"。时间线很清楚:标注的总量在降,标注的单位技术含量在升。
选哪条路线,可以看下面这个决策框架:
| 策略 | 适合场景 | 代价 |
|---|---|---|
| 自建标注团队 | 长期、大批量、规则稳定的场景 | 管理成本高,适合头部大仓 |
| 外包标注服务 | 中短期项目、规则明确 | 单价透明,但返工扯皮多 |
| 合成数据补长尾 | 异常样本难凑的场景 | 需验证 sim2real 落差 |
| 预训练模型 + 少量标注 | 新品类快速上线 | 依赖基础模型能力,精度天花板看模型 |
两条线叠加,一个可验证的判断是:未来三到五年,仓库视觉 AI 的标注成本会继续下降,但"标注标准制定"的能力会变得更稀缺——因为模型越来越不缺数据,缺的是"什么算破损"这类业务定义的精确表达。
一个还没答案的问题
如果标注成本继续下降、模型能力继续上升,仓库 AI 的竞争门槛会从"有没有数据"变成"有没有标注标准"。到那时,拼的可能不是谁的 GPU 更多,而是谁的 SOP 写得更清楚——而 SOP,恰恰是仓库行业最不缺、也最不被重视的东西。
这个转换正在发生,只是还没走完。你觉得,你们仓的 SOP,经得起被 AI 逐字执行吗?
作者:陈博士|供应链研究员