지난해 나는 3C 액세서리 창고에서 컨베이어 위의 새 비전 시스템을 지켜보고 있었다. 역할은 박스의 SKU 라벨을 읽고 수동 스캔을 대체하는 것. 데모는 멋져 보였다. 그런데 신제품이 출시되자 첫 주에 시스템은 37개의 신규 SKU를 전부 자신 있게 구형으로 오분류했다. 카메라는 정상이었다. 알고리즘도 정상이었다. 모델이 그 얼굴들을 한 번도 본 적이 없었을 뿐이다 — 그래도 "가장 가까운" 구 카테고리를 골랐다.
이것이 고전 분류기의 치명적 결함이다: 가르친 카테고리 중에서만 고를 수 있다. 본 적 없는 문제를 시험에 내도 그래도 답을 쓴다. 퓨샷 러닝은 바로 이것을 고치기 위해 존재한다.
실제로 학습하는 것
전통적인 이미지 분류기는 각 카테고리의 생김새를 외운다. 제품 A의 사진을 수천 장 보여주면 A의 얼굴을 기억한다; 새 이미지를 보여주면 묻는다: A, B, C 중 어느 쪽에 더 닮았는가? "중"에 주목하라 — 답이 알려진 카테고리 중 하나여야 한다고 가정한다. 신규 SKU는 아무리 특징적이어도 억지로 구 버킷 중 하나에 끼워진다. 이렇게 37개의 신규 SKU가 첫 주에 죽었다.
퓨샷 러닝은 이 논리를 뒤집는다: "이게 누구지"를 외우는 대신 "닮았는가"를 학습한다. 학습 중 모델은 이미지를 숫자열 — 임베딩 — 로 바꾸는 법을 배운다. 비슷하게 생긴 이미지는 가까운 숫자를, 다르게 생긴 것은 먼 숫자를 받는다. 고라이브 때 신규 SKU가 오면 참조 사진 5~20장을 찍고, 시스템은 그 숫자들이 어디에 있는지 기억한다. 이후 모든 새 이미지는 거리로 판단된다: 가장 가까운 참조가 라벨을 가져간다.
인간으로 비유하자면: 고전 분류기는 닫힌 책 시험 — 공부한 것만 나온다. 퓨샷 러닝은 낯선 사람의 얼굴을 알아보는 것과 같다 — 얼굴을 두 번 보고 기억하고, 다음에 군중 속에서 알아본다. 그 사람의 이름이나 직업을 알 필요가 없다. 얼굴을 기억하면 충분하다.
흔한 구현인 프로토타입 네트워크는 더 직설적이다: 각 카테고리의 몇 장의 참조 사진을 평균내어 하나의 "평균 얼굴"로 만들고, 새 이미지를 가장 가까운 평균에 배정한다. 구현은 간단하고 많은 창고 업무에는 충분하다.
빛나는 곳 — 그리고 아닌 곳
빛나는 곳부터. 서로 명확히 다르게 생긴 SKU — 색이 다른 패키지, 크기가 다른 박스, 물리적으로 다른 제품 — 가 본무대다. 신규 SKU가 출시되면 현장이 열두 장 정도의 사진을 찍어 올리고 30분이면 동작한다. 2주짜리 라벨링·재학습 사이클이 없다.
안정적인 패키지도 도움이 된다. 일부 소모품은 몇 년씩 같은 패키지를 유지한다; 참조를 한 번 찍으면 오래 쓴다.
이제 금지 구역. 첫째: 같은 스타일을 다섯 색상으로 내는 의류. 색 외에는 시각적으로 거의 동일하고, 실무에서는 행택과 세탁 라벨로 구분한다 — 컨베이어 속도의 카메라에는 보이지 않는다. 억지로 밀어붙이면 자신만만한 오답만 나온다. 바코드를 찍고 넘어가라.
둘째: 투명하거나 반사되는 패키지. 조명을 바꾸면 "얼굴"이 바뀌고 임베딩 거리가 무너진다. 조명 관리가 산업 등급이 아니면 동작할 거라 기대하지 마라.
셋째: 한 달에 수백 SKU가 도는 카탈로그. 신규 SKU마다 참조 사진 촬영·검토·정리를 해야 한다 — 지속적인 노무다. 참조 라이브러리를 썩히면 정확도는 한 분기 안에 조용히 내려가고, 알지도 못한다.
도입의 세 가지 함정
함정 하나: 참조를 너무 "깨끗하게" 찍는다. 사람들이 현장에 사무실에서 제품을 포즈 잡게 한다 — 흰 배경, 정면 앵글, 완벽한 조명. 그러면 컨베이어는 기울고, 흐릿하고, 그림자 진 이미지를 내놓고 아무것도 매칭되지 않는다. 참조는 실제 컨베이어에서, 실제 조명으로, 실제 속도로 찍어라: SKU당 8~12장, 여러 앵글, 약간 기울이고, 더럽고 손상된 패키지도 포함하라. 참조가 실전 조건에 가까울수록 잘 동작한다.
함정 둘: "모르겠다" 선택지가 없다. 거리가 아무리 멀어도 시스템은 여전히 가장 가까운 것을 고른다 — 항상 답이 있다. 거리 임계값이 필요하다: 그 너머는 미상으로 선언하고 사람에게 넘긴다. 이 임계값은 감이 아니다; 2주치 실데이터를 돌려서 오수락과 오기각이 균형을 이루는 지점을 찾아라.
함정 셋: 오식별 비용을 산정하지 않는다. 한 번의 오식별은 잘못 간 운임 더하기 왕복 더하기 CS 시간이 든다. 한 번의 인간 검토는 몇 초의 노무다. 당신의 일은 총비용을 최소화하는 임계값 엄격도를 찾는 것이다. 이 계산은 창고마다 다르다 — 남의 파라미터를 복사하지 마라.
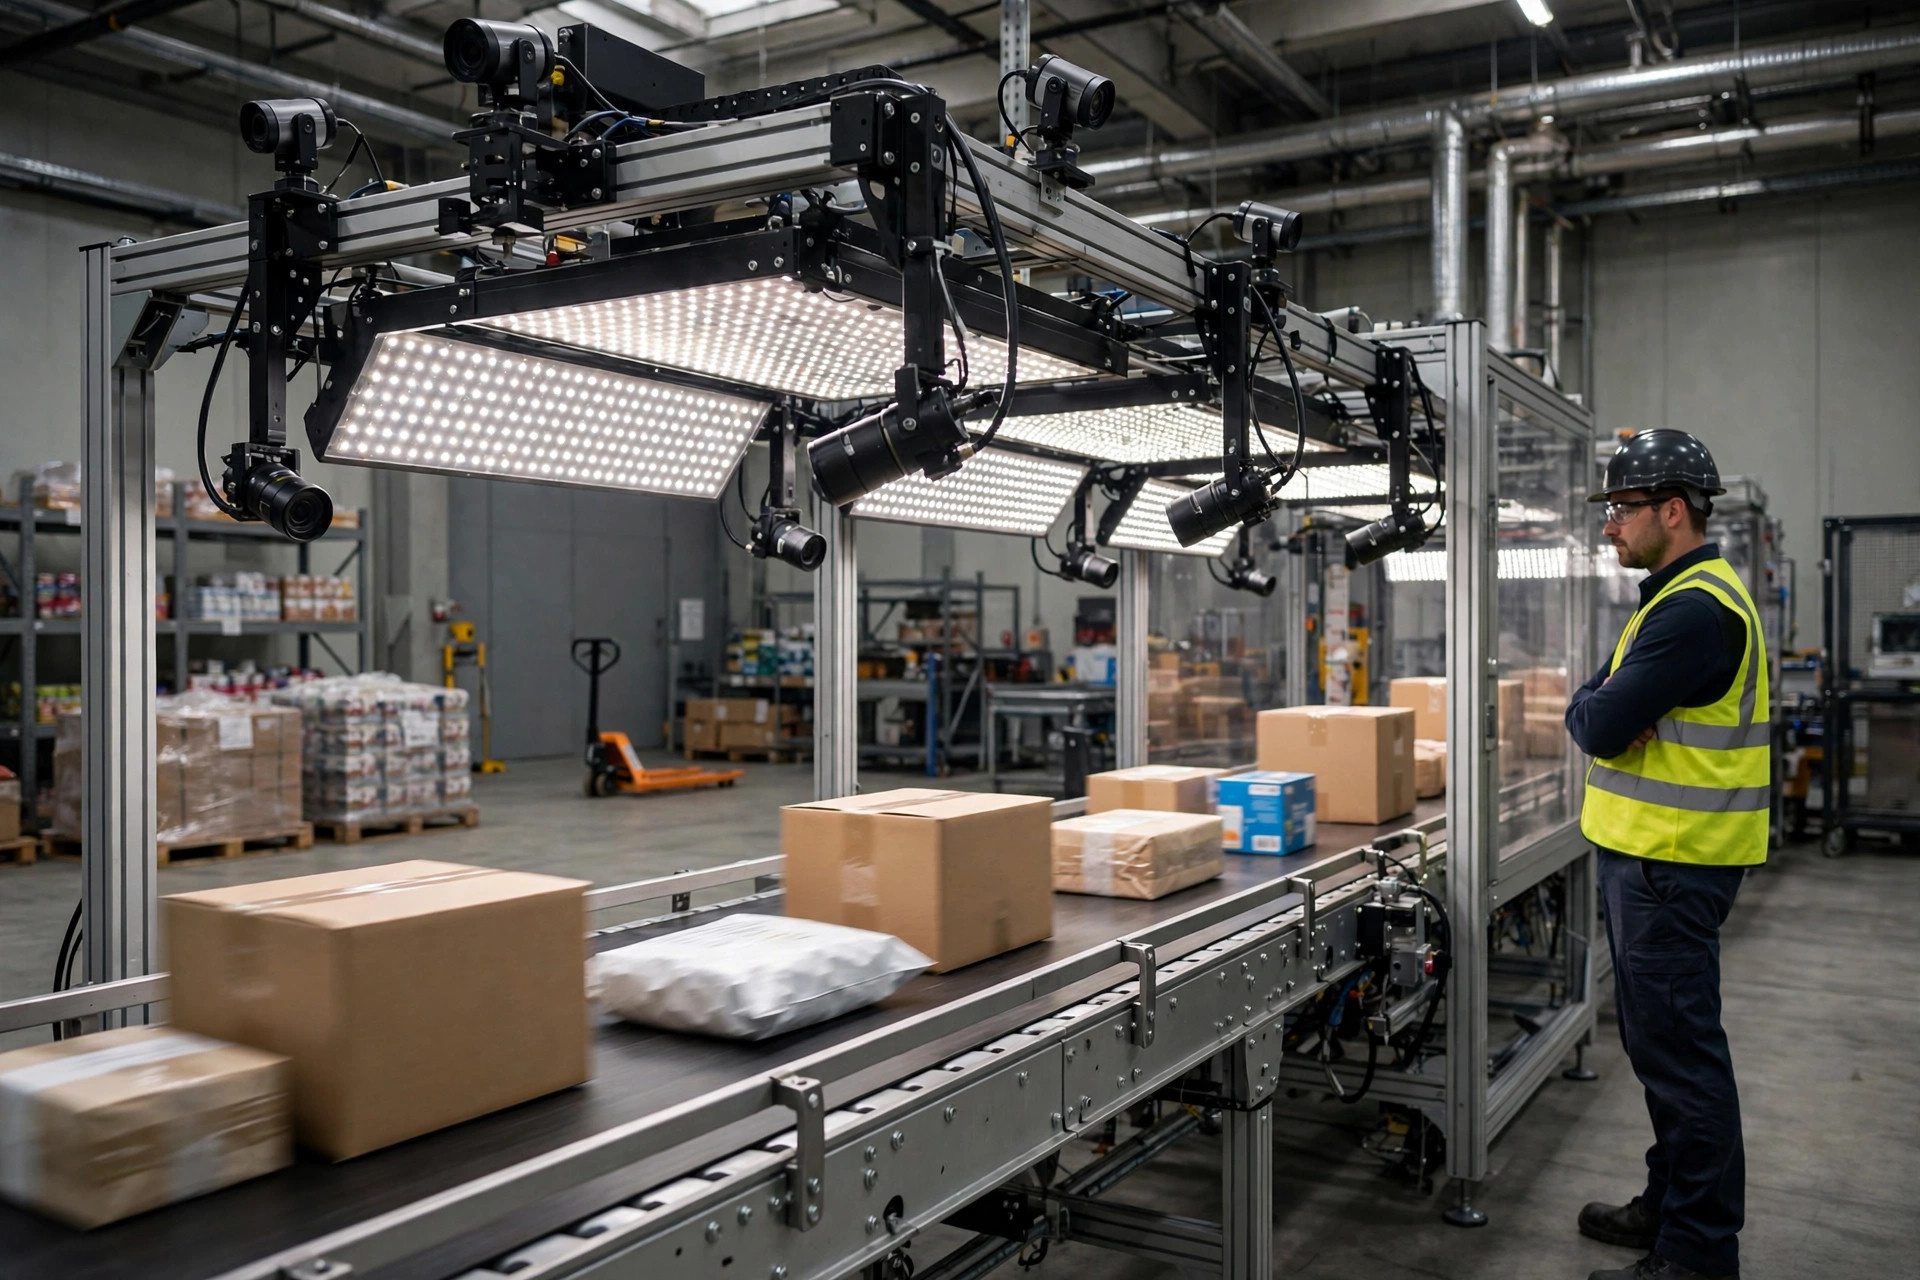
하드웨어 주의점: 카메라를 싸구려로 하지 마라. Basler ace 같은 산업용 카메라와 안정적인 LED 조명의 조합은 일반 웹캠보다 훨씬 일관된 이미지를 만든다. 퓨샷 러닝은 이미지 일관성에 민감하다; 초기에 몇천 달러를 아끼고 나중에 정확도 5포인트를 잃는 것이 더 나쁜 거래다.
통하는 4주 론칭
1주차: 컨베이어에서, 실제 조명으로, 실제 속도로 참조를 찍는다. 어려운 케이스 — 기울어짐, 반쯤 가려짐, 구겨진 패키지 — 를 포함하라. 참조 품질이 천장을 정한다; 이 주를 서두르지 마라.
2주차: 임계값을 정한다. 2주치 히스토리 데이터를 돌려 오수락과 기각의 균형점을 찾는다. 인간 검토를 적게가 아니라 많게 기울여라 — 오출고는 검토 한 번 비용의 수십 배가 든다.
3주차: 한 컨베이어에서, 또는 20개 SKU로 파일럿한다. 오식별은 매일 검토하고 나쁜 참조는 교체한다. "다르게 생겼는데 실제로는 안 다른" SKU 쌍을 발견하게 된다 — 지금 처리하라.
4주차: 확대하고 유지보수 프로세스를 고정한다 — 누가 신규 SKU를 촬영하는지, 묵은 참조를 얼마나 자주 검토하는지, 임계값을 얼마나 자주 재조정하는지. 유지보수 프로세스 없는 시스템은 3개월 안에 망가진다. 보장한다.
벤더에게 물어볼 것
모든 비전 벤더의 데모는 멋져 보인다. 서명 전에 다섯 가지 질문을 하라.
하나: 신규 SKU가 가동까지 얼마나 걸리는가? 답이 "모델 재학습, 2주"라면 그것은 퓨샷으로 위장한 고전 분류기다. 진짜 퓨샷은 재학습이 아니라 참조 추가다 — 2주가 아니라 30분이다.
둘: 오식별율과 "모르겠다"율을 따로따로. 정확도만 말하는 업체는 뭔가를 숨기는 것이다. 정확도 99%에 30%가 사람에게 넘어가면 일의 3분의 1은 여전히 수작업이다.
셋: 조명 드리프트는 어떻게 처리하는가? 데모룸 조명을 절반으로 낮추고 다시 돌려보라고 해라. 쇼룸 조명에서 99%를 내는 시스템 상당수가 창고 형광등 절반이 노후화되면 90%로 떨어진다.
넷: 참조 라이브러리에 SKU 카테고리를 몇 개나 담을 수 있는가? 일부 임베딩 검색 구성은 수천 카테고리를 넘기면 크게 느려진다. 카탈로그가 다섯 자리 숫자면 지금 물어라.
다섯: 오프라인으로 도는가? 엣지인가 클라우드인가? 컨베이어는 1분에 수십 개의 박스를 흘린다; 클라우드 구성에서 네트워크가 한 번 삐끗하면 라인 전체가 멈춘다. 창고 업무에는 엣지 도입만 권한다.
다섯 가지에 모두 깔끔히 답한 벤더는 가격 협상을 해볼 만하다. 답하지 못하는 업체는 — 데모가 아무리 세련됐어도 — 파는 것이 견본시 전시품이지 생산 도구가 아니다. 기술은 마법이 아니다. 맞는 곳에 쓰는 것이 마법이다.
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.