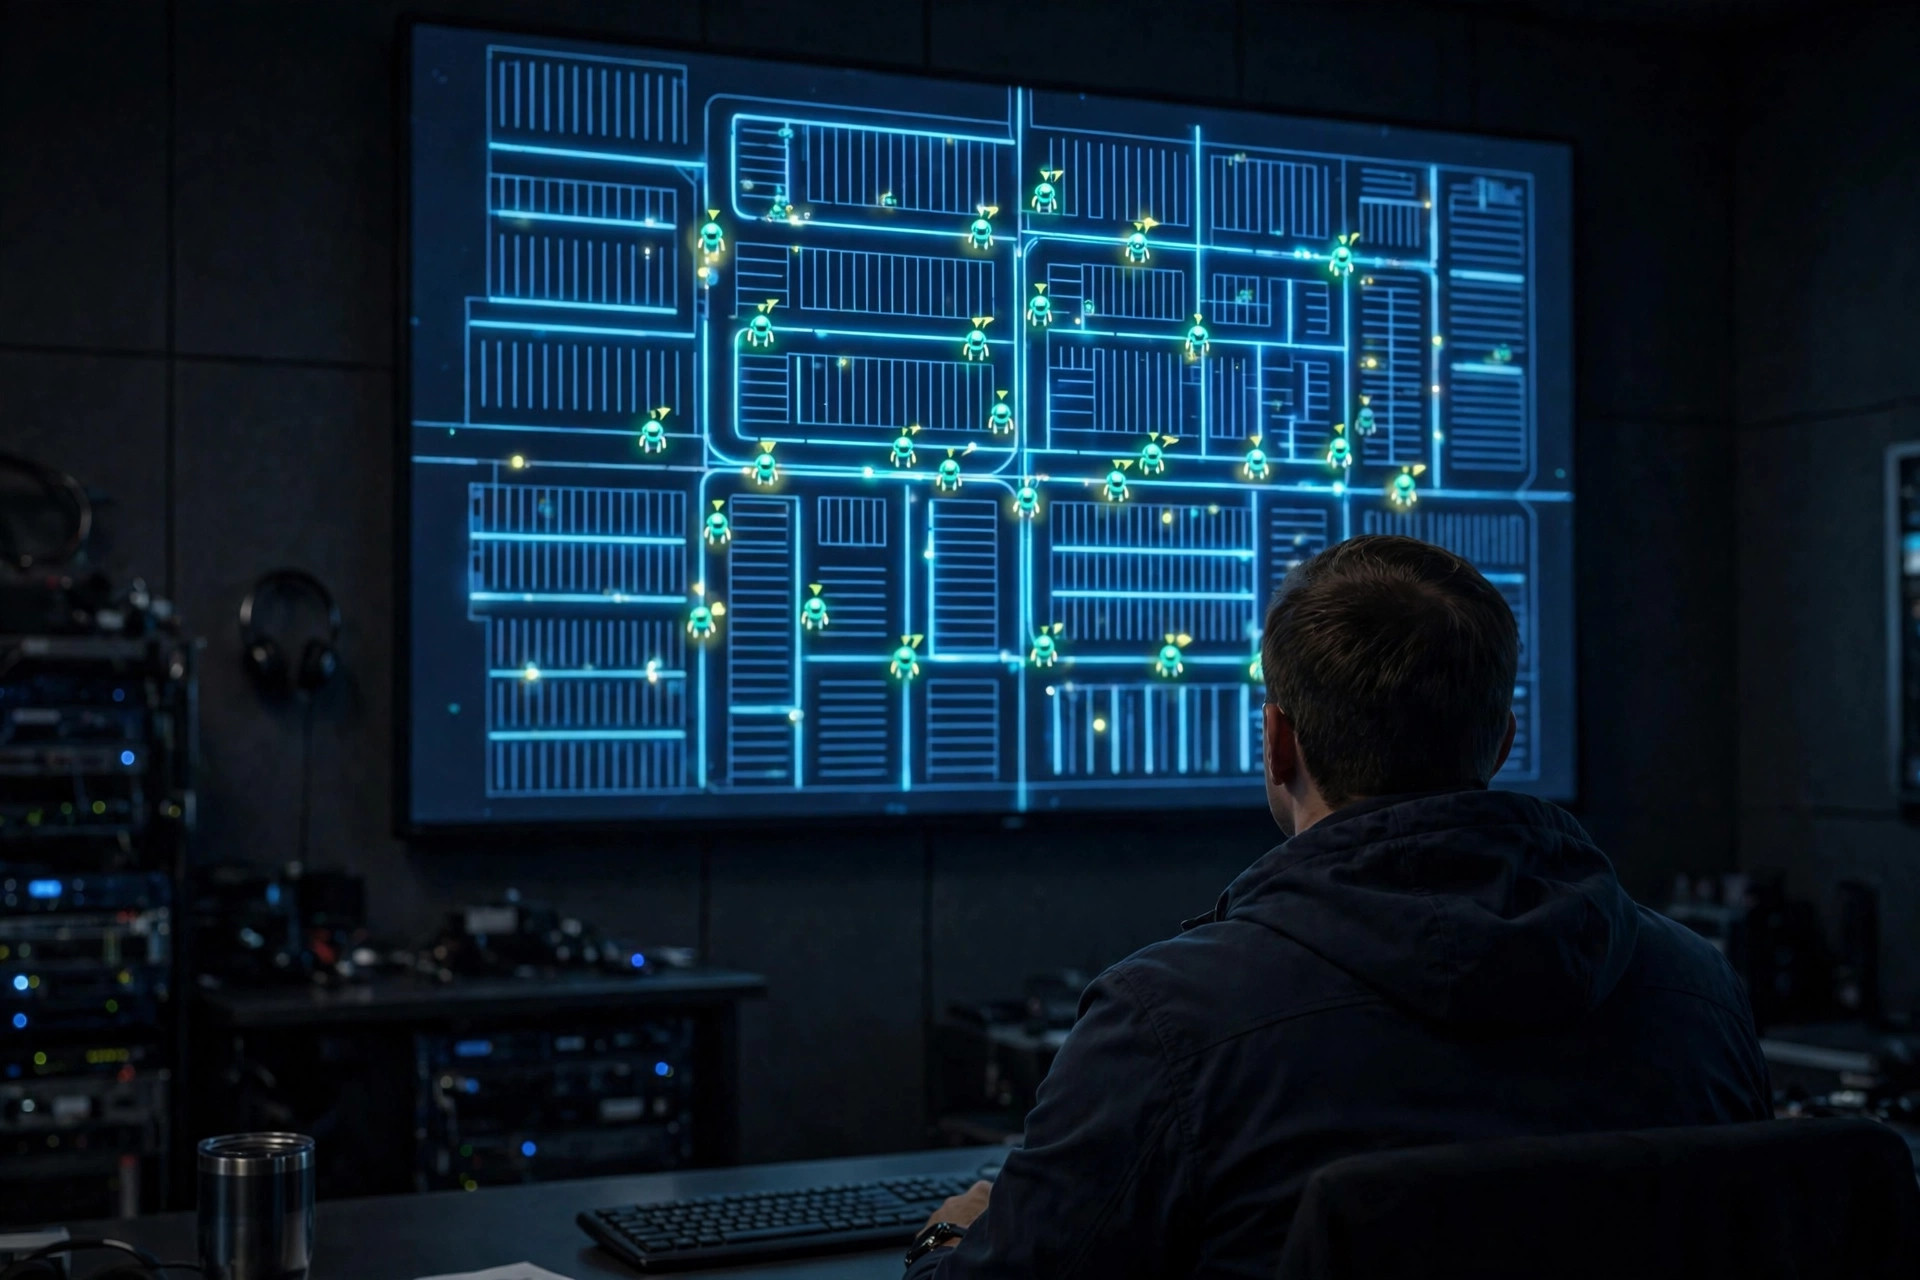
AMR 벤더에게 네트워크가 끊기면 어떻게 되는지 물어보면 방 안이 조용해지는 걸 볼 수 있다. 데모는 항상 해피 패스만 보여준다: 미끄러지듯 움직이는 로봇, 할당되는 작업, 초록빛으로 빛나는 대시보드. 새벽 2 시의 전화는 아무도 데모하지 않는다. 하지만 나는 그 전화를 받아본 적이 있다. 그리고 나쁜 밤과 재앙을 가른 것은 로봇이 아니었다——아무도 설정할 생각을 하지 않았던 세 가지 설정이었다.
지난 겨울, 시카고 외곽의 한 물류센터가 정기 스위치 재부팅 중에 RCS 를 약 15 분간 잃었다. 스무 대가 넘는 로봇이 통로 한가운데서 멈춰 섰다. 야간 근무조는 훈련받지 않은 사람들이 하는 대로 했다: 로봇을 한 대씩 재부팅하기 시작했고, 그 때문에 작업 상태는 더 꼬였다. 네트워크가 돌아왔을 때쯤이면 함대의 절반은 "offline", 나머지 절반은 "task exception"을 표시했고, 이를 푸는 데 거의 2 시간이 걸렸다. 로봇은 멀쩡했다. 계획이 없었던 것이다.
불편한 진실이 있다: 로봇과 RCS 의 연결은 뇌와 몸의 연결이며, 뇌가 침묵할 때 몸이 무엇을 할지에 대한 기본값은 벤더마다 다르다. 그 기본값이 계약서에 없다면 당신은 놀라움을 사는 셈이다.
네트워크는 죽기 전까지 아무도 테스트하지 않는다
첫 번째 설정은 링크 상실 시 동작이다: 로봇이 네트워크 사망을 선언하기까지 하트비트 없이 얼마나 기다리는지, 그리고 그 다음에 무엇을 하는지. 타임아웃을 너무 짧게 잡으면 Wi-Fi 가 잠깐 끊길 때마다 전 층 비상 정지가 걸린다. 너무 길게 잡으면 정말 죽은 네트워크 아래에서 로봇이 낡은 지시대로 계속 주행한다.
타임아웃 이후 벤더들은 대체로 두 가지 철학을 제공한다. 보수적인 쪽: 그 자리에서 멈추고 기다린다. 사람과 로봇이 섞인 교통과 복잡한 통로가 있는 건물에 맞는다. 공격적인 쪽: 로컬 모드로 전환해 탑재된 지도 캐시로 현재 작업을 마치고, 방해되지 않는 곳에 주차한다. 더 똑똑해 보이지만 함정이 있다——로컬 지도가 최신이어야 한다. RCS 가 방금 임시 출입 금지 구역을 발령했는데 로봇이 다운 전에 동기화하지 못했다면, 로컬 모드는 막힌 통로로 곧장 돌진할 것이다.
내 의견: 혼합 교통 건물은 제자리에서 멈춰야 하고, 폐쇄된 고정 경로 생산 라인은 로컬 계속 운행을 고려할 수 있다. 어느 쪽이든 감속은 타협 불가다——눈먼 채 달리는 로봇은 평소보다 느리게 달려야 한다. 그것을 인수 기준에 문서로 넣어라.
네트워크 자체에 대해 한마디: 대부분의 "장애"는 죽은 네트워크가 아니라 죽은 구역이다. 두 액세스 포인트 사이를 이동하는 로봇이 핸드오버에 실패하고, 하트비트가 몇 초간 끊기고, RCS 는 그것을 잃었다고 선언한다. RCS 서버는 유선으로 연결하라——Wi-Fi 를 두고 로봇과 싸우게 하지 마라. AP 커버리지에 이중화를 넣고, 모서리와 높은 랙 뒤쪽을 점검하라. 가동 전에 함대를 건물 전체에 돌려 로밍 테스트를 하고 약한 지점부터 고쳐라. 나중에 타임아웃을 조정하는 것보다 훨씬 낫다.
계약서에 묻힌 세 가지 설정
두 번째 설정은 작업 큐다: 로봇이 무엇을 기억하는지, 그리고 네트워크가 돌아왔을 때 누구의 주장이 이기는지. 탑재된 로봇은 보통 현재 작업에 대기 중인 한두 개의 작업을 더해 캐시한다——캐시 깊이는 벤더마다 다르다. 얕은 캐시는 몇 분을 넘는 다운에 작업 목록이 지워지고, 복구 후 RCS 가 모든 것을 다시 할당해야 함을 뜻한다. 깊은 캐시는 로봇이 기억에 의존해 조금 더 계속 일함을 뜻한다.
진짜 함정은 재회의 순간이다. RCS 는 다운 전의 세상 그대로 깨어난다. 로봇은 다운 중에 한 일을 들고 있다. 일부 시스템은 로봇 측에서 조정한다——로봇이 보고하고 RCS 가 받아들이며, 작업은 멈춘 지점에서 재개된다. 다른 시스템은 RCS 측에서 조정한다——장애 구간 중의 모든 것이 무효화되고 다시 할당된다. 그 두 번째 설계에서는 로봇이 이미 라인에 배달한 팔레트가 "not delivered"로 표시되고, 시스템이 하나를 더 보낸다. 이중 배달, 라인에 팔레트 두 개, 그리고 누구 탓인지에 대한 말다툼이다.
그러니 계약 전에: 네트워크가 복구되면 누구의 작업 상태가 이기는지, 중복 실행은 어떻게 제거되는지. 두 답 모두 계약서 부속서에 넣어라. 선정 중에는 해피 패스 데모만 보지 말고, 벤더에게 5 분간의 네트워크 다운과 복구 데모를 요청해 조정 로직이 버티는지 지켜봐라. 그 데모에서의 머뭇거림이 모든 것을 말해준다.
세 번째 설정은 수동 인수다: 누가 로봇을 수동으로 전환할 수 있는지, 어떻게, 그리고 그 후에 무슨 일이 일어나는지. 장애가 길어지면 현장의 누군가는 항상 "내가 직접 운전하지"라고 생각한다. 규칙이 없으면 세 교대조가 세 가지 다른 일을 한다——로봇 밀기, 전원 껐다 켜기, 배터리 뽑기. 나는 정확히 그 장면을 한 번 목격했다: 복구 후 어떤 로봇이 작업 중이었고 어떤 로봇이 그저 길을 잃었는지 아무도 알 수 없었다. 사람들이 함대의 절반을 만졌기 때문이다.
해결책은 지루하고 필수적이다: 교대조마다 장애 지휘관 한 명을 지정하라, 보통은 교대조 리더다. 다른 누구도 로봇에 손대지 않는다——수동 이동도, 전원 껐다 켜기도 금지. 복구 후 지휘관이 체크리스트를 돌며 각 로봇의 상태를 확인하고, 그제야 재개 명령을 내린다. 운영 매뉴얼에 쓰고 신입 교육에서 가르쳐라. 그리고 권한은 엄격히 제한하라: 수동 모드 권한은 리더에게, 모두에게가 아니다. 작업자에게 필요한 것은 상태 가시성이지, 열쇠가 아니다.
여기서 가장 중요한 인수 테스트 이야기로 넘어간다. 가동 주간에 진짜로 플러그를 뽑아라——슬라이드도, 랩 데모도 아닌, 실제 네트워크 케이블을, 실제 건물에서, 실제 생산 중에 뽑는 것이다. 모든 로봇을 지켜봐라: 상실을 선언하기까지 몇 초인지, 멈추는지 계속 가는지, 얼마나 멀리 가는지, 복구 시 작업이 조정되는지, 이중 할당이 생기지 않는지. 모두 기록하라. 그 문서가 장애 플레이북의 초안이 된다.
그리고 소방 훈련처럼 분기마다 해라. 네트워크 장비는 노후화되고, RCS 는 업그레이드되고, 로봇 펌웨어는 바뀐다——어느 것이든 기본값을 조용히 뒤집을 수 있다. 저생산 시간대를 골라 10 분간 케이블을 뽑고, 플레이북이 여전히 작동하는지 확인하라.
장애 자체는 재앙이 아니다. 재앙은 성수기에 페일오버 계획을 처음 발견하는 것이다. 필요하기 전에 리허설하라, 그러면 새벽 2 시의 전화는 훨씬 짧아진다.
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.