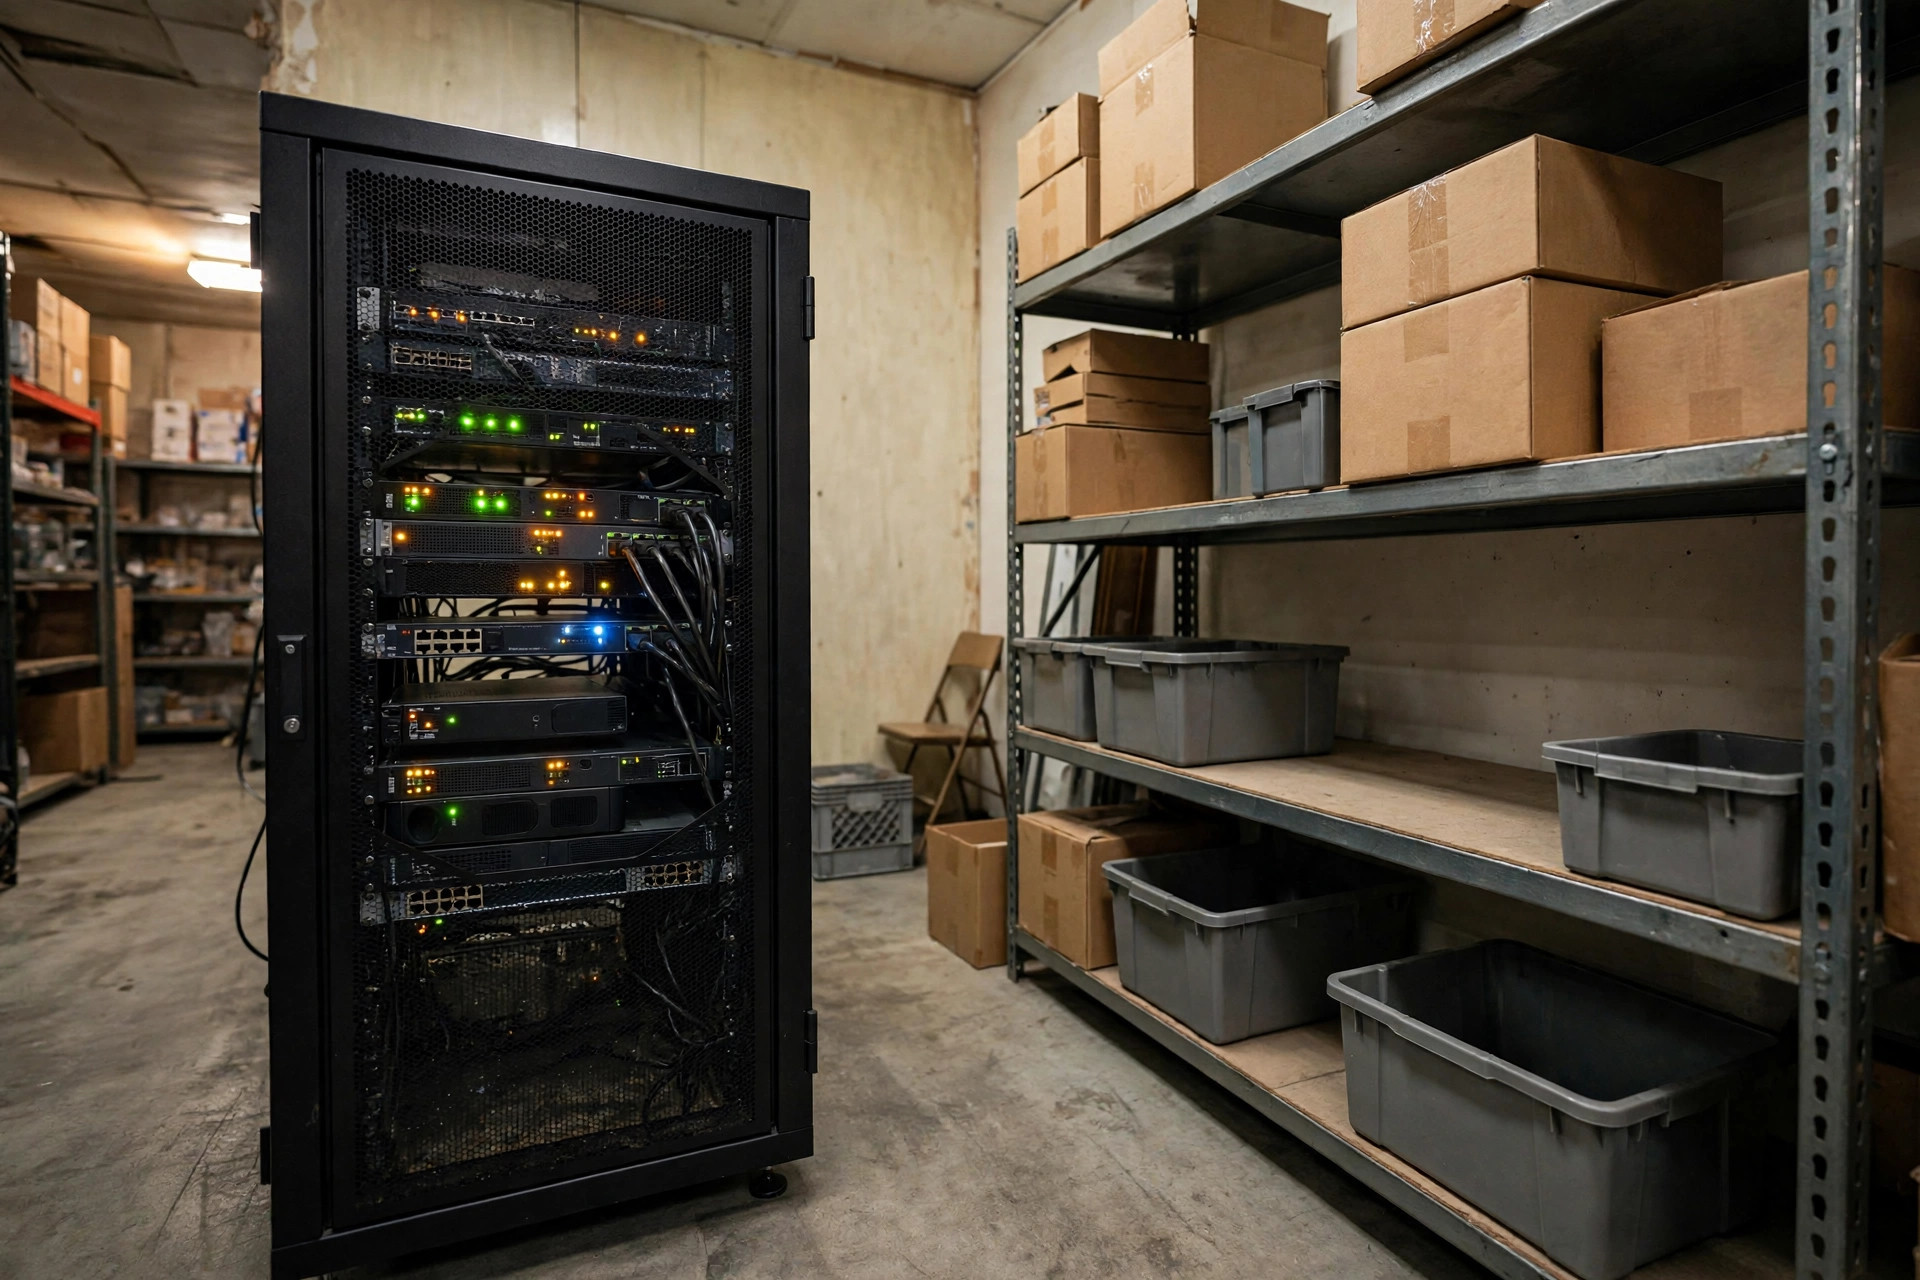
2026년 창고 디지털화에서 가장 조용한 구조적 변화가 무엇인지 꼽으라면, 오픈소스 LLM의 로컬 배포가 상위권에 들 것이다: 출시 행사도, 투자 헤드라인도 없지만, 창고가 AI를 소비하는 방식을 꾸준히 바꾸고 있다. 얼마 전까지만 해도 AI 어시스턴트는 데이터를 클라우드에 보내고 토큰당 비용을 지불하는 것이었다; 오늘날 더 많은 창고 운영자들이 진지한 질문을 던지고 있다 — 모델이 그냥 우리 층의 서버 캐비닛에 상주할 수는 없는가?
현상: 창고 Q&A가 클라우드에서 되돌아오고 있다
이것은 실험실의 환상이 아니다. 2026년 10월 10일, 로컬 퍼스트 RAG 플랫폼 AnythingLLM은 "Stop Renting Your Intelligence" 테제를 발표했다: 문서 처리, 벡터 검색, 모델 실행을 하나의 설치 가능한 패키지로 통합하여 기업이 자사 네트워크 위에 다중 사용자 지식 어시스턴트를 약 5분 만에 구축할 수 있게 하는 것이다. 그보다 앞서 공개된 비즈니스 케이스 문서(arxindustries, 2026)는 이미 그 길을 걸었다: 워크스테이션급 하드웨어 위에 140억 파라미터의 오픈 모델, 로컬 벡터 데이터베이스에 100GB의 기밀 문서, 최소 3명의 동시 사용자를 위한 내부 웹 인터페이스로 제공 — 명시된 주된 동기는 비용 절감이 아니라 "민감한 데이터가 조직의 부지를 절대 벗어나지 않는다"였다.
한편 로컬 기업 Q&A 시스템의 레시피는 오픈소스 커뮤니티에서 고도로 표준화되어 왔다: Ollama가 모델을 실행하고, 오픈소스 벡터 데이터베이스가 지식을 보관하며, OpenWebUI 또는 AnythingLLM이 채팅 인터페이스를 제공한다 — 모든 구성 요소가 무료다. 창고에 AI 어시스턴트를 배포하는 기술적 장벽은 "NLP 팀을 고용하라"에서 "소프트웨어를 설치할 수 있는 IT 제너럴리스트"로 떨어졌다.
데이터: 먼저 API 청구서, 다음 로컬 청구서
로컬 배포가 경제적으로 맞는지 판단하려면 장부의 양쪽을 정직하게 계산해야 한다. 전형적인 시나리오를 보자 — RAG 기반 창고 SOP Q&A 어시스턴트로, 질문 하나당 약 3,000개의 입력 토큰(검색된 SOP 청크 포함)과 500개의 출력 토큰을 소비한다. 2026년 10월 기준 벤더의 공개 정가를 사용하면:
- GPT-4o: 100만 토큰당 입력 $2.50 / 출력 $10.00 — 질문당 약 $0.0125
- GPT-4o-mini: 100만 토큰당 $0.15 / $0.60 — 질문당 약 $0.00075
- Claude Sonnet 4: 100만 토큰당 $3.00 / $15.00
- Gemini 2.5 Flash: 100만 토큰당 $0.075 / $0.30
- Qwen3.8-Flash(호스티드): 100만 토큰당 $0.15 / $0.47
로컬 측에서는 2026년 10월 미국 공개 시장 가격으로: 중고 RTX 4090(24GB VRAM)이 약 $2,600–3,000에 거래되며(판매된 eBay 리스팅 중앙값 약 $2,860); 이를 장착할 수 있는 워크스테이션은 약 $1,000–1,500 — 일회성으로 총 약 $4,000이다. 전기료는 미국 상업용 전력을 약 $0.20/kWh로 추산하면: 풀 로드에서 약 450W를 소비하는 카드는 24/7 가동 시 연간 약 $870, 2교대(약 하루 8시간) 가동 시 연간 약 $290가 된다. 소프트웨어 스택 — Ollama, AnythingLLM, 벡터 데이터베이스 — 는 전부 오픈소스이며 무료다.
| API(GPT-4o급) | API(mini/flash급) | 로컬(중고 4090 구성) | |
|---|---|---|---|
| 초기 투자 | $0 | $0 | ~$4,000 |
| 하루 150건 기준 연간 비용 | ~$675 | ~$40 | 전력 ~$290–870 |
| 하루 1,500건 기준 연간 비용 | ~$6,750 | ~$405 | 전력 ~$290–870 |
| 데이터가 건물 밖으로 나가는가 | 예 | 예 | 아니오 |
| 오프라인 동작 | 아니오 | 아니오 | 예 |
회수 계산, 그리고 직관에 반하는 발견
표를 자세히 읽으면 결론은 직관보다 미묘하다. 하루 150건 질문에서는 API가 연간 약 $675인 반면 로컬 전력만 해도 연간 $290–870이며; $4,000의 초기 투자를 상각하면 회수는 10년을 넘어서 — 기계를 24시간 돌리면 회수 자체가 안 될 수도 있다. 여러 교대에 걸쳐 하루 1,500건 질문에서는 API 청구서가 연간 약 $6,750에 달하는 반면 로컬 운영비는 거의 변하지 않아 초기 투자는 약 7~9개월 만에 회수된다.
직관에 반하는 발견은 이것이다: 사용량이 적을수록 로컬 배포는 더 불리해 보인다. 로컬은 고정비의 논리; API는 변동비의 논리다. 대부분의 중소형 창고에게 "질문당 과금"이 더 합리적인 선택이며, "오픈소스는 무료"는 "배포도 무료"를 의미한 적이 없다. 두 번째 발견: 비용은 종종 진짜 의사결정 변수가 아니다. arxindustries 케이스 문서는 주된 동기로 절감이 아니라 데이터 주권을 들고 있다 — 창고 SOP, 고객 SKU 프로파일, 요율 시트는 기밀 요건을 동반하는 경우가 잦아, 아무리 저렴한 API라도 충족할 수 없다. 세 번째 판단: 가중치가 무료라고 청구서가 무료인 것은 아니다. RAG 파이프라인 구축, 문서 수집·정제, 권한 분리, 보안 패치는 지속적인 노동 비용이다; 오픈소스는 "지능 임대료"를 월 구독료에서 초기 엔지니어링과 장기 유지보수로 전환할 뿐이다. 그리고 저렴한 mini/flash급 API는 순수 Q&A에 대한 로컬 배포의 비용 우위를 거의 지워버렸다 — 로컬이 합리적이어려면 세 가지 조건 중 최소 하나는 성립해야 한다: 대량 사용, 민감한 데이터, 또는 오프라인 가동의 필요성.
귀속: 왜 하필 2026년 하반기였는가
왜 지금인가? 네 가지 조건이 2026년 하반기에 동시에 도래했고, 하나하나가 필요했다.
첫째, 라이선스. 2026년 8월 10일, Meta는 Apache 2.0 라이선스로 Muse Glimmer를 출시했다 — 상업적 이용에 진정으로 걱정 없는 최초의 플래그십급 오픈 가중치로, 300억 파라미터다. 그 이전 Llama 패밀리는 커뮤니티 라이선스로 제공되었다: 월간 활성 사용자 7억 명(700 million) 초과의 제품은 별도의 승인이 필요했고, 멀티모달 기능은 EU에서 지역 제한이 있었다 — 신중한 법무팀이 주저하기에 충분했다.
둘째, 능력 밀도. Mixture-of-experts 아키텍처가 "작은 활성화, 큰 지식"을 실용적으로 만들었다: Llama 4 Scout(2025년 4월 5일 출시)는 총 1090억 파라미터 중 170억 활성 파라미터와 1,000만 토큰 컨텍스트 윈도우를 갖추고, 커뮤니티에 의해 Ollama를 통해 12GB VRAM에서 동작하는 것으로 입증되었다; Qwen3.8-27B(2026년 8월 가중치 공개)는 262K 토큰의 네이티브 컨텍스트로 단일 GPU에서 동작한다. 창고 Q&A에 최첨단 모델의 전력이 필요한 것은 아니다 — 필요한 것은 "충분히 좋고, 박스에 들어가는" 것이다.
셋째, 하드웨어. 32GB RTX 5090은 단일 컨슈머 카드가 이전에는 전문가용 가속기가 필요했던 모델을 담을 수 있게 했다 — 다만 2026년 메모리 부족으로 시중 가격은 $3,900–4,400까지 밀렸고(권장 소비자 가격 $1,999 대비), 그 대신 약 $2,600–3,000의 중고 RTX 4090이 가성비 진입점이 되었다.
넷째, 툴링. AnythingLLM과 OpenWebUI 같은 노코드 RAG 플랫폼이 "문서를 넣고 질문 시작"을 몇 분으로 줄여, 창고 IT가 임베딩이나 리랭킹을 몰라도 시스템을 가동할 수 있게 되었다.
2027년을 향하여: 모든 창고가 자체 AI 어시스턴트를 갖게 될까?
내 판단: 아마도 그렇다 — 하지만 "하나의 로컬 모델이 모든 것을 처리한다"는 형태는 아니다. 가능성 높은 형태는 하이브리드 라우팅: 기본은 작은 로컬 모델, 필요시 클라우드 최첨단 모델 — 고빈도 폐쇄 지식 질문(SOP, 장비 매뉴얼, 고객 프로파일)은 한계 비용 거의 0으로 로컬에 머물고 데이터는 결코 건물을 벗어나지 않으며; 복잡한 추론과 실시간 데이터가 필요한 것(요율, 규제 업데이트)은 클라우드로 간다. 근거: 위의 비용 곡선이 각 질문 클래스를 가장 저렴하게 답할 수 있는 곳에 배치하기 때문이다.
시기에 대해, 2026년 하반기는 파일럿의 해이고 2027년이 변곡점이 될 수 있다: Apache 2.0의 플래그십 오픈 모델, 성숙한 원클릭 배포 툴링, 메모리 부족이 진정된다면 GPU 가격 안정이 함께 배포 임계값을 "워크스테이션 한 대"까지 압축한다. 그 지점에서 병목 제약은 기술이 아니라 조직의 준비도가 된다 — 문서가 디지털화되어 있는지, 권한 구조가 명확한지, 누군가 시스템을 유지할 것인지.
경계선은 지금 그어져야 한다. 로컬 모델은 폐쇄 지식 Q&A에 탁월하다; 세 가지에서는 약하다: 실시간 인터넷 접속을 요하는 정보, 매우 긴 추론 사슬에 의존하는 의사결정(네트워크 최적화, 부지 선정), 지식이 계속 최전선을 따라가야 하는 영역이다. 2027년 창고 관리자에게 던져질 질문은 "AI 어시스턴트를 써야 하는가"가 아니라 "어떤 질문에 답하도록 허용하고, 어떤 질문은 인간이나 클라우드 모델로 보내야 하는가"일지 모른다 — 그 라우팅 정책을 설계하는 것 자체가 새로운 관리 규율이 된다.
2027년에 대한 열린 질문
컴퓨팅이 랙킹 같은 고정 자산이 될 때, IT 예산과 운영 예산의 경계는 어디에 있는가? AI는 한때 운영 비용으로 회계 처리되는 월간 서비스 요금이었다; 로컬 배포 이후에는 일회성 자본 지출에 전기를 더한 형태가 된다 — 고정 자산과 에너지 비용이다. 그 회계의 변화는 AI 지출을 누가 승인하고 어떻게 측정하는지를 조용히 바꾼다: "이번 달 토큰에 얼마나 썼는가"에서 "이 기계의 가동률은 얼마인가"로. 2027년의 창고는 기술 선정의 질문보다 예산 소유권의 질문에 먼저 답해야 할지 모른다 — 그리고 그에 대한 표준 답은 아직 존재하지 않는다.
Dr. Chen, 공급망 연구원 지음
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.