창고에서의 연합학습에 대한 불편한 진실부터 말하자. 단일 물류센터에겐 돈 낭비다. 단 한 상황에서만 제값을 한다—데이터를 옮길 수 없는데 모델은 계속 학습해야 할 때. 주문 데이터가 섞이는 것보다 차라리 문을 닫겠다는 클라이언트 여섯 곳의 창고를 운영하는 3PL의 일상 그 자체다.
2023년, 나는 캘리포니아 인랜드 엠파이어의 3PL에서 이런 광경을 목격했다. 창고 네 곳, 핵심 클라이언트 세 곳, 데이터 공유 계약 협상에 허비한 6개월. 단 하나의 모델도 학습되지 않았다. 연합학습이 있었다면 그 반년은 필요 없었을 것이다. 이 글은 이 기술이 실제로 무엇을 하는지, 언제 투자할 가치가 있는지, 추진하면 어떤 장애물에 부딪히는지를 설명한다. 과장은 없다.
모델은 여행하고, 데이터는 집에 남는다.
기존 방식은 모든 창고의 데이터를 하나의 중앙 레이크로 끌어모아 거기서 학습한다. 연합학습은 이를 뒤집는다. 조정 서버가 모델을 배포하면, 각 창고가 자체 데이터로 그 모델을 로컬에서 학습시키고, 돌아오는 것은 모델 업데이트—그래디언트나 가중치—뿐이다. 서버는 모두의 업데이트를 평균내어 새 글로벌 모델을 만들고 사이클을 반복한다. 원시 데이터는 건물 밖을 한 발자국도 나가지 않는다.
이 아이디어는 Google의 McMahan 연구진이 2017년에 발표한 논문 "Communication-Efficient Learning of Deep Networks from Decentralized Data"에서 나왔고, FedAvg 알고리즘을 소개했다. 원래 유스케이스는 스마트폰 키보드 예측이었다—자신이 입력한 모든 걸 업로드하고 싶은 사람은 없지만, 모두가 더 똑똑한 자동 완성을 원한다. 창고도 정확히 같은 문제를 안고 있다. 3PL의 클라이언트 A는 자사 주문 이력이 클라이언트 B의 데이터베이스로 흘러들어가는 걸 절대 용납하지 않는다.
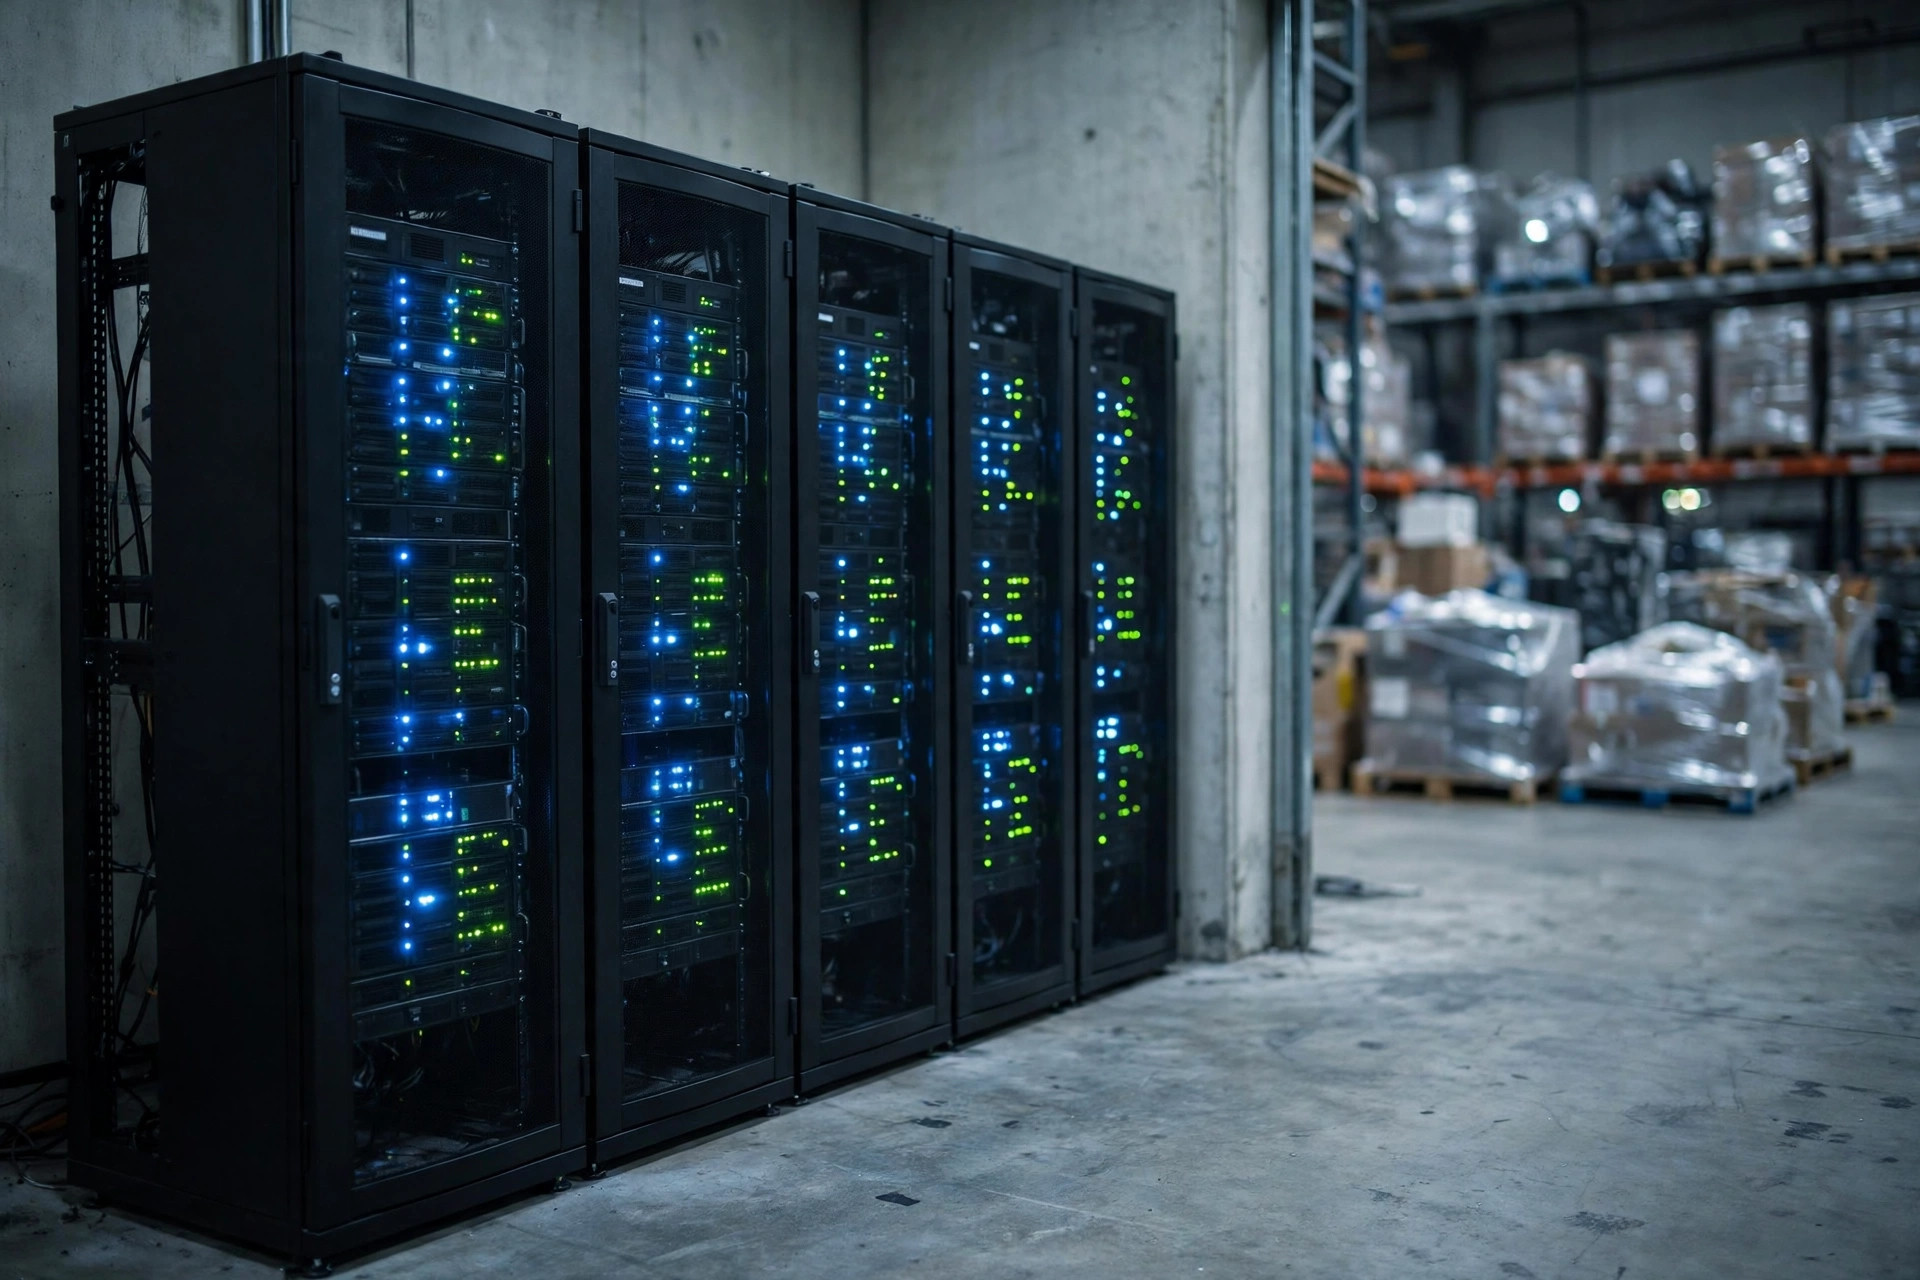
멀티 창고 운영에 적용하면, 각 시설이 "클라이언트" 역할을 하고 3PL 본사나 기업 IT가 조정 서버를 맡는다. 주문, SKU 프로파일, 피킹 속도는 로컬에 남고, 이동하는 것은 모델 파라미터뿐이다. 실무 팁 하나: 로컬 학습엔 로컬 연산 자원이 필요하다. 많은 창고에서 "AI 서버"는 구석에 처박힌 GPU 워크스테이션에 불과하다—소형 모델엔 충분하지만, 제대로 하려면 현장에 적절한 엣지 하드웨어가 필요하다.
투자할 만한 경우—그리고 벤더에게 헌납하는 꼴이 되는 경우
비용을 정당화하는 상황은 세 가지다. 첫째, 합의할 수 없는 복수의 데이터 소유자: 멀티 클라이언트 3PL 창고, 지역별로 분리된 법인, 브랜드 소유자와 위탁 제조업체. 컴플라이언스나 영업비밀이 중앙집중식 학습을 무력화할 때, 다른 모두의 데이터로부터 혜택을 보는 유일한 방법이 연합학습이다. 둘째, 동일한 과제와 상호 보완적 데이터: 모든 사이트가 피킹 이상 탐지나 입고 예측을 하고, 한 곳은 성수기고 다른 곳은 한가할 때—합치면 모델이 단순히 더 넓은 세상을 본 셈이다. 셋째, 법적으로 반출이 안 되는 데이터: 제약, 식품, 고가 상품처럼, 대화가 시작되기도 전에 중앙 레이크가 규제에 막히는 경우.
그리고 손 떼야 할 상황도 세 가지다. 첫째, 모든 데이터를 이미 손에 쥔 단일 창고—중앙화해서 직접 학습하라. 더 빠르고 저렴하다. 거기서 연합학습은 순수 오버헤드다. 둘째, 데이터가 너무 적은 경우: 하루 주문이 수백 건인 사이트는 연합의 통신·관리 비용을 절대 회수하지 못한다. 셋째, 근본적으로 다른 일을 하는 사이트들: 한쪽은 수요 예측, 다른 쪽은 육안 품질 검사. 둘을 하나의 모델에 밀어넣으면 둘 다 나빠진다. 연구자들은 이를 non-IID 문제—독립적이고 동일하게 분포되지 않은 데이터—라 부르고, 수년 전부터 FedAvg의 1번 약점이라고 지적했다. 제품 구성이 크게 다른 창고들을 평균내면, 각 사이트가 따로 학습했을 때보다 못할 수도 있는 모델이 나온다.
판단 기준은 한 문장으로 정리된다. 데이터가 "없으면 안 되고" "움직이지도 않는가"? 그렇다면 연합을 이야기하자. 아니라면 먼저 중앙화하라.
제약 업계는 이미 대규모로 개념을 입증했다. 2019년, 경쟁 관계의 제약사 10곳—Amgen, AstraZeneca, Novartis 등이—MELLODDY 프로젝트를 출범했고, 26억 개가 넘는 실험 데이터 포인트, 2,100만 개 이상의 화합물을 대상으로 연합학습으로 신약 발굴 모델을 학습시켰다(프로젝트 공개 논문 기준). 아무도 자사 데이터를 넘기지 않았다. 원수 같은 경쟁자들도 해냈다면 3PL의 클라이언트들도 이론상 가능하다—하지만 컨소시엄은 플랫폼 구축에 3년을 썼다. 자신의 예산과 인내심을 그 기준에 견줘보라.
시작하기 전에 넘어야 할 세 개의 허들
허들 1: 데이터 정의다. 연합학습은 더러운 데이터를 구해주지 못한다. SKU 코딩 규칙, 주문 상태 정의, 타임스탬프의 시간대—학습 전에 사이트 간에 정렬하라. 내가 본 가장 흔한 실패: 사이트 A에서는 아름답게 학습한 모델이, 사이트 B에서 "피킹 완료"와 "검수 완료"가 같은 필드 값이라는 걸 발견한다. 모델은 쓰레기를 학습한다.
허들 2: 작게 파일럿을 돌려라. 구체적인 과제 하나를 고른다—피킹 이상 탐지, 입고량 예측, 어느 쪽이든 좋다—두 창고에 걸쳐 실행하라. 정확히 이 용도의 오픈소스 프레임워크가 있다. Flower와 NVIDIA FLARE 모두 오픈소스이니, 프로토타입을 세우고 효과를 직접 검증할 수 있다. 파일럿이 입증되기 전에 상용 플랫폼을 사지 마라. 파일럿이 깨끗하게 돈 뒤에 네트워크로 확장하라.
허들 3: 누가 무엇을 결정하는지 문서로 적어라. 모델의 소유자는? 업데이트 주기는? 한 사이트의 형편없는 데이터 품질이 글로벌 모델을 끌어내리면 어떻게 할 것인가? 퇴출 메커니즘은? 기술적 문제는 모두 해결책이 있지만, 사람 문제는 어려운 문제다. 먼저 합의서에 서명하라.
미리 알아둘 만한 함정이 세 개 더 있다. 위에서 다룬 non-IID—먼저 데이터 분포를 프로파일링하고, 사이트들이 너무 분기하면 억지로 하지 마라. 통신과 운영: 매 라운드마다 모델을 동기화하므로 현장 네트워크와 엣지 연산이 따라가야 하고, 소규모 사이트엔 전담 IT가 거의 없다—새벽 2시에 학습 작업이 죽으면 누가 대응할지 미리 정하라. 그리고 보안은 신화화하지 마라. "모델 업데이트만 전송합니다"와 "제로 누출"은 같지 않다. 그래디언트로부터 학습 데이터를 재구성하는 연구는 연구자들이 오래전부터 논의해 왔다. 진짜 민감한 데이터라면, 영업 자료의 "데이터 노출 제로" 주장을 믿지 말고 차등 프라이버시나 보안 집계를 추가하라.
내일 당장 할 수 있는 일
아직 벤더에게 전화하지 마라. 대신 이걸 하라: 연합할 창고들의 표를 만들어라—일일 주문량, SKU 수, 같은 WMS를 쓰는지, 데이터 반출이 허용되는지, 소유자는 누구인지. 그 표가 채워지면, 연합학습이 필요한지 아니면 그냥 데이터를 먼저 중앙화하면 되는지를 알게 된다. 오전 반나절도 안 걸리고, 6개월의 헛걸음을 막을 수 있다.
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.