AI가 다음 주에 몇 명이 필요한지도 모르는데, 스케줄을 맡기시겠습니까?
저는 열 명 이상의 창고 오너에게 이 질문을 던져봤고, 답은 놀랍도록 일관됐습니다. AI는 주문량 예측을 점점 더 잘 맞추지만, 필요 인원 숫자를 뱉어내면 현장 슈퍼바이저는 보기만 해도 고개를 젓습니다. 그 간극이 바로 AI 스케줄링이 지금 서 있는 위치입니다.
AI가 물량 예측을 잘하는 이유
물량은 깨끗한 데이터이기 때문입니다. 과거 주문, 계절성, 프로모션 달력, 심지어 날씨까지——입력값은 구조화되어 있고, WMS에는 수년 치 기록이 쌓여 있습니다. 모델이 학습해야 할 패턴은 비교적 단순합니다. 작년 블랙프라이데이 전 2주 동안 물량이 세 배로 뛰었으니, 올해도 아마 비슷할 겁니다.
작년에 인디애나의 한 이커머스 창고가 물량 예측 도구를 도입하는 걸 봤는데, 성수기 인력 계획 오차가 30~40%에서 10% 약간 위로 줄었습니다. 오너의 말을 그대로 전하면: "내 감보다는 낫다. 적어도 11월에 돼서야 사람이 부족한 걸 알게 되는 일은 없어졌다."
물량 예측은 AI에게 본질적으로 해결된 문제입니다. 남은 건 지능이 아니라 엔지니어링입니다.
인력 생산성 예측이 계속 빗나가는 이유
하지만 "다음 주 주문 80,000건"과 "화요일 아침 조에 47명 필요" 사이에는 늪 하나가 통째로 놓여 있습니다.
생산성은 물량을 인원으로 나눈 게 아닙니다. 같은 80,000건이라도 전부 작은 소포일 때와 절반이 대형 가구일 때 피킹 속도는 천차만별입니다. 신입은 베테랑보다 30% 느린 게 당연합니다. 야간조는 주간조보다 본질적으로 생산성이 낮습니다. 그리고 피크패스 변경 후 2주 동안은 건물 전체의 생산성이 아직 회복 중입니다.
더 큰 문제는, 스케줄링은 수학이 아니라 관리라는 점입니다. AI는 "화요일 아침 47명이 최적"이라고 계산하지만, 정규직은 고정 근무조, 임시직은 48시간 전 통보가 필요하고, 지게차 자격증 보유자는 손에 꼽을 정도입니다. 실제로 인력을 채울 수 없는 최적해는 해가 아닙니다.
그래서 AI 스케줄링의 솔직한 현주소는 이렇습니다. AI가 물량을 예측하고, 사람이 스케줄을 짜고, AI는 기껏해야 참고자료를 냅니다. "원클릭 스케줄링"을 파는 벤더라면 먼저 야간조가 왜 느린지 설명해야 합니다——설명 못 하면 그 원클릭 결과물을 무서워서 쓸 수 없을 겁니다.
생산성 모델링에 진짜 필요한 데이터
"생산성 모델링"은 쉬워 보이지만, 이렇게 물으면 어려워집니다. 데이터는 어디서 오느냐?
세 개의 층이 있습니다, 아래부터. 1층은 주문 데이터——WMS가 가지고 있습니다. 물량, 라인 수, 수량, 중량, 화물 프로파일. 2층은 노동시간 데이터——누가 어느 존에서 얼마나 일했는지. 대부분 창고는 슈퍼바이저의 클립보드로 관리하는데, 입도가 너무 굵습니다. 3층은 동작 데이터——피크패스, 검수 횟수, 예외 처리 시간. 오늘 이 층을 가진 창고는 거의 없습니다.
제 조언은, 욕심내지 마십시오. 2층부터 제대로 잡으세요. 존마다 배지로 출입하고, RF건 로그인을 사람에 묶어, "누가 어디서 얼마나 일했는지"를 정확히 기록하십시오. 그걸 3개월 하면 떳떳한 생산성 베이스라인이 생깁니다. 그 테이블이 있으면 AI 예측에 토대가 있고, 없으면 어떤 소프트웨어를 사도 그림의 떡입니다.
소프트웨어를 사기 전에: 돈 안 드는 세 가지 움직임
첫째, 3년 치 "물량 대 인원 대 잔업"을 하나의 테이블로 뽑아보십시오. 많은 오너가 물량-인원의 상관관계가 맨눈에 보이는 데 놀랍니다. 그 테이블은 AI 벤더와의 협상 무기가 됩니다——모델이 정확하다고 주장하면 그걸로 검증하십시오.
둘째, 존마다 생산성 베이스라인을 잡으십시오. 소수점 정밀도는 필요 없습니다——"피킹은 베테랑이 시간당 120라인, 신입은 80"이면 충분합니다. 베이스라인은 이상을 잡기 위한 것이지 처벌하기 위한 게 아닙니다——아직 급여에 묶지 마십시오. 데이터가 즉시 왜곡됩니다.
셋째, 성수기 회고를 매번 글로 남기십시오. 어느 해 어느 날이 터졌고, 어떻게 사람을 늘렸고, 어디서 사슬이 끊겼는지, 문장으로. 그 전쟁 같은 이야기들은 모델에는 들어가지 않지만, 내년 스케줄 회의에는 들어갑니다. AI는 평균이 특기입니다. 인간은 극단적 상황이 특기입니다——인간이 기억하는 한.
이 중 돈 드는 건 하나도 없지만, 창고를 "감으로 스케줄 짜기"에서 "데이터로 스케줄 짜기"로 움직입니다. 이 단계를 먼저 탄탄히 하면 AI 스케줄링 성공 확률이 두 배 이상이 됩니다.
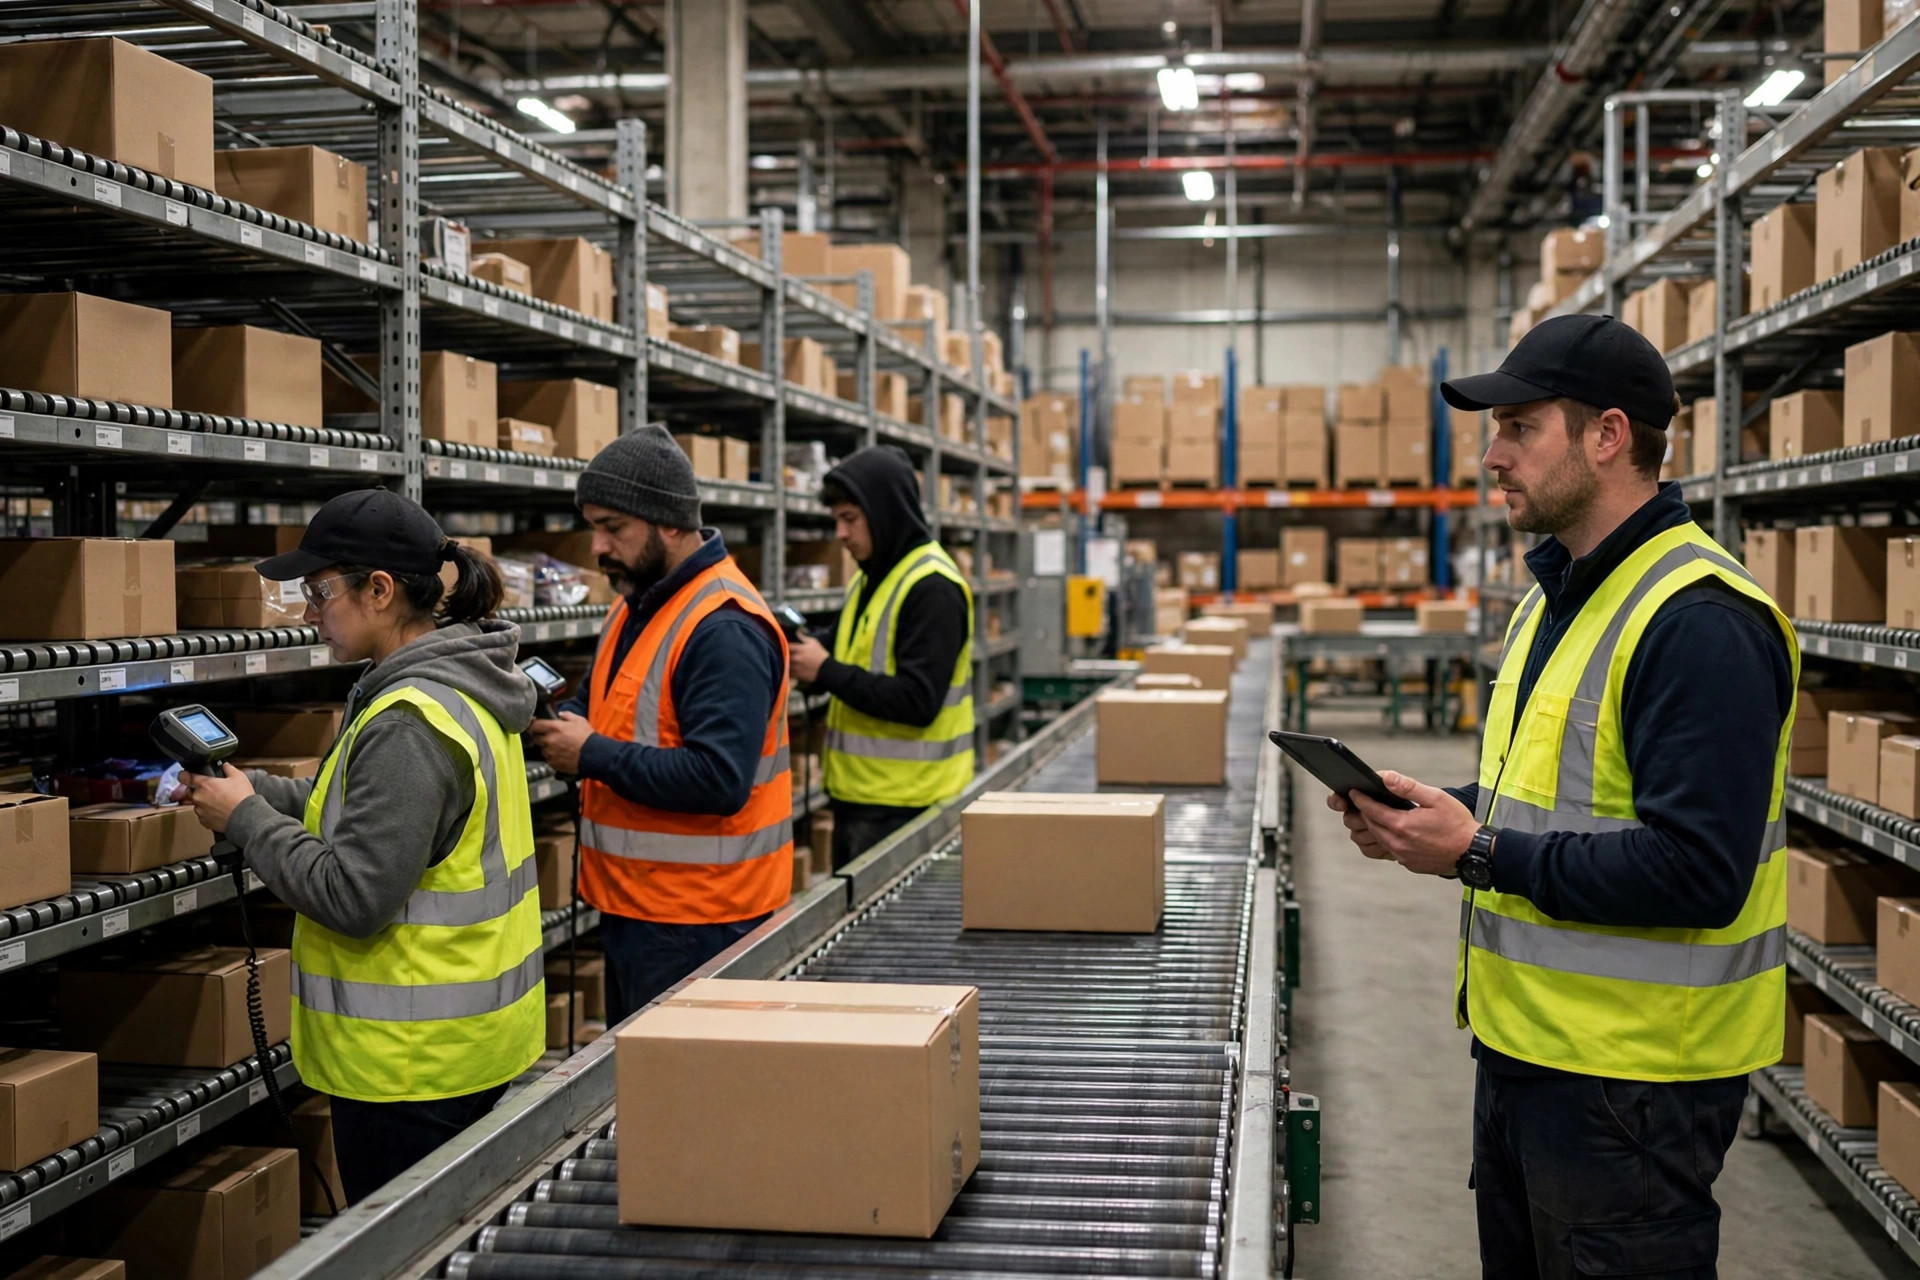
이미 성과를 보고 있는 창고의 모습
여기까지 "아직 이르다"고 했는데, 실제로 돌리고 있는 현장은 있을까요? 저는 중서부의 한 3PL 물류센터를 아는데, 대부분의 현장보다 앞서 있습니다. 그들의 걸음은 연구할 가치가 있습니다——기술이 특이해서가 아니라 순서를 제대로 밟았기 때문입니다.
1년 차: AI 소프트웨어 없음. 일은 하나뿐——"누가 어느 존에서 얼마나 일했는지"를 정확히 기록하기. 200명이 넘는 인원이 존마다 배지로 출입하고, 데이터는 자체 BI로 흘러듭니다. 2년 차: 그 데이터로 물량 대 노동수요 테이블을 만들고, 스케줄 회의는 감에서 테이블 읽기로 바뀌었습니다. 3년 차: 드디어 외부 예측 도구를 도입——물량 예측에만 쓰고, 생산성은 자체 베이스라인으로 봤습니다.
3년이 지난 지금, 성수기 임시직 채용은 5분의 1 줄었습니다——일하는 사람이 줄어서가 아니라 채용을 잘하게 된 겁니다. 2주 전에 부족분이 보이는 거죠. 그게 데이터 자산의 복리입니다. 기록을 일찍 시작할수록 회수도 빨라집니다.
순서에 주목하십시오. 데이터가 먼저, 비교 테이블이 다음, AI가 마지막. 이 앞의 둘을 건너뛰고 AI로 직행한 현장은, 제가 본 한 전원 뒤집혔습니다. 기술이 실패한 게 아닙니다——기초 공사를 안 했던 겁니다.
이 여정은 얼마나 남았나
제 전망은 이렇습니다. 1~2년 안에 물량 예측은 창고 소프트웨어의 표준 기능이 됩니다——따로 살 가치가 없습니다. 진짜 격전지는 생산성 모델링입니다. 조별, 존별, 화물유형별 생산성을 데이터 자산으로 바꾼 창고가 먼저 수익을 가져갑니다.
완전 자동 스케줄링은 3~5년 뒤로 보고, 처음 실현되는 건 노동 구조가 단순한 창고뿐입니다——전원 시급제, 유연한 근무조, 균일한 화물 프로파일. 근무조 규칙이 복잡하고 베테랑이 많은 건물에서는 AI가 아무리 정확해져도 스케줄 최종 사인은 인간이 계속 할 겁니다——스케줄은 숫자가 아니라 사람의 것이니까요.
기술은 먼저 "정확히 계산하기"를 풀고, 다음으로 "돌아가는 근무표를 만들기"를 풀고, 마지막으로 "모두가 납득하게 하기"를 풉니다. 이 순서는 서두를 수 없습니다.
여러분의 창고는 그 여정에서 어디쯤에 있습니까?
영어판 번역본입니다. 내용이 다를 경우 영어판을 우선합니다.